使用 MoE Router 实现 Decoder-Only 模型的跨语言对齐
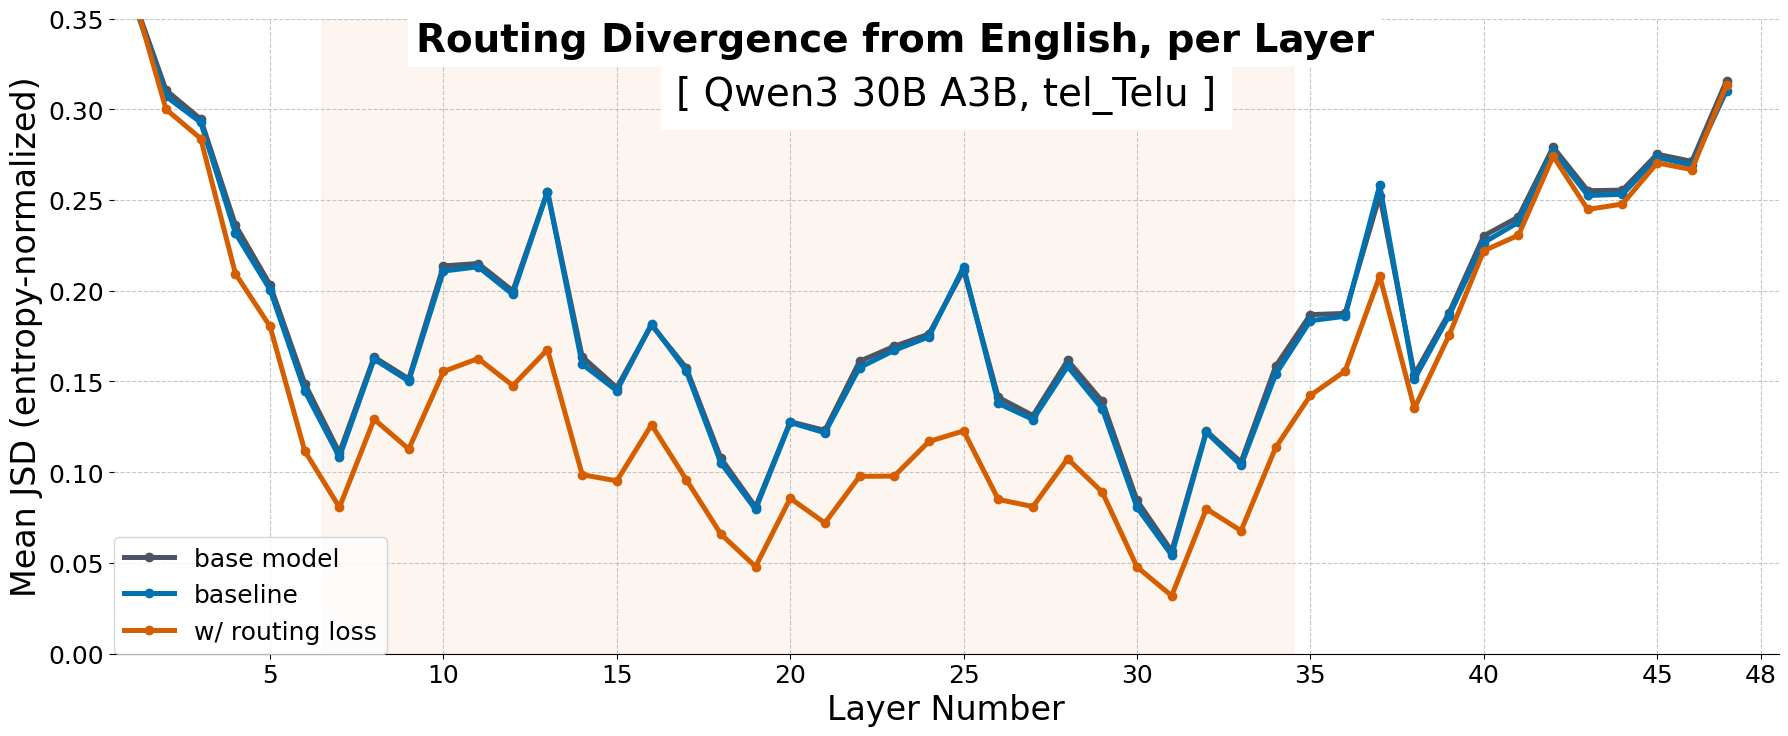
跨语言对比学习 一直是多语言 encoder 训练的核心组成部分,但由于多语言分词方式各不相同,decoder-only LLM 无法显式对齐表示。不过,越来越多研究表明,即便在 LLM 中,更高的跨语言表示对齐度也能带来更好的跨语言迁移能力。 本文提出一种新方法,在现代 LLM 的架构约束下重新构想跨语言对比学习。作者不在 hidden states 上施加辅助对齐损失,而是以 mixture-of-experts(MoE)router 的输出作为对齐目标。Router 输出更适合在大量 token 上做 pooling,从而支持更可靠的 sequence-level 跨语言比较。 作者在四个开源 MoE 上开展了受控的 continual pre-training 实验,结果显示引入该 routing loss 也能让底层 hidden representations 跨语言对齐。更重要的是,该损失在多样化的评测套件上提升了多语言性能,展示了跨语言 MoE router 对齐 的潜力。
论文精读
TL;DR 本文针对 decoder-only LLM 中因 tokenization 差异难以直接做跨语言对比学习的问题,提出用 MoE router 输出作为对齐目标,实现序列级跨语言对齐,实验表明该方法能同时对齐底层表示并提升多语言任务表现。
问题
问题背景
多语言 LLM 的一个核心目标是实现 跨语言迁移(cross-lingual transfer):模型在资源丰富语言上学到的能力,能泛化到低资源语言。当前研究关注如何提升内部表示的跨语言对齐度,因为已有证据表明更高的表示对齐与更好的迁移效果相关。
现有方法局限
传统的 跨语言对比学习(cross-lingual contrastive learning)主要针对 encoder 模型设计,通过拉近平行句对的隐藏状态来显式对齐表示。但在 decoder-only LLM 中,该方法难以直接复用:
- 不同语言的 tokenizer 切分不一致,导致 token 序列无法一一对应,难以做 token 级对齐;
- 直接对隐藏状态施加辅助对齐损失,需要选择中间层并做池化,但平均池化会混合语义与语法信息,且可能干扰自回归训练的动态;
- 已有尝试在 LLM 上应用对比损失,要么效果不稳定,要么需要大量平行语料,工程代价高。
为什么这个问题难且重要
难点在于 decoder-only 架构本身缺乏天然的句子级表示(不像 encoder 有 [CLS] token),而 tokenizer 差异使得基于 token 的对齐策略失效。同时,MoE 架构的引入提供了新的可能:router 输出本质上是每个 token 对专家的权重分布,天然包含语义信息,且更容易做跨 token 池化(如均值),从而获得稳定的序列级表示。业界对多语言能力的关注持续升温,尤其是在 MoE 成为主流高效架构之后,如何在不大幅增加训练成本的前提下提升跨语言迁移,是一个兼具学术与工程价值的问题。
行业类比
类似在多语言客服系统中,不同语言的用户查询需要被映射到统一的意图空间,才能共享同一套下游策略;如果内部表示不对齐,每个语言都需要单独优化,成本线性增长。
核心洞察
- 将 **MoE 路由器** 的输出作为跨语言对齐目标,解决了 decoder-only LLM 中因多语言 token 化差异导致 hidden states 难以池化对齐的问题。与直接在 hidden states 上施加辅助损失的做法相比,router outputs 具有固定维度,可对 token 序列进行平均池化,从而在 sequence-level 进行稳定的跨语言对比。该方法利用现有稀疏 MoE 结构,不引入额外参数,在控制实验中证明路由对齐能间接提升 hidden representations 的跨语言对齐度,为多语言 LLM 的后训练对齐提供了低成本的可行路径。
- 本文揭示 **MoE 路由器** 可视为跨语言共享的任务分解表征,对齐路由概率分布即对齐不同语言间的专家选择模式,进而促进深层表示对齐。不同于 encoder 模型中的表示对齐或 LLM 中直接对 hidden states 加损失,此工作在 decoder-only 架构中直接利用 router outputs 作为对比学习目标,避免了 tokenizer 差异对序列表示的影响。实验表明,路由对齐不仅提升下游多语言性能,还间接对齐了中间层 hidden states,说明 routing 信号可作为跨语言迁移的有效代理,对已有 MoE 模型的持续预训练具有工程参考价值。
方法
方法概览
本文提出一种在 decoder-only MoE LLM 中实现跨语言表示对齐的新思路:不再对隐藏状态施加对比损失,而是将 MoE router 输出作为对齐对象。
输入:大规模平行语料(多语言句子对),以及一个预训练的 MoE LLM。
关键模块:
- 中间层选择:根据实验发现,在模型的若干中间层(例如第 8、16、24 层等)提取 router 输出最有利于跨语言对齐,因为浅层过于词法化、深层过于任务特化。
- Router 输出与序列表示:对每个 token,其 router 输出是一个在各专家上的概率分布(softmax 后的向量),这些向量天然适合序列级 pooling。方法对平行句对两侧分别进行 mean-pooling(或其他 pooling)得到句子级别的 router 表示。
- 对比损失:采用类似 InfoNCE 的跨语言对比目标,拉近平行句子对的表示,推远同一 batch 内非平行句对。该损失作为辅助项与语言建模损失相加,进行 controlled continual pre-training。
- Packing optimizations:为提高训练效率,将多个平行句对打包到同一序列中,利用因果注意力 mask 避免跨句信息泄漏。
输出:一个在 router 层面具备更强跨语言对齐能力的 MoE 模型,同时实验显示其隐藏状态表示也间接对齐,并在多语言下游任务上性能提升。
作者强调:router 输出比原始 hidden state 更容易 pooling,且与 tokenization 差异的耦合更小。
差异点:与传统多语言编码器对比学习直接操作 hidden states 不同,本方法利用 MoE 路由器输出作为对齐信号,既规避了 tokenization 不对齐问题,又避免对隐藏状态施加可能干扰语言建模的强约束。
实验
实验设计
本文在四个开源 MoE 模型上进行受控持续预训练,对比三种设置:
- 基线:不添加任何辅助对齐损失。
- 路由器对齐:使用 MoE 路由器输出作为对齐目标,将所选中间层的路由器输出进行序列级池化,并对平行语料中的句子对施加对比损失。
- 隐藏状态均值池化:直接对隐藏状态做均值池化后应用相同对比损失,作为对照。
训练数据为多语言平行语料,评估采用多样化多语言基准。
关键发现
- 路由器输出更适合对齐:相比隐藏状态,路由器输出维度更低且语义更聚焦,池化后能产生更可靠的序列级表示,跨语言对比更稳定。
- 表示对齐显著改善:引入路由对齐损失不仅对齐了路由器输出,还促使底层隐藏表示跨语言对齐,说明该损失具有间接正则化效果。
- 多语言性能提升:在多个多语言任务上,路由器对齐方法优于基线,证明显式跨语言对齐在 decoder-only MoE 架构中依然有效。
与基线对比的深度解读
- 对比隐藏状态均值池化:路由器输出天然适合池化,避免了隐藏状态中 token 级差异带来的噪声,因此对齐质量更高,训练也更稳定。
- 对比无对齐基线:路由器对齐在多语言评估中取得一致提升,表明即使现代 LLM 已经通过预训练获得一定跨语言能力,显式对齐仍能带来增益。
- 工程启示:该方法无需改动 tokenizer 或增加额外参数,只需在 MoE 路由器输出上添加辅助损失,易于集成到现有持续预训练流程中。
行业影响
落地场景
该方法适用于基于 MoE 架构 的跨语言大模型服务,例如多语言客服机器人、跨境电商内容生成、全球社交媒体内容审核与推荐。通过将路由输出作为对齐目标,可在持续预训练或微调阶段提升模型对低资源语言的理解与生成能力,而不改动推理架构。对于已部署 Mixtral、Grok 等开源 MoE 模型的企业,可以直接复用现有训练管线,增强多语言下游任务性能。
商业价值
- 降低多语言模型训练成本:无需为每种语言单独微调,一个模型即可覆盖更多语言,减少维护多个语言模型的人力与算力开销。
- 提升长尾语言用户体验:在客服、内容本地化场景中,低资源语言性能的提升能直接扩大可服务市场,减少因语言支持不足导致的用户流失。
- 改善跨语言迁移效率:对于需要快速扩展到新语言的产品,该方法可通过平行数据实现有效对齐,缩短上线周期。
与现有工作流的接口
- 损失函数作为 辅助损失 加入现有训练目标,仅需访问 MoE 路由输出,无需修改模型推理架构,便于集成。
- 训练数据需要 平行语料,但论文使用序列级对比,不需要精细的 token 级对齐,降低数据准备门槛。
- 可在 持续预训练 阶段注入,之后继续常规 SFT 或 RLHF,不影响已有下游任务适配流程。
- 建议在训练监控中增加 路由分布一致性指标,评估跨语言对齐效果。
具体用例
- 跨境电商内容生成:平台使用 MoE 大模型自动生成多语言商品描述,通过对齐损失提升小语种描述质量,从而增加非英语市场的转化率。
- 全球 AI 客服:SaaS 企业服务商训练一个多语言客服 MoE 模型,加入路由对齐损失后,模型在客户用母语提问时能更准确理解意图并给出恰当回复,降低对人工翻译的依赖。
局限
- **依赖平行数据与训练成本**:该方法采用对比学习,需要大规模跨语言平行语料进行持续预训练。然而,高质量平行语料在低资源语言对中极度稀缺,限制了其在更多语言上的扩展。同时,在四个开源 MoE 模型上做持续预训练需要可观的计算资源,实际落地时可能面临成本压力。与仅微调对齐头或适配器的方法相比,其训练开销更大。
- **无负样本导致表征退化风险**:损失函数仅拉近正样本(平行句对)的路由输出,没有使用负样本推开不相关表示。这种只优化正样本的方式可能导致模型将所有句子的路由输出映射到相近区域,降低表示空间的区分度,甚至引起维度坍缩。传统对比学习(如 InfoNCE)通常依赖负样本维持表征多样性,该方法的简化设计可能影响对齐效果的长程稳定性。
- **仅适用于 MoE 架构且对齐层选择有限**:该方法的核心依赖 MoE 路由器的输出,对密集 Transformer 模型无效,应用面较窄。此外,论文只选择中间层的 router 进行对齐(具体层选择见论文),可能忽略其他层中的跨语言信息,导致对齐不充分。与直接在隐藏状态上施加辅助损失的方法相比,该方法虽避免了 tokenization 不一致问题,但牺牲了对非 MoE 架构的普适性。