学习用于神经网络压缩的功能性子空间
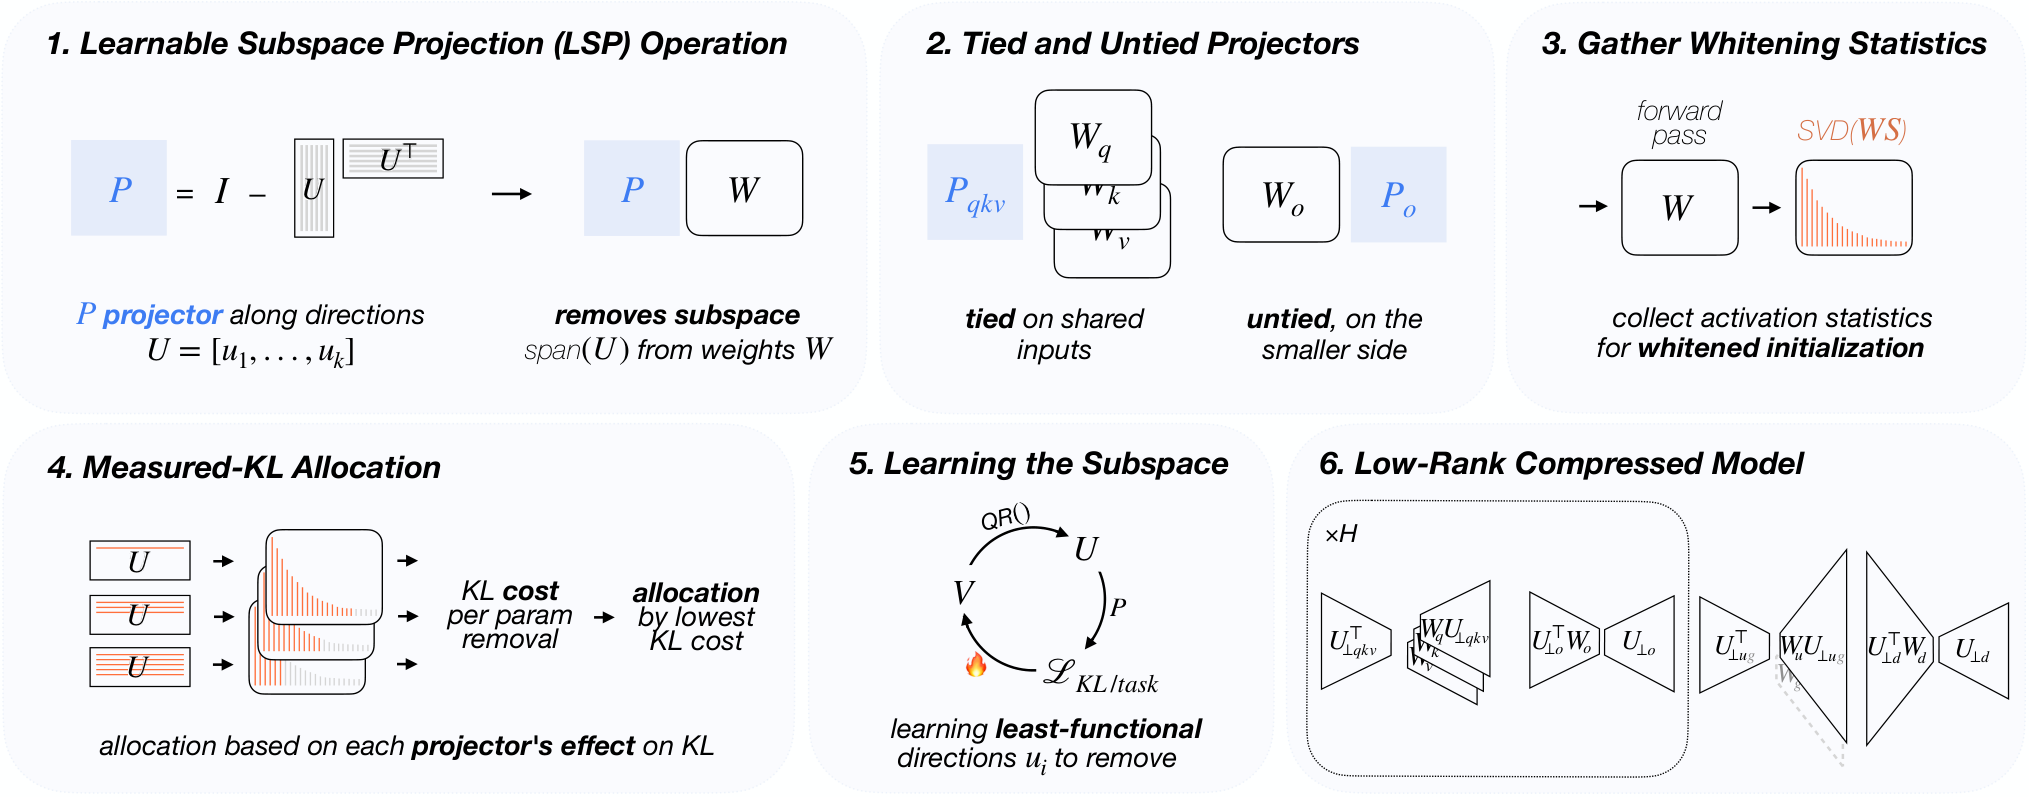
现代 transformer 能力出众,但内存与算力开销同样庞大。低秩权重分解能在保持矩阵稠密的前提下同时降低二者,因而在标准硬件上高效。然而现有方法用局部闭式准则来决定从每个权重矩阵中移除哪些子空间:激活能量、逐层重建误差 或损失的二次近似。这些准则忽略了误差如何在网络中传播,导致高压缩率下误差随深度累积、性能崩塌。 我们提出 Learnable Subspace Projections (LSP),改为端到端地学习应当丢弃的子空间。每个线性层,或读取相同激活的绑定层组,都被分配一个正交投影器。所有投影器针对全局目标联合优化——与稠密模型输出分布的 KL 散度,或模型原始训练损失——同时预训练权重保持冻结。投影器由白化 SVD 截断初始化,秩按每个投影器每节省一个参数所诱导的输出 KL 分配。训练完成后,投影器合并为标准低秩因子,每个绑定组共享同一因子。在 attention 中,这还让模型能缓存一个窄隐变量,以替代完整的 keys 与 values。 在 LLMs(OPT-125M/1.3B、Qwen3-4B、Llama-2-7B)与 ViT-B/16 上,LSP 均优于基线,且优势随压缩率提高而扩大。在 -70% 压缩率下,LSP 把 Llama-2-7B 带到 10.9 的 WikiText-2 perplexity 与 42.2% 的平均零样本准确率,而最强基线仅为 13.3 与 36.0%。分解后的模型在小 batch size 下解码比稠密模型快至多 1.6x;缓存共享隐变量后,在 128k token 上下文下权重与 KV cache 的总内存缩小 13.5x,而未绑定的基线分解至多为 6.5x。
论文精读
TL;DR **LSP** 为每个线性层学习可丢弃的低秩子空间,用全局 KL 或训练损失端到端优化正交投影器,冻结预训练权重,在高压缩比下显著超越基于局部准则的现有方法。
问题
问题背景
神经网络压缩 领域长期关注如何在保持模型性能的同时降低内存与计算需求,低秩权重分解因能保持矩阵稠密、硬件友好而成为主流方案。
现有方法局限
现有低秩压缩方法(如 SVD 截断、ASVD 等)通常基于局部准则选择要移除的子空间:
- 激活能量:仅保留激活值能量大的奇异方向
- 逐层重构误差:最小化每层输入输出重构损失
- 损失二次近似:用 Fisher 信息矩阵等近似损失变化
这些准则忽略误差在网络中的传播,各层独立压缩,导致误差随深度累积。论文指出:
At high compression the errors compound with depth and performance collapses.
即高压缩率下,局部最优的叠加不等于全局最优,最终输出分布严重偏离稠密模型。
为什么这个问题难/重要
核心挑战在于:子空间选择本质是全局组合优化 问题,需要同时考虑不同层的秩分配和方向取舍;而端到端学习投影器必须保持预训练权重冻结,避免灾难性遗忘或过拟合校准数据。此外,压缩后的模型还需保持输出分布与原始模型一致,这对下游任务(如生成、分类)至关重要。业界大模型部署中,这种全局感知的压缩方法能够显著延展性能-压缩比边界,因此受到广泛关注。
行业类比
与 LoRA 微调共享类似逻辑:与其在每层单独调整权重,不如学习一组全局协调的低维适配参数,用更少的可学习参数撬动整体行为——LSP 正是把这种思想应用到压缩投影上。
核心洞察
- LSP 的核心创新在于把子空间选择从局部闭式准则转变为端到端可学习的全局优化。现有低秩分解方法(如激活能量、逐层重构误差、损失二次近似)在每个权重矩阵上独立决定要移除的子空间,忽略了误差在网络深度上的累积效应,导致高压缩率下性能快速坍塌。LSP 为每个线性层(或共享激活的 tied group)分配正交投影器,通过优化与稠密模型输出分布的 KL 散度或原始训练损失联合训练所有投影器,冻结预训练权重,从而显式建模跨层误差传播。这一全局视角使模型在 -70% 压缩下仍保持较强性能,与最强 baseline 的差距随压缩率增大而扩大。
- LSP 利用 tied group 共享一个低秩因子,在注意力机制中实现对 KV cache 的结构化压缩。传统低秩分解通常为每个权重矩阵独立生成因子,无法直接压缩注意力中的键值缓存,且无法跨层共享表示。LSP 将读取相同激活的层(如多头注意力中的 Q/K/V 投影)绑定为 tied group,训练后合并为共享因子的标准低秩形式,使模型能够缓存一个窄潜在表示替代完整的 keys 和 values。这一设计不仅减少权重参数量,还显著降低长上下文推理时的内存占用:在 128k token 上下文下,权重与 KV cache 合并内存缩小 13.5 倍,而 untied baseline 最多 6.5 倍,且小批量解码速度提升 1.6 倍。
方法
输入与初始化
LSP 的输入是一个预训练好的稠密 Transformer 模型,以及一组目标压缩率。对每个线性层(或读取相同激活的绑定层组),初始化一个正交投影器 P_r。初始化来自白化 SVD 截断:先对激活协方差做白化,再对白化后的权重做 SVD,保留顶部奇异向量作为投影子空间的基,这样能更好地保留信号能量。
关键模块
- 联合优化投影器
所有投影器P_r被端到端联合优化,而预训练权重保持冻结。优化目标为两个选项之一:- KL 散度到稠密模型输出分布:最小化压缩模型与原始模型在每个 token 预测分布上的 KL 散度,属于蒸馏式目标。
- 原始训练损失:直接在原任务损失上优化投影器,不依赖稠密模型前向。
- 秩分配
在优化前,通过测量每个投影器引起的输出 KL 每参数节省来分配秩。对每个候选投影器,单独测其低秩截断带来的 KL 增量,除以节省的参数量,按该比率分配总秩预算,使压缩资源集中在输出敏感的层。 - 绑定与共享
对读取相同激活的层(如 attention 中 Q/K/V 投影,或 MLP 中不同专家的并列层),强制共享同一个投影器,从而减少存储并允许后续共享分解因子。
输出与合并
优化完成后,每个正交投影器被分解为标准低秩因子 U Σ V^T,与原权重合并成两个小矩阵的乘积。绑定组共享其中一个因子。在 attention 中,这允许仅缓存一个窄的共享潜在表示,替代完整的 K/V 缓存,显著降低 KV 缓存内存。
与同类方法的差异
不同于基于局部闭式准则(激活能量、逐层重构误差、损失二次近似)的 ASVD / FWSVD / SVD-LLM 等方法,LSP 通过全局目标端到端学习丢弃的子空间,显式建模误差跨层传播,因此在高压缩率下不会因误差累积而性能崩溃。
实验
实验设计
- 在 LLMs(
OPT-125M/1.3B、Qwen3-4B、Llama-2-7B)和 ViT-B/16 上评估 LSP。 - 对比基线包括基于 激活能量、逐层重建误差 和 损失二次近似 的局部闭式低秩分解方法。
- 优化目标为端到端 KL 散度或原始训练损失,权重冻结;秩分配按每个投影器带来的输出 KL 除以节省参数量。
关键发现
- 在 -70% 压缩下,
Llama-2-7B达到 WikiText-2 PPL 10.9、平均零样本准确率 42.2%,优于最强基线(13.3 / 36.0%)。 - 小 batch 解码速度相对稠密模型提升 1.6x;128k token 上下文下,权重+KV cache 总内存缩减 13.5x,而 untied 基线最多 6.5x。
与基线对比解读
局部判据只考虑单层误差,高压缩时误差随深度累积导致性能崩溃;LSP 通过全局目标学习要丢弃的子空间,显著缓解该问题。共享投影器使 attention 中可用一个窄 latent 替代完整 KV,带来更优压缩-效率权衡。工程上可合并为标准低秩因子,保持稠密矩阵硬件效率。
行业影响
落地场景
LSP 适用于 Transformer 模型的低秩压缩,尤其适合对内存和计算敏感的场景:
- LLM 推理服务:长上下文(128k token)下,共享潜变量可将权重+KV cache 内存减少至 13.5 倍,支持更高并发。
- 边缘/端侧部署:视觉模型(如 ViT-B/16)压缩后可运行于移动端或嵌入式设备,用于实时图像处理。
- 内容平台:视频审核、标签生成等任务中压缩多模态模型,降低 GPU 成本。
商业价值
LSP 直接降低推理成本:小 batch 解码速度提升 1.6 倍,内存占用大幅下降,可减少云 GPU 实例或延长端侧电池寿命。在高压缩率(-70%)下,Llama-2-7B 仍保持 10.9 的 WikiText-2 困惑度(对比最强基线 13.3),显著减少压缩带来的精度损失,避免重新训练。用户获得更低的延迟和更高的吞吐,长上下文能力提升体验。
与现有工作流集成
LSP 训练后输出标准低秩权重(两个小矩阵),直接替换原线性层,兼容 PyTorch、ONNX Runtime、TensorRT 等框架,无需自定义 kernel。可与量化、蒸馏叠加。集成步骤:
- 加载预训练模型,冻结权重。
- 插入正交投影器,用 KL 散度或原训练损失端到端优化。
- 合并投影器为低秩因子,导出模型。
具体 use case:电商推荐系统中商品描述生成,压缩 LLM 后部署在 CPU 或低端 GPU,降低单次推理成本,支持高并发;医疗影像分析,压缩 ViT 后嵌入便携设备,实时检测病灶,避免数据上传造成隐私风险。
局限
- **训练开销显著增加**:LSP 需要额外的端到端训练阶段来优化所有投影器,尽管冻结原始权重,但相比 SVD、ASVD 等一次性闭式分解方法,压缩过程需要多次前向/反向传播和精心挑选的校准数据集。论文的 Compression Cost 部分可能显示训练时间远高于基线,这对超大模型(如 7B 参数)的快速部署构成障碍,尤其在资源受限或需要频繁重新压缩的场景下,训练成本可能抵消压缩带来的收益。
- **适用范围受限**:方法聚焦于线性层的低秩分解,对于包含复杂非线性结构(如卷积、自注意力中的 softmax 等)的模块未做处理;实验仅在 Transformer 架构(LLM 和 ViT)上验证,对 CNN、MLP-Mixer 等通用架构的泛化能力未知。此外,秩分配和投影器初始化依赖 whitened SVD,对初始化质量和秩分布较为敏感,在不同模型上可能需要重新调整超参数,增加了实际应用的调参负担。
- **推理加速的硬件依赖性**:论文展示小 batch size 下 1.6× 解码加速,但低秩分解引入两个较小的矩阵乘法,在大 batch 或某些加速器上可能由于 kernel launch 开销或内存带宽限制导致加速有限,甚至不如密集层。同时,注意力中共享潜在表示虽然降低了 KV 缓存,但需要修改 attention 实现,可能带来工程复杂度和数值稳定性问题,对长序列生成的精度影响尚需进一步评估。