EgoTools:迈向真实世界第一人称视频中的工具中心推理
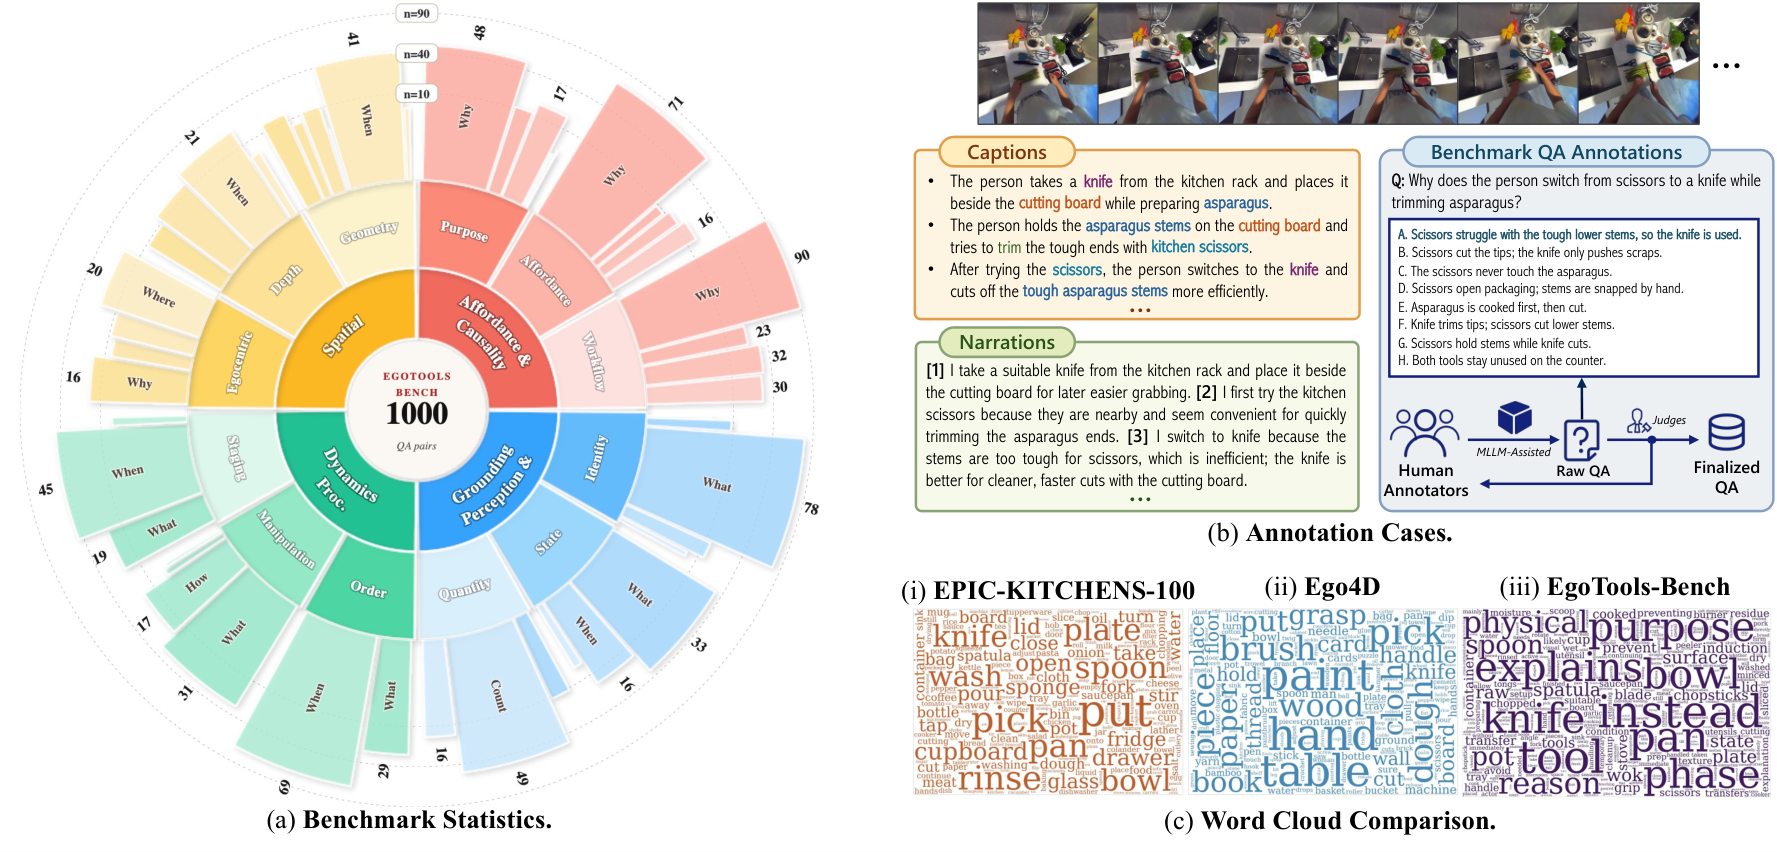
真实世界的具身任务——从日常活动到专业流程——都要求 agent 在物理约束下行动,同时追踪不断演化的物体状态与任务状态。工具使用处于这类任务的核心,因为许多日常与专业活动都以工具为中介。理解它们需要推理可供性(affordance)、手-工具-物体几何、流程进展以及对目标物体的因果效应。然而,尽管当前多模态视频模型在 captioning、通用 video QA 等偏感知的任务上表现强劲,在工具中心具身推理 上仍明显受限,瓶颈在于缺少真实第一人称数据与诊断基准。 为填补这一空白,本文提出首个面向第一人称工具使用理解的综合套件 EgoTools,由两个互补组件构成: - EgoTools-Data 是大规模语料,包含 100 小时工具中心的第一人称录制,配合同步音频、密集字幕、重推理旁白以及补充 3D 信息。 - EgoTools-Bench 是诊断基准,含 1,000 组 QA,覆盖四个 track,从感知与几何延伸到流程推理与因果推理。 实验显示,现有模型仍难以把工具使用落实到视觉证据上:Gemini-3.1-Pro 总体准确率为 66.9%,但在 Perception & Grounding 上仅 51.7%。作者进一步验证了 EgoTools-Data 的训练价值:在完整 1,000 题基准上,严格源视频分离下,全监督微调将 Qwen3-VL-8B-Instruct 从 50.0% 提升至 60.9%。这些结果确立了 EgoTools 作为真实世界第一人称工具使用理解训练与诊断评估统一资源的地位。
论文精读
TL;DR EgoTools 推出首个面向真实世界第一人称工具使用理解的数据集与基准,实验揭示现有视频模型在工具中心推理上仍有明显差距,并验证其作为训练资源可显著提升性能。
问题
当前多模态视频理解正从感知描述向具身推理 迁移,重点关注第一视角视频中的工具使用与操作理解。
现有方法主要依赖通用视频 QA 数据训练,虽在 EgoSchema 等感知型基准上表现较好,但缺乏真实工具中心的第一视角数据与诊断基准。模型难以从视觉证据中提取手-工具-物体几何关系、affordance、操作时序与因果效应,且现有基准常存在语言先验捷径,无法区分模型是真正 grounding 还是靠字幕关键词猜测。
工具使用推理的难点在于:需要同步对齐多模态信号(视频、音频、密集字幕、3D 信息)并捕捉长程程序状态变化,而真实场景中的遮挡、视角变化和细粒度手部动作进一步增加标注与评估成本。业界对具身智能和机器人操作模型的投入持续升温,但缺少像 EgoTools 这样覆盖感知、几何、程序与因果四轨道的统一诊断资源,直接阻碍了从能描述视频 到 能推理操作因果链 的跨越。
这类似于自动驾驶领域依赖 nuScenes 的多任务诊断来推进感知-规划闭环,工具中心推理也需要专项基准才能倒逼模型能力的真实提升。
核心洞察
- EgoTools 是首个专门针对真实世界 egocentric 工具使用理解的训练数据+诊断基准套件,整合了 100 小时多模态数据(音频、3D 注释、推理叙述)和 1000 个 QA 对,覆盖感知、几何、程序和因果推理四个维度。这区别于以往 egocentric 基准多集中于通用视频理解或规划任务,缺少对工具使用中手-物几何、因果链的细粒度诊断,从而填补了具身 AI 领域关键数据空白。
- 实验结果揭示大型多模态模型在工具相关感知与接地上的显著短板(Gemini-3.1-Pro 总准确率 66.9%,但在 Perception & Grounding 仅 51.7%),且模型变体的 track-wise 优势不同,说明单纯增大模型规模或输入帧数无法弥补这一差距。同时,EgoTools-Data 作为训练数据能将 Qwen3-VL-8B-Instruct 从 50.0% 提升至 60.9%(严格跨源视频分离),证明了该数据对提升工具中心推理的训练有效性,为后续模型改进提供了明确的监督信号。
- EgoTools-Bench 的设计强调诊断性和证据分离,通过多帧覆盖、时间顺序、隐式工具使用问题等测试,发现现有模型严重依赖语言先验而非真实视觉证据,且不同模型共享失败模式。这种细粒度错误分析能力是现有 egocentric 基准所缺乏的,它使研究者能够定位具体能力瓶颈(如视觉接地不足或过程推理错误),而非仅获得总体准确率,对指导具身智能体的训练和评估具有直接工程价值。
方法
整体流程
EgoTools 方法围绕“原始自我中心视频 → 工具中心多模态对齐 → 诊断基准”构建。
输入:采集的真实世界自我中心视频,分为结构化任务引导与开放参与者驱动两类,覆盖多种工具使用场景。
关键模块:
- 数据收集与预处理:对原始视频执行视角校正(canonical view),并按源视频划分训练/测试,避免泄漏;同步音频与 3D 传感器信息。
- 多模态注释与策展:提供密集字幕、推理重型叙述(reasoning-heavy narrations),并补充 3D 注释(如手物几何、物体姿态),将感知证据与语言推理分离。
- 视频指令微调数据构建:基于注释生成工具中心的指令-响应对,用于监督微调(SFT)。
- 基准构建与质量控制:从数据中抽取并生成 1000 道 QA 对,分为四个轨道(感知与接地、几何、程序、因果推理),采用八选项归一化与反捷径检查,确保答案需要视觉证据而非语言先验。
输出:EgoTools-Data(100 小时训练语料)和 EgoTools-Bench(诊断基准),构成统一资源。
训练验证:对 Qwen3-VL-8B-Instruct 全量 SFT,在严格源视频分离下将基准得分从 50.0% 提升至 60.9%。
差异点:与 EgoSchema、EgoPlan 等感知或规划导向的基准不同,EgoTools 首次将工具中心具身推理系统化为训练与诊断的统一框架,强调 affordance、物理约束与因果效果。
实验
实验设计
EgoTools-Bench 包含 1,000 道选择题,覆盖 Perception & Grounding、Geometry、Procedure、Causal Reasoning 四个 track。评估对象包括 Gemini-3.1-Pro 等多个现有多模态视频模型,并在 EgoTools-Data 上对 Qwen3-VL-8B-Instruct 进行全量 SFT 后重新测试;同时在 EgoSchema、EgoPlan、EgoThink 上验证零样本迁移。
关键发现
- Gemini-3.1-Pro 总分 66.9%,但 Perception & Grounding 仅 51.7%,表明视觉接地是明显短板。
- 利用 EgoTools-Data 微调后,Qwen3-VL-8B-Instruct 从 50.0% 提升至 60.9%,严格源视频分离下仍有效。
- 消融表明模型不能仅靠语言先验,需要多帧覆盖与时序信息;各 track 所需证据类型互补,误差重叠提示共享失败模式。
基线对比解读
“当前模型在工具中心理解上仍显著落后于通用视频问答的表现。”
Gemini-3.1-Pro 虽为已评估模型中最强,但 Perception & Grounding 轨道比其自身整体低 15.2 个百分点,说明通用视频问答能力没有充分迁移到工具操作的视觉证据接地任务。微调后 Qwen3-VL-8B-Instruct 总分仍低于 Gemini,但以较小参数量大幅缩小差距,证明领域数据比单纯增加模型容量或输入帧数更关键——原文指出“additional model and input capacity do not close the gap”。
行业影响
落地场景
EgoTools 为第一视角工具使用推理提供了数据 + 基准双重基础设施,可支撑 AR 辅助维修、机器人模仿学习、智能眼镜实时提示等产品。例如,工业设备维护中,AR 眼镜可基于手-工具-目标物体的几何关系与操作流程,实时校验步骤并预警错误;消费级场景中,烹饪、DIY 等应用可提供过程性问答与因果诊断。
商业价值
对企业服务与内容平台主要有两条变现路径:
- 降本:基于 EgoTools-Data 微调视觉语言模型,可减少人工培训视频的逐帧标注成本,并自动化生成 SOP 合规审计报告。
- 体验提升:视频平台能对第一视角 UGC 内容实现更精准的语义理解,如工具使用步骤识别、错误操作定位,从而增强搜索与推荐。
与现有产品/工作流的接口
EgoTools 可直接接入现有多模态模型训练与评测流水线:
- 数据侧:将
EgoTools-Data混入 SFT 数据集,提升 Qwen3-VL、Gemini 等模型在工具推理上的能力,尤其适配工业 AR、机器人操作等垂直领域。 - 评测侧:
EgoTools-Bench四个 track(Perception & Grounding、Geometry、Procedure、Causal)可作为回归测试集,嵌入 CI/CD 流程,防止模型升级后工具推理退化。 - 工程落地:其严格源视频分离原则可避免数据泄漏,适合作为私有化微调的基准数据。
具体 use case:
- 企业服务:某远程医疗设备厂商将 EgoTools 的标注协议用于手术器械操作视频,训练模型在术中实时给出器械使用合规提醒,降低培训与事故成本。
- 内容平台:短视频平台利用 EgoTools-Bench 的 Perception & Grounding 子集评估模型识别“切菜时刀与食材接触面”的能力,用于自动生成步骤类教程摘要,提升创作者效率。
局限
- 数据集规模与覆盖仍有限:EgoTools-Data 的 100 小时规模虽在工具中心自我中心视频中居前,但相比通用 Ego4D 等数据集仍较小,可能不足以覆盖长尾工具、复杂多步骤工序及跨域泛化。数据收集依赖任务引导和开放参与者驱动,容易引入选择偏差,参与者人口统计学特征可能影响手部形态、环境光照与遮挡等多样性。3D 标注为补充模态,并非所有帧都具备完整手物姿态,可能限制模型对精确几何关系的深度学习。
- 基准静态性与评估粗粒度:EgoTools-Bench 的 1000 组多选题为静态 QA,难以完整反映真实具身推理中的时序动态与动作决策过程。虽然采用了八选项归一化和反捷径检查,模型仍可能利用选项分布或语言先验而非视觉证据。准确率指标无法区分正确推理与巧合命中,也不能评估中间推理步骤、因果解释质量等。改进方向包括引入过程性评分、开放生成式评测或交互式评估。
- 训练效用验证不充分:仅对 Qwen3-VL-8B-Instruct 进行全监督微调,缺乏其他模型架构与规模的交叉验证。微调后准确率提升至 60.9%,仍低于 Gemini-3.1-Pro 的 66.9%,说明 EgoTools-Data 的训练收益受限于基座模型能力和数据质量,无法完全弥补预训练差距。此外,基准与训练数据来自同一收集协议,严格的源视频分离可能不足以反映对全新采集场景的泛化能力。