超越记忆中的世界:面向演化世界中持久导航的预测式 4D 信念
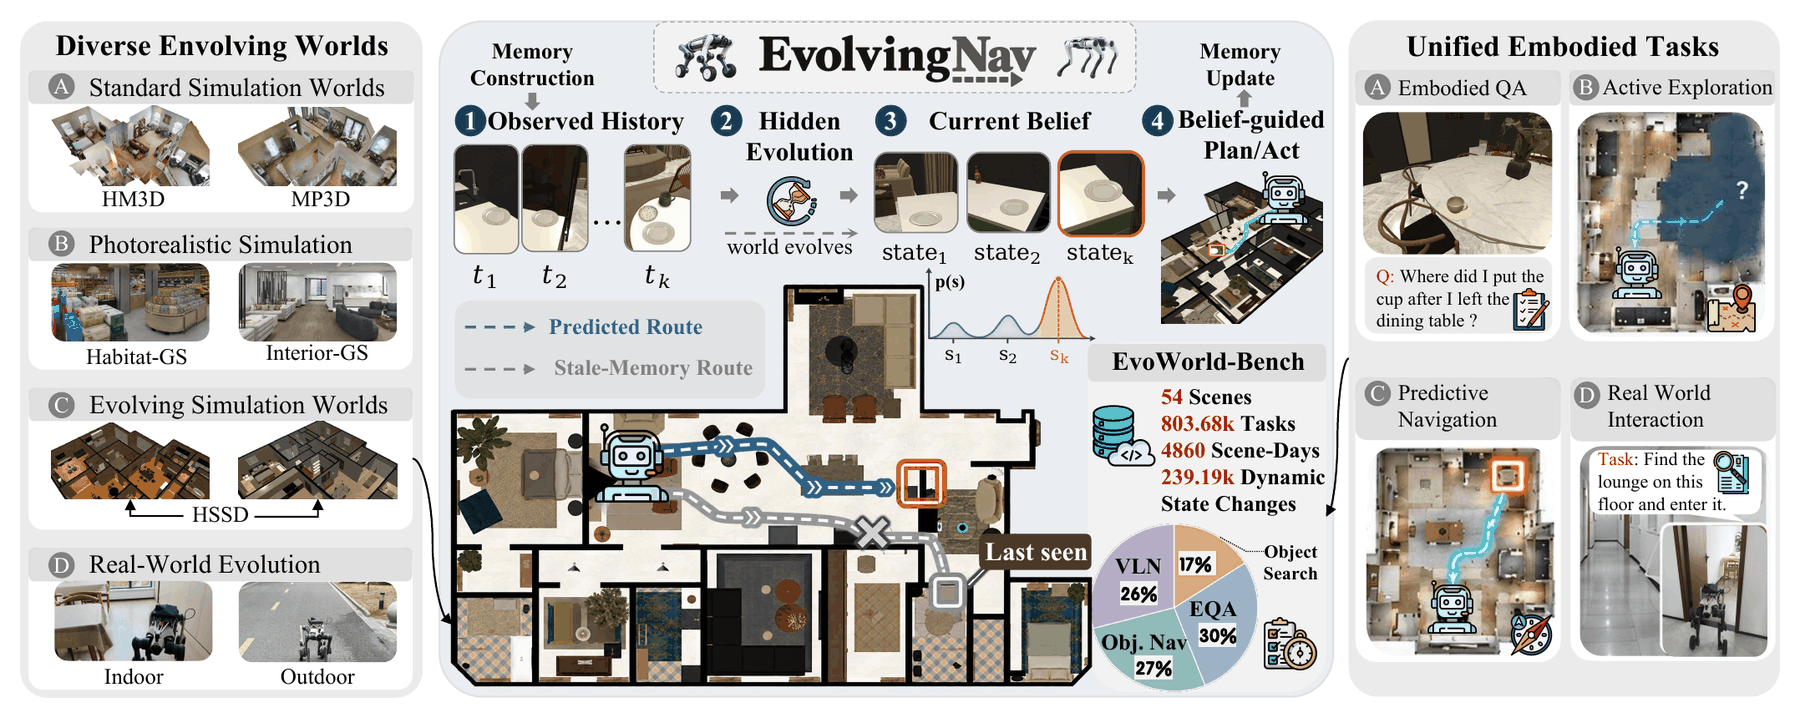
持久空间记忆让具身智能体能在重复访问中导航熟悉环境,但目标可能在未被观测(甚至导航过程中)时移动,使记忆位置不再可靠。论文研究 Evolving-World Navigation,要求智能体从间歇观测推断目标位置、预测检查时刻的状态并修正信念。 论文提出 EvolvingNav,从带时间戳的 3D 物体历史中,经结构化的 persistence-relocation 模型构建时间索引信念:既区分「停留在最后观测位置」与「迁移到其他位置」,也在已知候选集合之外保留概率质量。事件驱动滤波器 随时间传播信念、预测候选检查时刻的占据情况并融合新的 RGB-D 证据——负面观测按可见性条件下的检测概率下调假设,证据追踪则避免重复使用同一观测。冻结的 零样本视觉语言控制器 据此选择动作并重新规划。 作者还提出 EvoWorld-Bench 基准,以人类活动轨迹为基础,含 54 个场景、803,680 个任务,并控制导航前后的环境变化。仿真与真机实验表明,EvolvingNav 在导航成功率与搜索效率上均优于所评估基线。 配对实验显示,在可学习的时间模式下增益最为明显;消融实验则证明保留不确定性、引入可见性感知证据的价值。
论文精读
TL;DR EvolvingNav 用时间索引 4D 信念建模环境中目标的持续演化,预测巡检时位置并用可见性校准的证据更新,在仿真与真机中提升导航成功率与搜索效率。
问题
问题背景
具身智能中的持久空间记忆 与重复访问导航正成为长期部署的核心能力,研究者关注如何让 agent 在熟悉环境中高效定位可能移动的目标。
现有方法的局限
当前导航方法通常把目标位置当作静态语义锚点,或简单地检索最近一次观测。其主要技术局限包括:
- 忽略目标在未观测时段内的持续移动,导致记忆随 agent 到达而失效。
- 预测模型多是离线、固定时间步的,不能随导航过程在线更新信念。
- 候选位置假设有限且完备,无法表示目标不在已知候选集中的概率质量。
- 测量更新不考虑可见性条件,负观测不能按检测概率正确降权。
为什么难且重要
难度来自三个耦合问题:时间连续演化与离散决策之间的不一致;部分可观测下负观测的信息量依赖可见性;以及避免重复使用同一观测造成过置信。真实部署中,家庭服务机器人、仓储物流和 AR 设备都需要在目标可能移动的环境中持续规划,因此动态环境下的预测式导航 正受到工业界与学术界的共同关注。
行业类比
这类问题类似于自动驾驶中预测其他交通参与者轨迹,但 agent 自身也在移动并需同时规划,属于具身预测与控制强耦合的场景。
核心洞察
- 洞察1:在持续演化的世界中,导航记忆必须是时间索引的动态信念,而非静态快照。EvolvingNav 通过 persistence-relocation 模型为每个 3D 对象维护一个随时间演化的信念分布,并在决策时用事件驱动滤波器将信念前向预测到目标检查时刻。这区别于现有方法假设物体在两次观察间保持静止,或仅做短期运动预测而忽略长期未观察期间的漂移,使规划基于未来占用预测而非过时记忆。
- 洞察2:负观测(未看到目标)是有效但常被误用的导航证据,关键在于可见性条件化的检测概率校准。EvolvingNav 使用 visibility-conditioned detection probabilities 来更新信念,考虑视野、遮挡和距离等因素,允许在未发现目标时对候选位置合理降权而非简单排除。同时 evidence tracking 防止同一观测被重复利用,避免信念过度收缩,相比忽略负观测或固定检测率的 baseline,在有限可见性下能更准确地缩小目标范围。
方法
方法概述
输入:机器人多次访问过程中获得的带时间戳的 RGB-D 观测,以及从这些观测构建的 timestamped 3D object histories。
关键模块:
- Causal 4D Memory:将物体历史编码为 target-conditioned 的连续时间表示,为每个目标生成时间索引的状态表征,避免未来信息泄漏。
- Persistence–Relocation Belief:用一个结构化概率模型维护目标位置信念,区分“保持在最后观察位置”(persistence)与“迁移到其他候选位置”(relocation),同时保留对未知候选集合之外位置的概率质量,防止过度确定。
- Event-driven Filter:在时间推进时,根据 transition kernel 传播当前信念,预测目标在候选检查时刻的占用概率;收到新的 RGB-D 证据后执行测量更新,其中负观测通过 visibility-conditioned detection probabilities 进行校准下调,并通过 evidence tracking 防止同一观测被重复使用。
- Predictive Embodied Agent:使用 frozen zero-shot vision-language controller 消费更新后的信念,进行 arrival-aware action selection,并在新证据到来后重新规划路径。
输出:当前时刻目标位置的概率分布(belief),以及据此选择的导航动作序列。
与现有记忆检索或状态预测方法不同,EvolvingNav 显式建模导航过程中世界的持续演化,将不确定性和可见性校准纳入证据更新,而非简单记住固定位置或依赖单步预测。
实验
实验设计
- EvoWorld-Bench 基于人类活动轨迹构建,包含 54 个场景与 803,680 个任务,在导航前与导航中引入受控动态变化。
- 评估覆盖模拟与真实机器人平台,指标包括 导航成功率 与 搜索效率。
- 基线采用现有 embodied navigation 方法;通过配对实验隔离时间模式影响,并通过消融验证组件贡献。
关键发现
- EvolvingNav 在导航成功率和搜索效率上均超越所评估基线。
- 在可学习时间模式下增益最显著,说明模型能够捕捉目标移动规律。
- 消融显示,保留候选集合外的不确定性与引入 visibility-aware 证据更新,对性能贡献明显。
基线对比解读
- 相对仅依赖静态记忆或简单预测的方法,EvolvingNav 通过 4D belief 持续传播并融合 RGB-D 证据,在目标移动场景中更稳健。
- 负样本观测依据 visibility-conditioned detection probabilities 对定位假设进行降权,避免错误强化,这是相对纯检索式记忆的关键差异。
行业影响
落地场景
EvolvingNav 面向动态环境中的长期导航,典型落地包括:
- 家庭服务机器人(如 Amazon Astro、三星 Ballie)在多次巡检中定位移动物品(遥控器、手机、宠物玩具),利用历史轨迹预测物品当前可能位置,并在接近时通过视觉观测修正信念。
- 仓储 AMR(如 Kiva、Fetch)在库存频繁变动的场景中寻找目标 SKU 或临时摆放的托盘,减少无效扫描与重复遍历。
- 巡检无人机 / 安防机器人在人员、设备位置动态变化的园区中持续追踪目标。
商业价值
- 降本:通过预测目标占用概率,避免机器人反复搜索已空置区域,缩短单次任务时间,节省能耗与折旧成本;在仓库场景可提升拣选效率,减少人力干预。
- 增收 / 竞争力:任务成功率与搜索效率提升直接增强机器人产品的市场竞争力,尤其适用于订阅制家庭服务或按任务计费的仓储自动化方案。
- 体验提升:家用场景下,用户找物等待时间明显缩短,信任度与复购意愿提高。
与现有产品 / 工作流的接口
- 可作为高层决策模块集成进 ROS 2 / Nav2 导航栈,输出候选目标点与动作选择,与现有 SLAM、路径规划、目标检测组件松耦合。
- 依赖 RGB-D 相机与预训练目标检测器,可复用现有感知管道;事件驱动滤波器计算量小,适合部署在边缘设备(Jetson、Raspberry Pi)。
- 内存方面只保留 3D 对象历史与候选位置集合,存储开销可控,支持长时间运行。
与同类动态导航方法相比,EvolvingNav 显式建模了目标在未观测期间的持续运动,并保留候选集外的不确定性,更适合真实世界中目标可能出现在未建模位置的情况。
局限
- **依赖冻结的零样本 VLM 控制器**,控制策略与信念更新解耦,虽然便于零样本迁移,但未针对任务联合优化,可能限制决策质量。控制器仅基于当前信念做动作选择与重规划,无法利用导航历史中的策略性经验。在需要长期、多步推断的场景中,冻结控制器难以捕捉视觉-语言-动作的复杂耦合,与可学习的策略相比存在性能差距。论文未与端到端训练策略做充分对比,难以评估该设计对成功率的真实影响。
- **EvoWorld-Bench 的场景与动态模式均来源于家庭人类活动轨迹**,虽然规模大,但目标移动模式局限于日常物品在室内环境中的空间重定位。对于更开放、更动态的环境(如机器人农场、仓库、户外等),物体的移动规律可能呈现不同时间尺度和空间约束,学习到的持久-重定位模型未必能泛化。此外,候选位置集合由历史观察构建,对从未出现过的全新位置的概率质量保留虽提及,但具体建模与可扩展性不足,可能在高熵环境下失效。
- **方法计算开销与实时性未充分评估**。构造时间索引的 4D 记忆、维护持续-重定位信念、事件驱动滤波与候选检查时间预测,在多物体、长时程导航中可能面临状态空间爆炸。论文未给出推理延迟、内存占用或与轻量级基线在大规模场景下的扩展性对比。实际部署中,有限计算预算的机器人平台可能难以负担,限制了从仿真到真实机器人的直接迁移。