PAMI: 面向文本到人-物交互生成的部件锚定运动
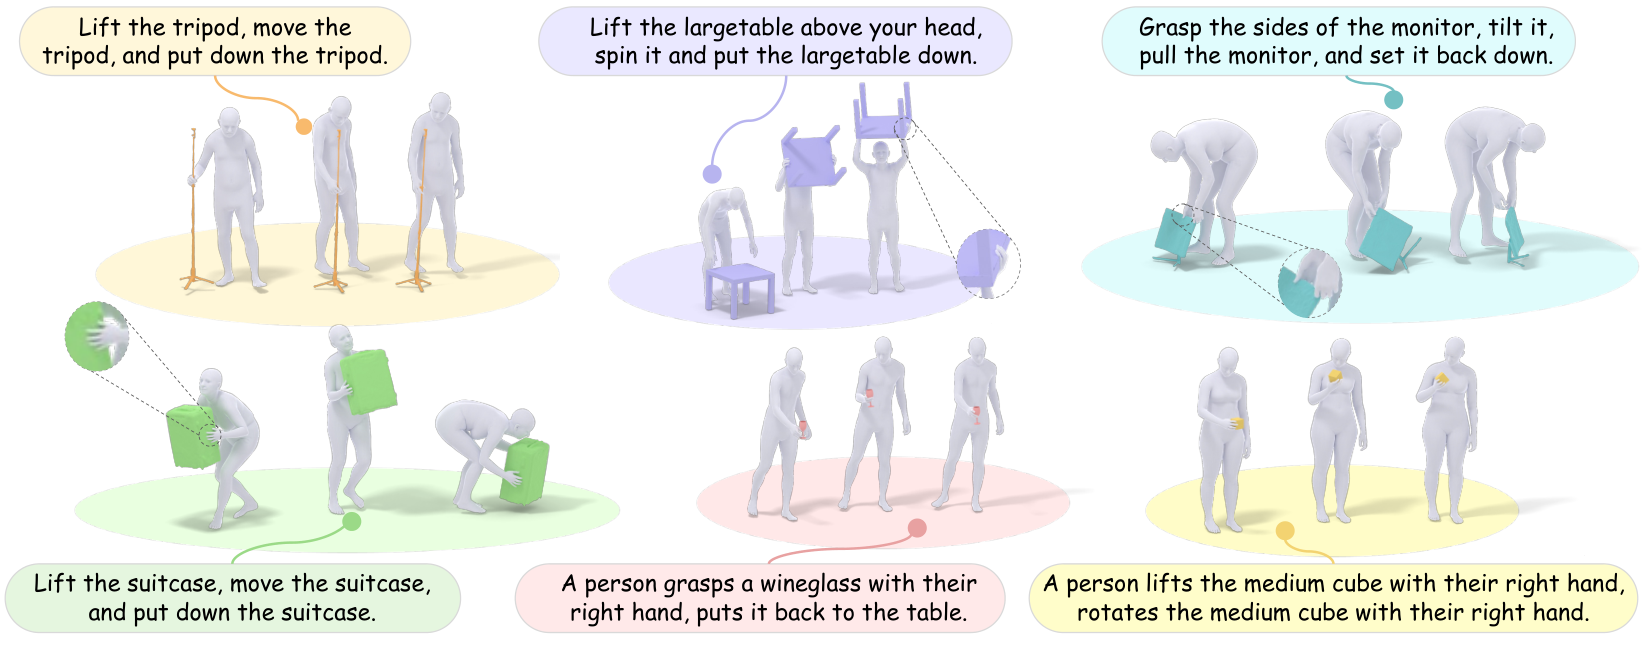
文本条件下的全身人-物交互(HOI)生成,需要合成与输入文本匹配、且随时间保持精确协调的人体运动与物体轨迹。多数方法将人体和物体表示为两条独立轨迹,并预测全局的人-物耦合;然而,隐式学习这种复杂且动态变化的关系,往往导致物体漂移、接触缺失 和 穿透 等问题。 我们提出 PAMI,一个面向交互生成的部件锚定运动 框架。受经典 Hough Transform 启发,核心思想是让身体部件锚点为物体运动投票以定位物体运动:将物体运动表示为相对多个身体部件锚点的形式,并用 PamiVAE 学习交互隐空间,解码逐帧权重来聚合这些部件特定的投票。基于该表示,PAMI 以由粗到细的层级生成交互:PamiGen 先在该结构化隐空间中从文本生成粗略的人-物交互,PamiRefiner 再通过混合表面感知表示递归解算细粒度接触几何,结合捕获整体部件影响的长程探针与解算物体表面附近细节接触的短程传感器。 在 InterAct 上的实验表明,PAMI 能生成更忠实的交互和更准确的人体相对物体运动,接触召回率比此前最先进方法高 14.5%。大量消融实验验证了部件锚定投票表示与混合表面感知细化的贡献。
论文精读
TL;DR PAMI 用身体部位锚点投票定位物体运动,生成文本驱动的全身人-物交互,大幅减少漂移与穿透,接触召回率提升 14.5%。
问题
问题背景
文本条件全身人-物交互生成(HOI) 是具身 AI 与数字人方向的核心任务,要求根据自然语言描述同时合成人体动作与物体轨迹,并保持时序上的精确协调,在机器人数据扩增、虚拟角色动画等领域有直接应用。
现有方法局限
主流方法将人体与物体表示为独立轨迹,通过隐式网络预测全局的人-物耦合关系。这种端到端隐式建模带来三类典型失败:物体漂移、接触丢失、穿透。原因在于人-物交互的接触依赖是稀疏、局部且动态变化的,例如“抓杯子”只涉及手部与杯柄,但全局坐标回归容易在长序列中累积误差,使得远处身体部位或无关物体部位错误地影响最终位姿。
为什么难/重要
人-物交互生成需同时满足文本语义、运动学可行性与物理接触约束,接触面附近的目标函数高度非凸,且微小初始误差会沿时间步传播放大。业界对可泛化、可编辑的 HOI 生成需求强烈——从合成训练数据到实时角色控制——但数据收集成本高、物理仿真难闭环,因此更依赖算法层面对局部锚定关系的显式建模。
行业类比
如同自动驾驶多智能体轨迹预测中,只预测全局航向而不建模车间距等相对量会导致碰撞,HOI 生成也需要显式建立身体部位与物体的局部相对约束才能保证接触可靠。
核心洞察
- PAMI 的核心表示创新是将物体运动建模为身体部位锚点的加权投票,而非直接预测全局物体轨迹。这一设计借鉴 Hough Transform,让物体定位由多个身体部位共同投票决定,从结构上约束人-物空间关系。相比将人与物体轨迹独立建模再学习耦合的方法(如 InterDiff),PAMI 显式编码了耦合先验,降低模型学习动态关系的难度,有效减少物体漂移与穿透,并在 InterAct 上带来接触召回率 14.5% 的提升。
- PAMI 采用由粗到细的生成层次:PamiGen 在锚点投票隐空间生成粗略交互,PamiRefiner 递归细化接触几何。PamiRefiner 引入混合表面感知表示,结合长程探针与短程传感器,分别捕捉身体部位整体影响和物体表面局部接触。这种分工使全局协调与局部精度解耦,细化过程更稳定,且表面感知模块可独立训练,对工程实现友好,易于复用至其他交互生成任务。
方法
输入:文本描述(如动作、物体类别)。
关键模块:
- PamiVAE(Part-Anchored Interaction VAE):受 Hough Transform 启发,将物体运动表示为相对于多个身体部位锚点的投票。每个锚点生成一个位置提议,网络解码出帧级权重来聚合这些提议,在潜在空间中显式编码人-物相对运动。
- PamiGen:从文本条件在结构化潜在空间中生成粗略的人-物交互,输出初始人体运动与物体轨迹。
- PamiRefiner:采用混合表面感知表示,递归细化精细接触几何。结合长程探针(捕捉整体身体部位影响)与短程传感器(解析物体表面附近的精细接触),减少穿透和漏接触。
输出:最终人体运动与物体轨迹,物体相对人体部位运动准确,接触召回率高。
与同类方法差异:与将人体和物体视为分离轨迹并隐式学习全局耦合的方法不同,PAMI 通过部位锚定投票显式建模相对运动,从而缓解物体漂移、漏接触和穿透。
实验
实验设计
实验在 InterAct 数据集上开展,覆盖文本条件全身人-物交互生成。评估焦点包括交互忠实度与物体相对人体运动的准确性,并与现有 SOTA 方法进行对比。通过消融实验分别验证 part-anchored voting 表示与 hybrid surface-sensing refinement 两模块的贡献。
关键发现
PAMI 在 Contact Recall 指标上比先前 SOTA 提升 +14.5%,表明生成的交互接触更精确、漏接触更少。同时,物体相对人体运动的预测更准确,整体文本一致性更好。
对比基线深度解读
先前方法通常将人体与物体表示为独立轨迹,隐式学习全局耦合,难以处理动态变化的接触关系,常出现物体漂移、接触缺失、穿透等问题。PAMI 受 Hough Transform 启发,将物体运动表达为多个身体部位锚点的加权投票,结构上明确局部空间关系,使粗生成阶段即获得协调的全身-物体布局。后续 PamiRefiner 以混合表面感知递归细化接触几何,进一步降低穿透与接触误差。消融结果表明两模块各自提升指标,验证了显式局部锚定与几何细化在 HOI 生成中的必要性。
行业影响
落地场景
PAMI 适用于需要高精度人-物交互动画生成的场景,如虚拟主播产品展示、游戏角色与道具交互、AR/VR 培训模拟、机器人操作数据合成等。相比现有方法,其显式的身体部位锚点投票机制能有效减少物体漂移和穿透,尤其适合要求精确接触的应用,如虚拟试穿、工具操作演示。
商业价值
文本直接生成交互动画,可大幅降低传统动画制作中手工关键帧或动捕的成本,缩短制作周期。在电商虚拟试穿中,更准确的接触能提升商品展示真实感,减少用户因“不贴合”导致的退货率。同时,该技术开拓了文本驱动交互内容生成的新市场,可集成到内容创作平台,为 UGC 创作者提供低门槛的动画生成能力。
与现有产品/工作流的接口
PAMI 可封装为推理服务或模型插件,接入现有动画软件(如 Blender、Unity、Unreal)或生成式 AI 平台。其输出是标准化的人体骨骼和物体轨迹,可无缝导入渲染引擎进行后处理。工程上,可先用 PamiGen 生成粗交互,再用 PamiRefiner 进行接触几何细化,形成两阶段管线,便于按需调整计算开销。GitHub 仓库提供代码,支持快速集成。
具体落地 use case
- 电商虚拟试穿/产品展示:输入文本“模特拿起咖啡杯喝一口”,自动生成身体动作与杯子轨迹,用于商品详情页动态展示,替代实拍,降低内容生产成本。
- 游戏/虚拟人 UGC 平台:玩家通过文字指令让虚拟角色与场景物体交互(如“打开宝箱”),自动生成动画,无需动画师手动制作,提升内容产出速度。
局限
- **PAMI** 目前仅针对**单个刚体物体**与**全身人体**的交互生成,尚未覆盖多物体协作、可变形物体、工具链或复杂手部微操作等场景;这一限制由 **InterAct** 数据集的构成所决定,若直接扩展到新物体类别或交互类型,需要重新采集并标注高精度的人体关节、物体 6D 姿态与接触标签,数据成本较高。此外,方法依赖准确的**人体姿态估计**与**物体位姿估计**,在遮挡严重或快速运动时,anchor 投票可能失效。
- **PamiRefiner** 的**递归几何细化**在提升接触精度的同时引入了额外计算开销,作者在附录中报告了细化步数与运行时间的权衡,但未在实时或部署场景下做充分验证;对于需要低延迟的应用,多步细化可能不可接受。另外,生成过程基于 **VAE 潜在空间**的解码,潜在的平滑效应可能丢失高频接触细节,尽管混合表面感知缓解了该问题,但接触召回率与穿透率之间仍存在权衡。
- 与同类方法(如 **InterDiff**、**HOI-Diff** 等)相比,**PAMI** 主要优化的是**接触召回率**与**人物相对物体运动精度**,但评估指标仍以几何匹配为主,缺乏对**物理合理性**(如力交互、摩擦力、重心平衡)的显式建模或惩罚;因此生成的交互可能包含轻微穿透、不符合动力学的接触或物体滑动。此外,该方法仅与基于扩散或 VAE 的 baseline 比较,未与基于强化学习或物理仿真的方法直接对比,泛化边界尚不明确。