MILO:通过编排式多智能体演化的自动化 Harness 发现
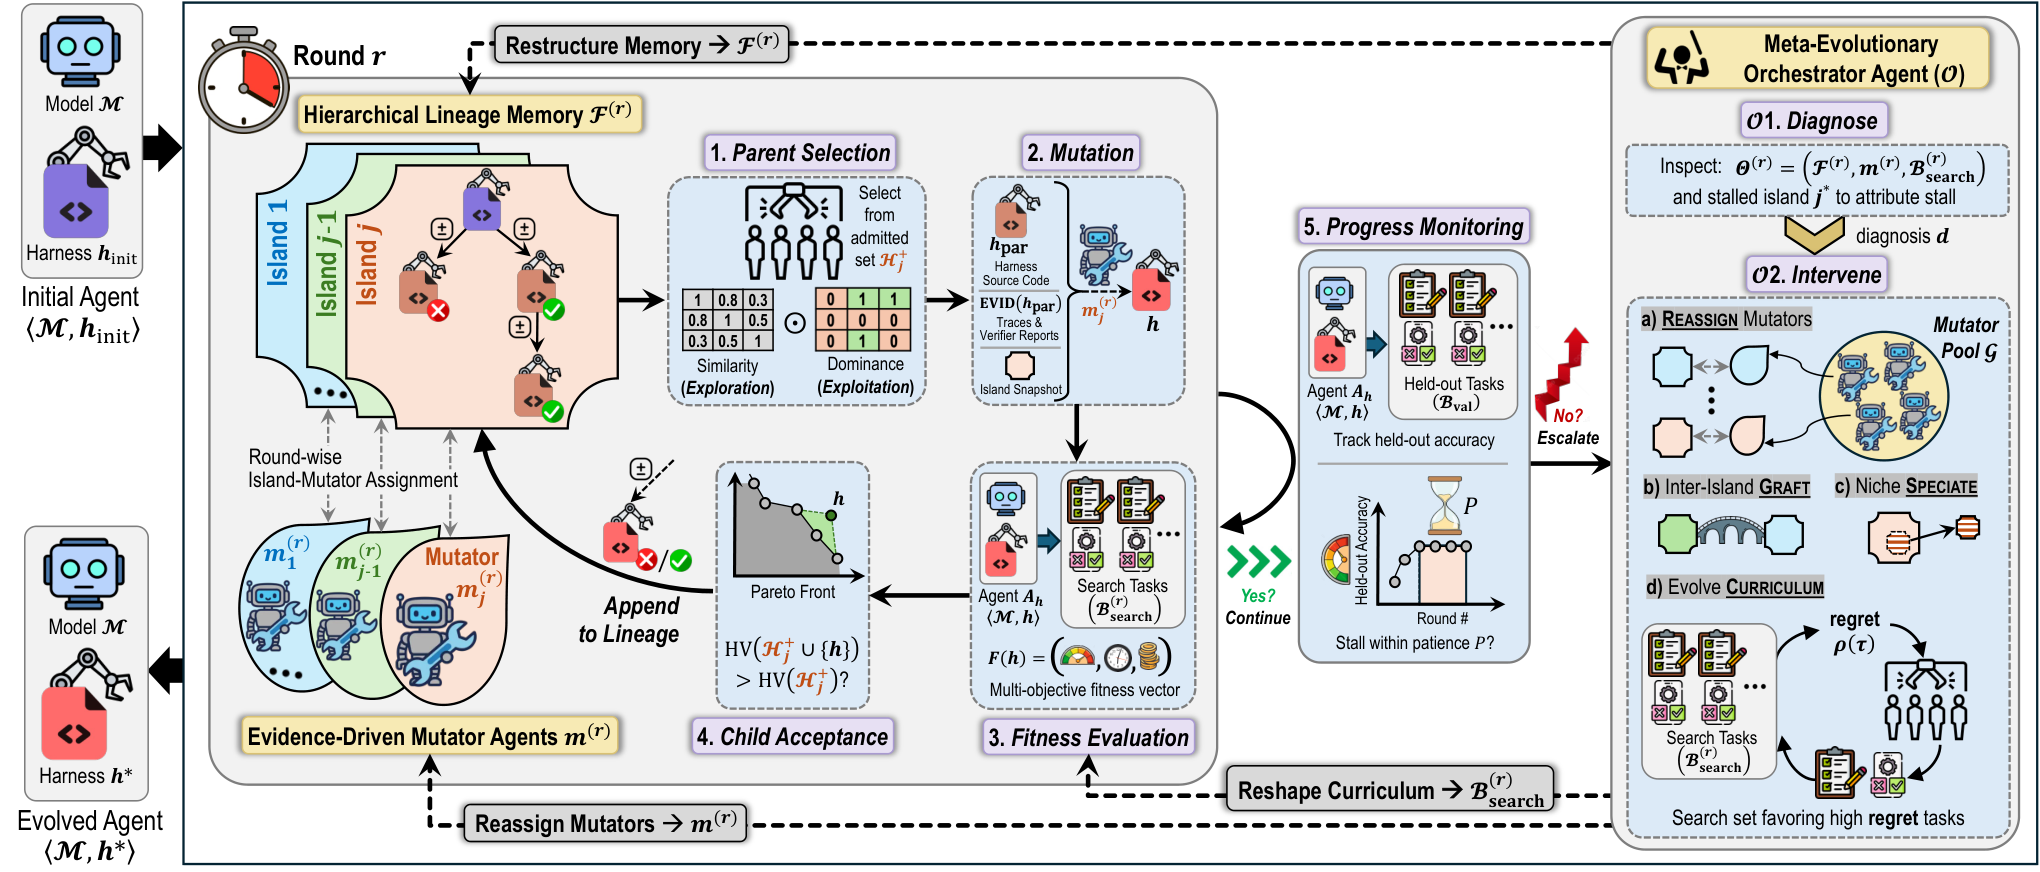
现代 agentic 系统由 AI 模型与一个控制执行和环境交互的 harness 组成。harness 设计对长时程性能影响极大,但其组合搜索空间需要大量人力,且模型每次更新都要重做。现有自动化方法探索范围狭窄,只优化 prompts 或 skills 等单个组件,或陷入固定的利用式搜索策略。 为此提出 MILO(Meta-evolutionary Island Orchestration),一个让 agent harness 与发现策略协同演化的框架,包含三部分: 1. 基于 island 树的层级谱系记忆,把被拒绝的变异当作负证据; 2. 每个 island 的 mutator agent 依据全局搜索历史与父代专属反馈重写完整 harness; 3. orchestrator 通过谱系嫁接与物种形成、mutator 重分配和课程修订来调整搜索。 在 Terminal-Bench 2.1、PaperBench 和 DeepSWE 上,MILO 发现的 harness 超越八个 SOTA harness 与六种搜索方法(使用 frontier 模型 Opus 4.8 和开放权重模型 gpt-oss-120b)。使用 Opus 4.8 时,相对初始 harness 分别提升 +12.0%、+28.3%、+10.3%,而此前最佳搜索方法仅提升 +4.5%、+18.3%、0%。在 Terminal-Bench 2.1 上达到 86.1±2.0%,超过官方 leaderboard 榜首(83.8±2.3%),且 token 用量比初始 harness 少 26%。 在 EinsteinArena 开放问题上,MILO 还改进了 Erdős minimum-overlap(0.3808586 → 0.3808568)及第一、第三条自相关不等式(1.50274365 → 1.50274360;1.45081 → 1.44889)的已知上界。
论文精读
TL;DR MILO 通过元进化岛屿编排同时演化智能体 harness 与搜索策略,在 Terminal-Bench 2.1 等基准上以显著更高分辨率超越八种 SOTA harness 和六种搜索方法,并改进数学开放问题上界。
问题
问题背景
现代 agentic 系统由 AI 模型与 harness(控制执行、环境交互、技能库的软件层)共同构成,业界普遍关注如何提升长时程任务(long-horizon)性能,而 harness 设计是其中的关键变量。
现有方法局限
- 组件级优化:现有自动方法(如 DSPy、AgentOptimizer)大多只调整 prompt、skills 等单一组件,无法探索 harness 的完整结构。
- 固定搜索策略:基于 LLM 的进化搜索(如 EvoPrompt、FunSearch)使用固定的变异算子和选择压力,存在 exploitative bias,容易收敛到局部最优。
- 忽略负面证据:被拒绝的中间变异通常被直接丢弃,无法作为反例来剪枝搜索树,导致搜索历史利用率低。
为什么难/重要
harness 搜索空间涵盖控制流、工具选择、记忆管理、提示模板等多个维度,呈组合爆炸;且不同模型对同一 harness 的敏感度差异大,需要搜索策略本身具备自适应能力。自动发现高质量 harness 可显著减少人工迭代成本,并直接提升 Terminal-Bench、PaperBench 等基准上的得分,因此成为 agent 工程的核心挑战。
行业类比
类似 AutoML 中同时优化模型架构与超参数搜索策略,而非单层调参;也如同编译器中联合搜索 pass 顺序与调度策略,避免固定流水线带来的次优解。
核心洞察
- MILO 的核心洞察是将搜索策略本身作为进化对象,通过元进化实现搜索过程的自适应。与现有方法仅优化提示、技能等单一组件或采用固定搜索策略不同,MILO 的 orchestrator 能够动态调整血统嫁接、物种形成、变异者分配和课程,使搜索策略随搜索历史和环境反馈不断演化,从而避免陷入局部最优,在长时程任务中保持探索效率。
- 分层血统记忆利用被拒绝的突变作为负证据,驱动变异者进行更精准的全局重写。传统进化搜索通常只保留成功样本,而 MILO 在岛式树结构中保留失败突变及其上下文,为变异者智能体提供父代弱点的具体反馈,使其能够综合全局搜索历史生成针对性修改。这种负证据利用显著提升了搜索的样本效率,并在 Terminal-Bench 等基准上以更少 token 超越现有 SOTA。
方法
MILO 的输入是一组种子 harness(如 DeepAgents 或专家设计的 B10–B12)以及目标任务基准。整体流程采用 元进化 框架,外层同时优化 harness 与搜索策略。
关键模块
- 分层谱系记忆:以岛屿树组织所有 harness 变体,每个岛屿代表一个谱系,记录成功与失败突变。被拒绝的突变作为 负证据,用于修剪无效路径并引导进入有前景的谱系。
- 证据驱动 Mutator 代理:每个岛屿配备一个 mutator LLM,它读取全局搜索历史与父代 harness 的弱点反馈,生成 完整 harness 重写(覆盖控制流、prompt、工具调用等),而非局部微调。
- 元进化编排器:一个 orchestrator agent 定期评估各岛屿进展,执行 谱系嫁接(grafting)、物种形成(speciation)、mutator 重新分配与 课程修订(curriculum revision),使搜索策略本身随进程自适应。
经过多轮进化,MILO 输出一个性能超越初始 harness 的优化版本,同时保留进化过程中发现的搜索策略与谱系证据。
差异点: 与仅优化 prompt/skills 或固定搜索策略的现有方法不同,MILO 将搜索策略作为被进化对象,通过元级编排在全局探索与局部利用之间动态平衡。
实验
实验设计
MILO 在三个长时程 agent 基准上评估:Terminal-Bench 2.1、PaperBench 和 DeepSWE,使用 Opus 4.8(前沿模型)与 gpt-oss-120b(开放权重模型)。对比对象包括 8 个 SOTA harness 与 6 种搜索方法;此外在 EinsteinArena 开放数学问题上测试科学发现能力。初始 harness 来自专家设计的 B10–B12。
关键发现
- 在 Terminal-Bench 2.1 上,MILO 达到
86.1 ± 2.0%,超过官方榜首83.8 ± 2.3%,同时 token 消耗减少 26%。 - 在 PaperBench 和 DeepSWE 上,MILO 分别带来
+28.3%和+10.3%的分辨率增益,而最佳 prior-search 方法分别仅为+18.3%和0%。 - 在 EinsteinArena 上,MILO 改进三个数学上界,例如 Erdős minimum-overlap 从
0.3808586降至0.3808568。
与基线对比解读
MILO 的核心优势在于 Meta-evolutionary 策略 同时进化 harness 与搜索策略,避免固定搜索策略陷入局部最优。相比 prior-search 在 DeepSWE 上增益为 0,MILO 仍取得 +10.3%,表明其能够突破探索瓶颈。从工程角度看,MILO 不仅提升准确率,还降低 token 成本,这对生产环境中的长时程 agent 部署具有实际价值。
行业影响
落地场景
MILO 自动发现 agent harness,适用于任何依赖 LLM 智能体进行长期任务的系统,如软件工程助手、数据分析流水线、电商客服自动化、金融合规审查等。这些场景中 harness 设计(控制流、工具调用策略、记忆管理)直接影响任务完成率与 token 成本,且需随模型更新不断重调。
商业价值
- 降本:减少人工设计 harness 的专家时间;在 Terminal-Bench 上 MILO 发现的 harness 比初始配置少用 26% token,直接降低推理成本。
- 增收/体验:任务解决率显著提升(Terminal-Bench +12.0%,PaperBench +28.3%),转化为更高的产品成功率与用户满意度。
- 相比现有搜索方法(最高 +4.5%、+18.3%、0%),MILO 避免局部最优,可持续适应新模型。
与现有产品/工作流接口
MILO 作为离线优化器,输出可部署的 harness 配置(YAML/JSON),可集成到 CI/CD 流程:模型更新或任务集变化时,自动重新运行进化搜索,替换生产环境 harness。与 LangGraph、AutoGen 等框架兼容,无需重构现有代码。
具体 use case
- 电商智能客服:多步退换货流程中,MILO 自动优化工具调用顺序、记忆更新策略,减少 token 并提高一次性解决率。
- 企业软件开发助手:在代码仓库修复任务中,MILO 发现更优的上下文检索与验证步骤,提升 DeepSWE 类任务通过率。
局限
- **计算开销较大**:MILO 需要同时运行多个进化岛、维护层次谱系记忆,并反复调用 LLM 作为 mutator 与 orchestrator,导致搜索过程消耗大量 token 和 API 请求。虽然论文指出在 Terminal-Bench 2.1 上最终发现的 harness 在推理阶段比初始 harness 节省 26% token,但这并不包含搜索阶段的总成本。对于资源有限的团队,完整复现搜索可能难以承受,限制了方法的实际推广。
- **依赖底层 LLM 能力**:MILO 的 mutator 和 orchestrator 本身就是 LLM 驱动的智能体,其搜索质量高度依赖于所用模型(如 Opus 4.8 或 gpt-oss-120b)的推理与代码生成能力。论文未系统研究在较弱模型或不同开源模型上的表现,也未分析跨模型迁移的鲁棒性。当底层模型更新后,搜索过程需要重新运行,与论文所批评的“人类设计 harness 需反复投入”问题类似,只是将成本转移到了搜索框架本身。
- **泛化性与初始种子偏差**:实验仅在 Terminal-Bench 2.1、PaperBench、DeepSWE 三个 agentic 基准上验证,且初始 harness 来自专家设计的 B10–B12 等高质量种子,这可能使进化搜索更容易找到局部最优。论文缺少从随机或极简 harness 启动的对照实验,无法评估对初始种子的敏感度。此外,在 EinsteinArena 数学问题上改进幅度极小(如 0.3808586 到 0.3808568),可能属于数值波动而非实质性突破。