广泛探索,锐利推理:通过 Sampling 将小模型推向前沿
power-sharpened sampling 是一种无需参数更新或外部奖励、在推理阶段替代 RL 后训练以增强 LLM 推理能力的方法。它通过放大基座模型中的高概率序列来强化推理,避免了 RL 高昂的优化成本与不稳定的泛化表现。然而,该方法面临根本性的探索—利用权衡:强锐化会限制探索,使采样器陷入看似合理但错误的推理轨迹;弱锐化则导致答案分布过于分散。 为化解这一矛盾,我们提出 Parallel Power Tempering (PPT),用并行回火(parallel tempering)实例化 power-sharpened LLM 采样。该方法并行运行多个处于不同锐化程度的交互副本(replica),让低功率副本探索多样的推理轨迹,高功率链进一步利用锐化目标偏好的高概率回复。具体而言,我们通过缓解先前 power sampler 中发现的截断偏差,使 PPT 适配推理时采样,并在有限内存与算力预算下研究有效的交换策略。 大量实验表明,PPT 显著提升了单链 power-sharpened sampling,并优于经 RL 后训练的模型,能生成更高质量的推理轨迹,甚至在性能上可与前沿模型相媲美。
论文精读
TL;DR 针对 power-sharpened sampling 的探索-利用冲突,提出 Parallel Power Tempering (PPT),通过多锐化强度副本并行交互,无需训练即可让小模型推理性能超越 RL 后训练模型,逼近前沿模型。
问题
问题背景
LLM 推理能力的提升目前高度依赖 RL post-training,但其训练成本高、Reward hacking 与泛化不稳定促使业界转向 inference-time 采样增强路径。Power-sharpened sampling 作为代表方法,通过直接放大 base model 下高概率序列,无需参数更新或外部奖励即可提升推理质量。
现有方法局限
单链 power-sharpened sampling 存在根本的 exploration–exploitation 两难:
- 强 sharpening 将采样过度集中到少数高概率轨迹,采样器容易陷入“看似合理但错误”的推理分支,探索不足。
- 弱 sharpening 保留过宽的答案分布,无法有效利用 sharpened target 的高概率信息。
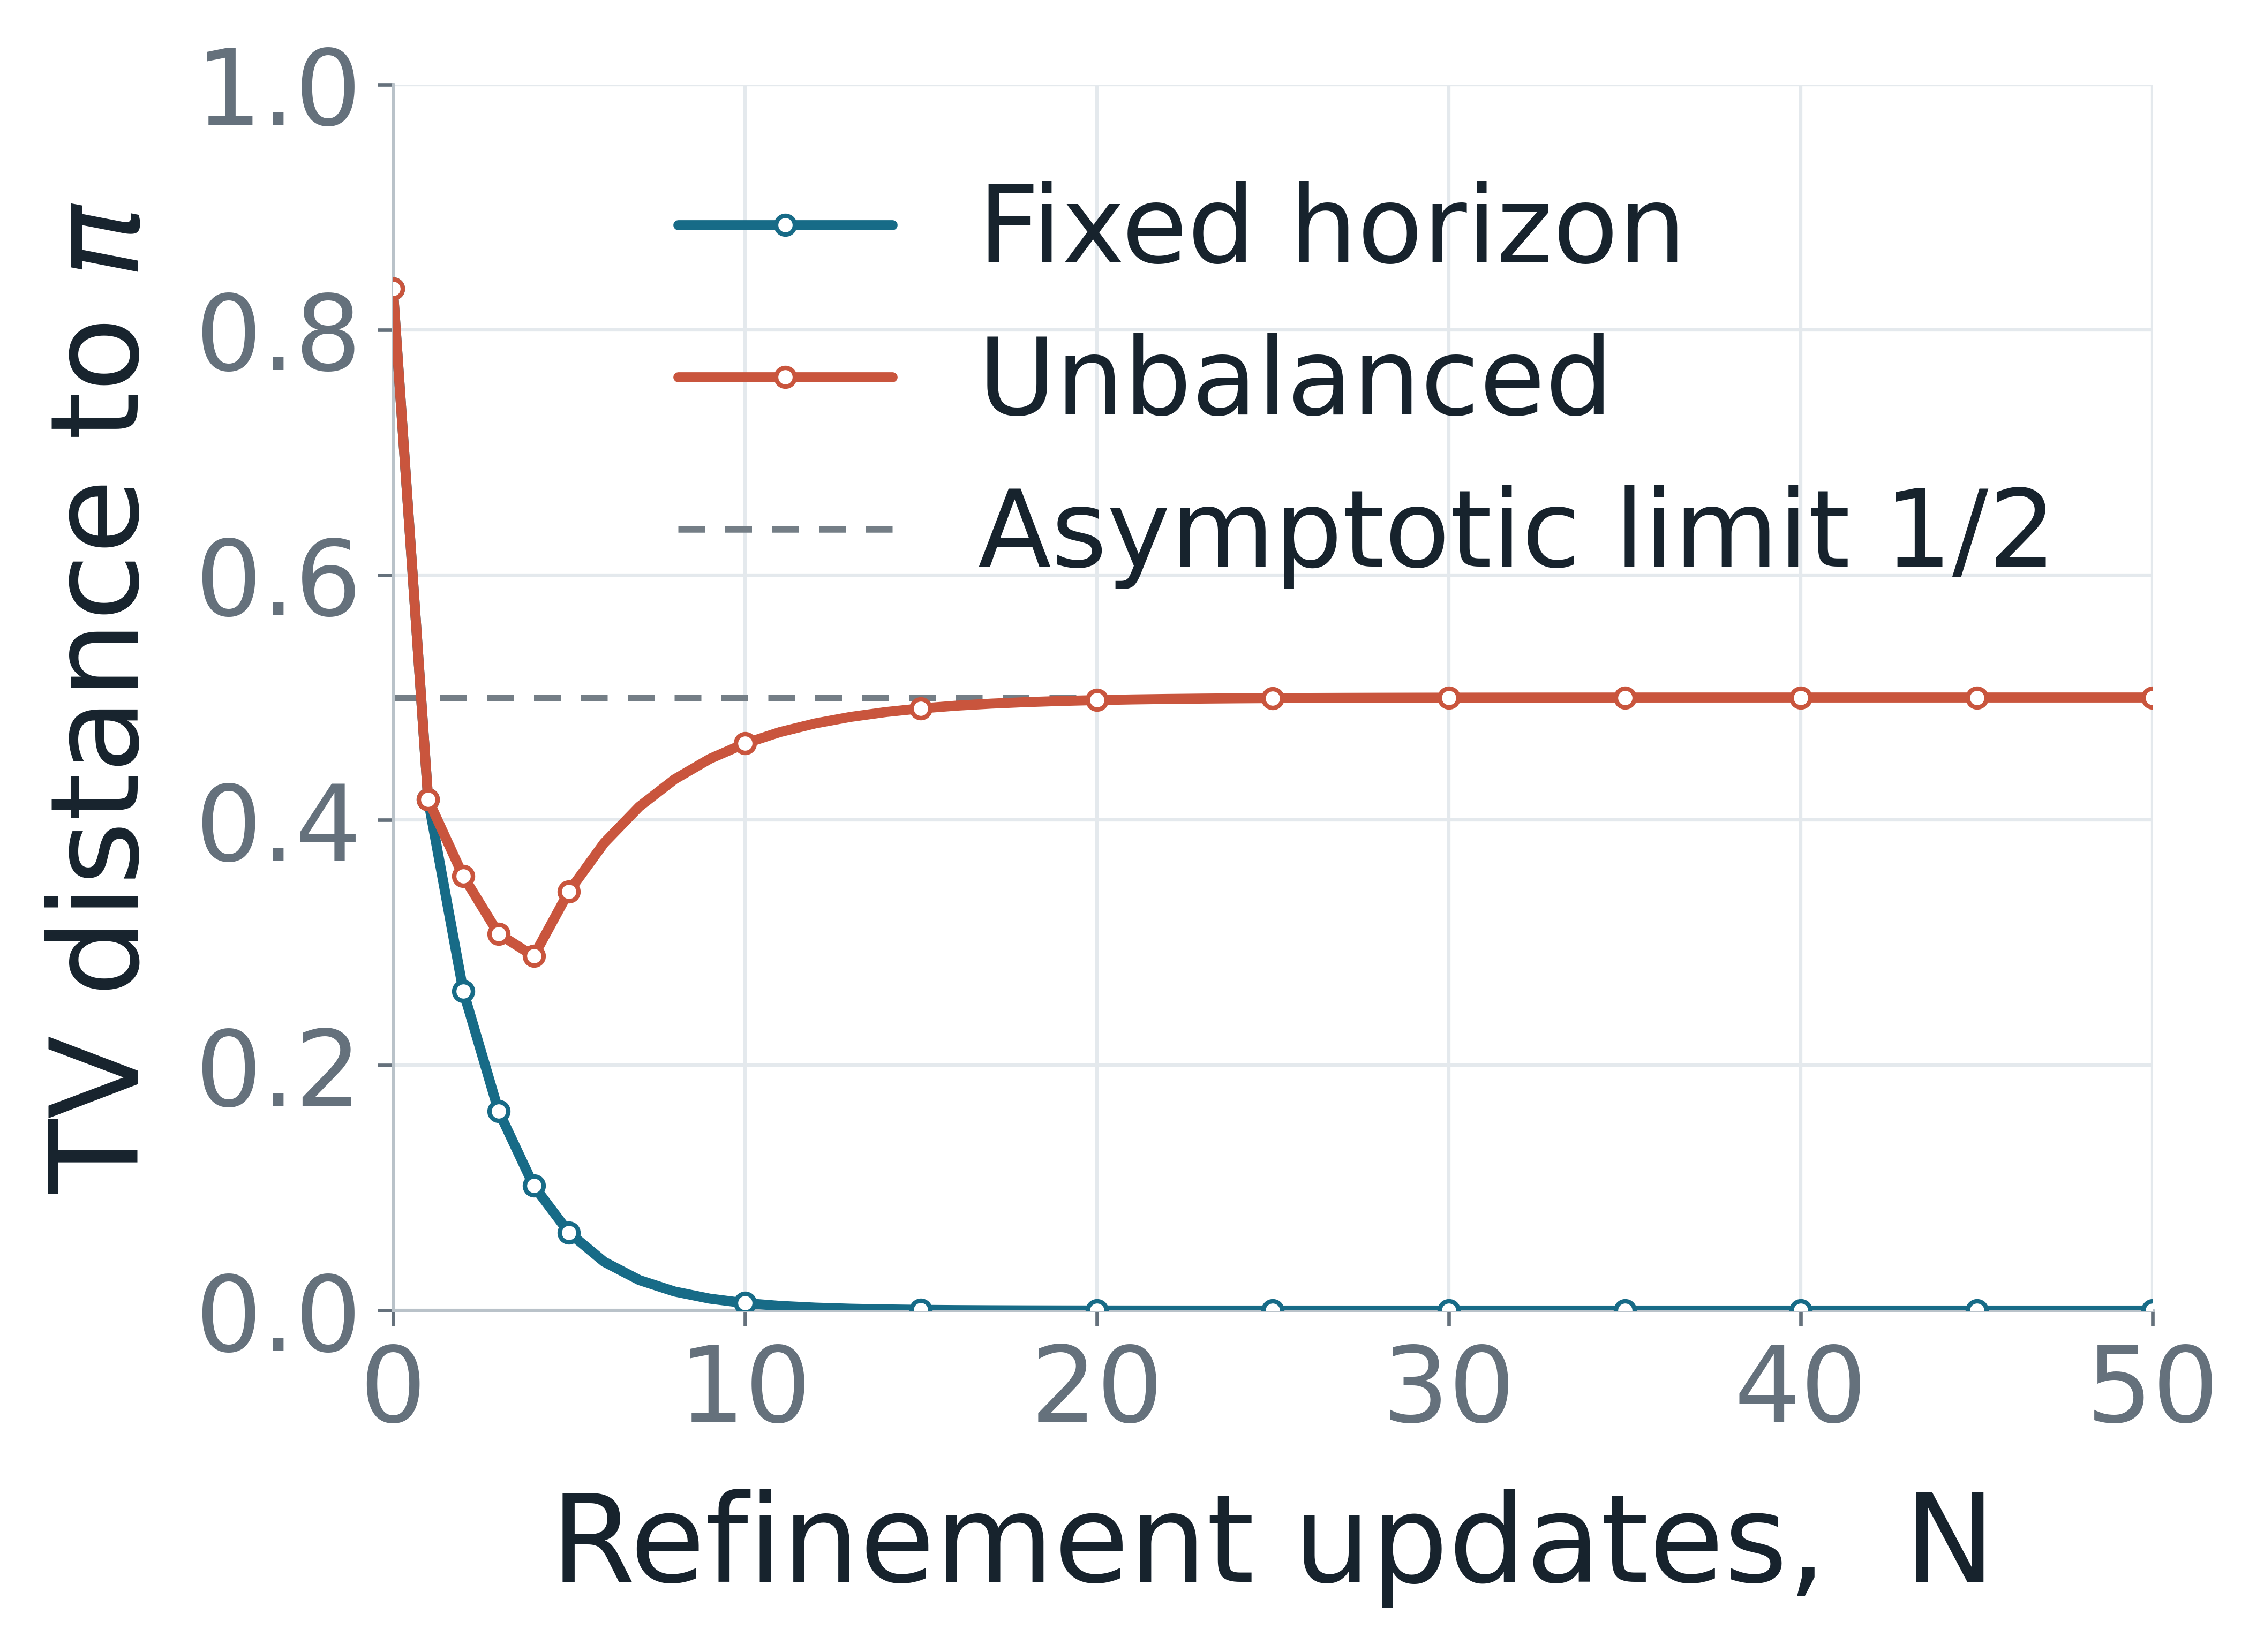
- 先前 power samplers 还存在结构性截断偏差(truncation bias),导致实际采样分布偏离目标分布。
为什么这个问题难/重要
推理任务要求多步逻辑一致性,中间步骤的错误会级联放大;但 inference-time 计算预算有限,不能简单增加采样数量。业界高度关注如何以低成本让小模型接近 frontier 性能,因此有效平衡多样性与收敛性成为关键。
行业类比
类似代码生成场景:采样策略需要并行探索不同 API 用法与实现路径,避免陷入局部错误方案,同时快速收敛到高概率正确代码,如同同时运行多个温度链的 ensemble search。
核心洞察
- PPT 通过并行回火将 power-sharpened sampling 从单温度采样升级为多温度交互采样,在推理时同时获得探索与利用,避免了 RL post-training 的高成本和泛化问题。 这一角度独特在于:它不修改模型参数、不使用外部奖励,仅通过多个不同功率的 replica 之间的交换,实现了对高概率序列的放大和低概率轨迹的探索平衡,相比单链 power sampling 显著提升了推理质量。
- 论文识别并修正了先前 power samplers 中存在的结构性截断偏差(truncation bias),提出固定视界校正(fixed-horizon correction),确保 PPT 采样的目标分布无偏。 这一发现为任何基于序列级 power sharpening 的推理时采样方法提供了理论基础,并且实验表明该校正对最终性能至关重要,体现了从理论到实践的严谨性。
方法
输入与目标
给定一个预训练 LLM(未经过 RLHF 或 RL post-training)和推理 prompt,目标是在推理阶段提升小模型的复杂推理能力,且不更新参数。
关键模块:Parallel Power Tempering (PPT)
方法基于 power-sharpened sampling:通过调整采样分布(如温度或幂次缩放)来放大高概率序列,但单一锐化水平存在探索-利用权衡。PPT 引入多个并行副本(replicas),每个副本运行在不同的 power level(锐化强度)上:
- 低 power 副本:保持较平的分布,负责广泛探索多样推理轨迹,避免陷入局部合理但错误路径。
- 高 power 副本:锐化分布,集中采样高似然序列,负责利用和收敛到更优答案。
副本间通过 swap exchange(交换状态)进行交互,允许低 power 副本发现的优质轨迹传递到高 power 副本,而高 power 副本的收敛信息也可回传,实现全局平衡。
为克服先前 power sampler 的截断偏差(truncation bias),PPT 引入 fixed-horizon correction,确保在固定生成长度下目标分布不被破坏。此外,方法在有限内存和计算预算下设计了有效的 swap 策略 和 ladder design(power 阶梯设计),以最大化副本间交换效率。
输出
输出为最终高 power 副本的推理轨迹或答案,具有更高正确率和置信度。
跟同类方法的差异点:与 RL post-training(如 PPO)不同,PPT 完全在推理时进行,无需奖励模型或参数更新,且通过 parallel tempering 机制系统性地解决探索-利用权衡,而非单纯依赖温度调节或拒绝采样。
实验
实验设计
本文提出 Parallel Power Tempering(PPT)作为推理时采样方法,在多个推理任务上评估。实验对比包括:单链 power-sharpened sampling、RL 后训练模型以及 frontier models。其中包含 compute-matched controls 和 ablation studies,并针对内存与计算预算研究有效的 swap 策略。
关键发现
PPT 显著提升单链 power-sharpened sampling 的表现,并且优于 RL 后训练模型,生成的推理轨迹质量更高,在部分指标上接近 frontier models 水平。
作者识别并修正了先前 power samplers 中的 truncation bias,并通过固定 horizon 的修正方法解决探索-利用权衡。
与基线对比解读
与 RL 后训练相比,PPT 无需参数更新或外部奖励,避免了昂贵的优化过程和泛化不平稳问题。相较于纯 power-sharpened sampling,PPT 通过多副本并行运行在不同 sharpening 水平,低 power 副本探索多样轨迹,高 power 副本利用高似然响应,有效缓解了探索瓶颈。该设计对实际工程的意义在于:推理阶段可以仅通过采样策略提升小模型推理能力,无需额外训练基础设施,适合在有限算力下部署。
行业影响
落地场景
Power-sharpened sampling 和 PPT 适合在资源受限环境下部署小模型(如 1B–7B)处理需要多步推理的任务。典型场景包括:电商智能客服的售后纠纷诊断(需综合订单、物流、用户描述进行多步归因),教育平台的数学/逻辑解题辅导,内容平台的事实核查与规则判断,以及企业服务中的代码审查建议。这些场景对延迟和成本敏感,且往往无法承担大模型 API 的规模成本,小模型与 PPT 的结合能在边缘 GPU 或 CPU 集群上提供接近前沿模型的质量。
商业价值
主要降本线:完全免去 RL 后训练所需的大规模 GPU 集群、奖励模型标注和工程迭代,仅通过推理时采样即可提升小模型表现。相比于直接调用 frontier API,单位 token 成本可下降一个数量级;同时回答质量提升能直接减少人工客服/审核介入率,带来增收和体验提升。值得注意的是,PPT 引入多副本并行,推理延迟有所增加,但论文的 compute-matched controls 表明可在同等算力预算下优于单链采样。
与现有工作流的接口
PPT 不改变模型权重,可作为现有推理引擎的采样插件集成。实现上,需要在 vLLM / TGI 等 serving 框架中增加多副本状态管理和 swap 通信协议;可封装为统一的 Sampler 接口,配置温度阶梯(power ladder)和交换频率。对于已有线上模型,只需替换采样策略,无需重新训练或模型热更新;参数可通过离线 sweep 标定,并作为配置文件下发。
局限
- PPT 在推理时需并行运行多个交互副本,且涉及局部精炼与交换步骤,计算与内存开销显著高于单链采样或标准温度解码。论文虽在 finite memory/compute budgets 下进行了设计,但未与 Best-of-N、tree search 等同样增加推理预算的方法做系统性的成本-收益对比,其实际部署效率尚不明确。
- 方法核心收益来自对探索性推理路径的保持,对于答案分布较集中、无需大量探索的任务(如短文本生成、事实问答),并行回火可能引入不必要的多样性,甚至降低确定性输出的质量。论文实验主要集中在数学推理与代码生成等需要长程探索的场景,对其他任务类型的泛化性有待验证。
- PPT 中的交换接受率与温度阶梯设计直接影响收敛速度与目标保持性,但论文对 ladder 设计与交换策略的鲁棒性分析有限,未充分讨论不同模型规模、不同 prompt 分布下超参数的敏感性。此外,与 RL 后训练相比,PPT 不修改模型权重,对于模型本身能力上限的突破可能受限,难以弥补模型基础能力的根本差距。