主动式 Agent 的基础:原则、技术层级与 Proactivity-Gym
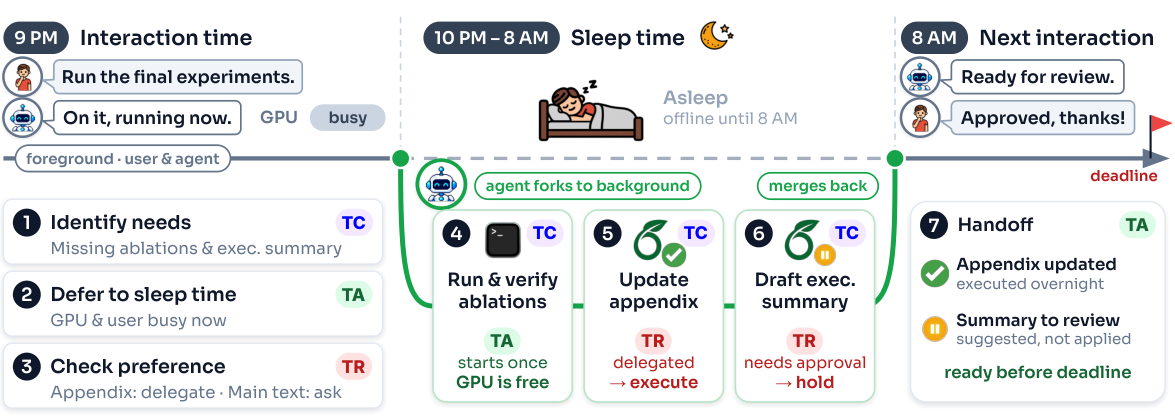
主动式 LLM Agent 能在用户开口前把闲置算力转化为有用支持,但即便工作正确,也可能误读用户情境、增加审查成本或损害信任。 本工作围绕三个协同原则(3T)提出设计、实现与评估基础:任务能力(预判相关需求并正确完成有用工作)、时间分配(按资源可用性与结果需求时机分配算力)、信任(维持用户信心与恰当依赖)。这些目标被映射到五维设计空间:任务范围、预判时域、激活触发、处理时机与介入深度,并配以所需的情境与系统建模(用户与环境表示、骨干 LLM、agent harness)。 作者提出 Proactivity-Gym:一个基于仿真的评测 testbed,含多日场景、有状态环境与 persona 条件的模拟用户,可跨多轮交互评估主动协助的后果。在 23 种 model-harness 配置上,评测暴露出 3T 上的显著性能差距,并发现 LLM judge 常将任务能力与信任混为一谈。 30 人人类研究显示联合优化 3T 的重要性:干预错配后参与者信任骤降(即便结果正确),且更偏好睡眠时间协助(即便不完美)以维持当前专注。结论支持以有用工作、算力分配与用户信任的联合考量来设计与评估主动式 agent。
论文精读
TL;DR 提出主动式 LLM 智能体的 3T 原则(任务能力、时间分配、信任)及 Proactivity-Gym 评估环境。证明仅结果正确仍可能损害信任,需联合优化三者。
问题
问题背景
LLM agents 正从响应式执行转向主动式服务,即在用户明确请求前利用空闲计算预判需求、提前完成有用工作。这一方向有望将 GPU 空闲时间转化为生产力。
现有方法局限
当前主动代理研究缺乏统一的设计原则:要么只关注任务完成质量,要么仅优化触发时机,缺少对信任的显式建模。具体技术局限包括:
- 用户上下文建模不足:即使任务结果正确,若未理解用户当前专注状态或环境约束,仍会引入额外审查成本,甚至破坏信任。
- 计算资源分配无规范:没有定义何时、以何种强度启动推理,导致要么过度打扰用户,要么浪费空闲算力。
- 评估基准碎片化:现有评测多为单轮、静态场景,缺乏多日、有状态环境和用户人格模拟,无法度量跨交互的信任演变。
为什么难/重要
主动代理必须同时优化三个相互制约的目标:任务能力(Task Capability)、时序分配(Temporal Allocation)、信任(Trust)。一个动作可能提高任务得分却损害信任,例如在用户专注时弹出通知。难点在于:系统需要在不确定的用户意图下做出长期决策,既要预测未来需求,又要估计用户对干预的容忍度。业界对主动 AI 的期待极高——它能显著降低用户认知负担,但一旦信任崩塌,用户会拒绝所有后续建议,形成负反馈循环。
行业类比
类似智能日程助手在用户睡眠时预先整理会议材料:如果预测准确且不打扰专注,体验极佳;如果错误地打断重要工作或生成无关内容,用户会直接关闭自动功能。
核心洞察
- 主动性 LLM agent 的价值必须通过任务能力、时间分配与信任三者的联合优化实现,而非仅追求任务正确率。以往 agent 评估多关注最终任务成功,忽略干预时机和用户信任的动态变化。本文通过人类研究发现,即使结果正确,不合时宜的主动干预也会导致信任骤降;反之,睡眠时间的非完美帮助却受欢迎,因为它不打断当前专注。这提示工程实践中需要将信任建模为随时间衰减或恢复的状态,而非静态指标。
- 模拟评估 Proactivity-Gym 揭示 LLM-as-a-judge 在主动性场景中将任务能力与信任混为一谈,导致自动化评估失真。该测试台引入多日情景、有状态环境和 persona 条件化模拟用户,能够追踪跨交互的后果。实验发现 23 个模型-框架配置在 3T 上表现差距显著,且 LLM 裁判给出的信任分数高估了真实用户信任。这对实际工程启示:主动性系统的离线评估不能依赖单一 judge,需要分离任务正确性与用户感知,并辅以人类受试验证。
方法
方法核心:3T 原则与 Proactivity-Gym 评估体系
输入:用户上下文(偏好、当前活动、历史行为)、环境状态(日历、设备、任务进度)、可用计算资源(空闲算力、时间窗口)。
关键模块:
3T 联合设计目标
- Task Capability:预测相关需求并正确执行有用任务。
- Temporal Allocation:根据资源可用性与结果需求时间分配计算。
- Trust:维持用户信心及对代理的适当依赖。
五维设计空间
界定主动行为的权衡维度:task scope(任务范围)、anticipation horizon(预测时间跨度)、activation trigger(激活条件)、processing timing(处理时机)、intervention depth(干预深度)。系统实现三要素
- 用户与环境表征
- 骨干 LLM
- Agent harness(工具/动作执行循环)
Proactivity-Gym 模拟测试平台
包含多日场景、有状态环境、基于 persona 的模拟用户,在长时间交互中评估主动协助的累积后果。度量指标围绕 3T 分解为TC(任务能力)、TA(时间分配)、TR(信任),并引入 LLM-as-a-Judge 自动评分。人类研究验证
30 名参与者证实 3T 联合优化的必要性:干预错位导致信任急剧下降,用户偏好睡眠时间协助以保持当前专注。
输出:主动代理在合适时机、以合适深度向用户交付有用工作(如报告草案、日程调整建议),同时维护用户信任。
与同类方法强调单一指标优化或仅关注任务成功率不同,本工作首次将信任演化与计算时间分配纳入主动代理的统一设计目标,并通过可复现的模拟环境进行系统性评估。
实验
实验设计
Proactivity-Gym 是一个模拟评估测试床,包含多日跨场景、有状态环境与 persona 驱动的模拟用户,用于评估 LLM 代理在 Task Capability (TC)、Temporal Allocation (TA)、Trust (TR-J) 上的表现。论文评估了 23 个模型-框架配置,并开展 30 人的人类研究,收集信任变化、时间分配偏好等主观反馈。
关键发现
评估显示不同配置在 3T 维度上差距显著,且 LLM-as-a-Judge 容易混淆任务能力与信任信号。人类研究进一步表明:即使代理输出正确,干预时机或方式错位也会导致用户信任急剧下降;参与者更偏好睡眠时间的后台辅助,即使结果不完美,以避免打断当前专注。
对比解读
与仅关注任务精度或响应速度的基线不同,该工作强调 3T 联合优化的必要性。单纯提升任务能力可能因不当干预而损害信任,而优化时间分配又需与任务相关性一致。结果表明,主动性代理设计需要在设计空间(任务范围、预期时域、激活触发、处理时机、干预深度)中权衡,而不能将各维度独立优化。
行业影响
落地场景
主动型 LLM agent 可嵌入智能办公套件、IDE 代码助手、电商客服与内容创作平台。例如,邮件客户端在用户空闲时自动分类并起草回复;代码助手夜间自动重构并生成测试;电商客服基于浏览历史主动推荐。论文的 Proactivity-Gym 提供模拟评估环境,可用于产品上线前验证五维设计空间。
商业价值
核心价值在于降低认知负担与优化算力分配。正确干预可减少用户等待,提升付费意愿;但错误干预会显著损害信任,导致用户弃用。据论文人类研究,睡眠时间协助即使不完美也更受偏好,说明时机选择比单纯准确率更重要。企业可通过 Temporal Allocation 在低峰期批量处理任务,降低云计算成本,同时维持用户体验。
接口与集成
现有 agent 框架(如 LangChain、AutoGen)可扩展主动决策模块。设计空间五维度(任务范围、预期视野、激活触发、处理时机、干预深度)可作为配置参数,结合用户与环境状态建模,接入编排器。Proactivity-Gym 可作为离线回归工具,在 CI/CD 中评估新配置的 3T 指标。
具体 use case
- 电商场景:客服 agent 在用户加购但未下单时,主动生成优惠券或搭配建议,触发条件设为高意图信号(如停留时长、比价行为),避免低价值打扰。
- 内容平台:创作者在夜间获得自动生成的视频脚本或文章大纲,次日审核,契合用户偏好睡眠时间协助,降低打断感。
局限
- **评估有效性的局限**:论文主要依赖模拟用户与 LLM-as-judge 评估,但两者均未完全验证对真实人类信任动态的保真度。虽然加入了 persona 与 stateful 环境,模拟用户行为模式仍受限于规则或 LLM 采样,且论文自认 LLM judge 在 Task Capability 与 Trust 上容易混淆,导致 Trust 评分出现偏差。人类研究仅 30 人、场景有限,难以支撑长期信任校准与干预对齐的普适结论。
- **框架可操作性的局限**:3T 原则与五维设计空间是概念性贡献,缺乏形式化数学定义或可优化的目标函数。Temporal Allocation 中的“资源可用性”与“结果需求时间”没有统一度量标准,不同实现差异显著。Proactivity-Gym 虽然提供了多日、有状态环境,但任务类型和场景数量有限,对于开放域个人助理的泛化性未知,与真实日常干扰的复杂性尚有差距。
- **交互与算法局限**:实验均假设单个 agent 与单个用户交互,未涉及多 agent 协作或群体用户动态;交互模式为回合制,未覆盖实时流式主动干预,而后者在真实部署中(如通知频率、打断时机)是核心挑战。此外,论文主要提供评估基准而非自动优化 3T 权衡的算法,人类研究揭示的 trust decline 与 sleep-time preference 未转化为可调节的 agent 策略。