E-MoE:面向非因子化扩散语言模型的增强型混合专家
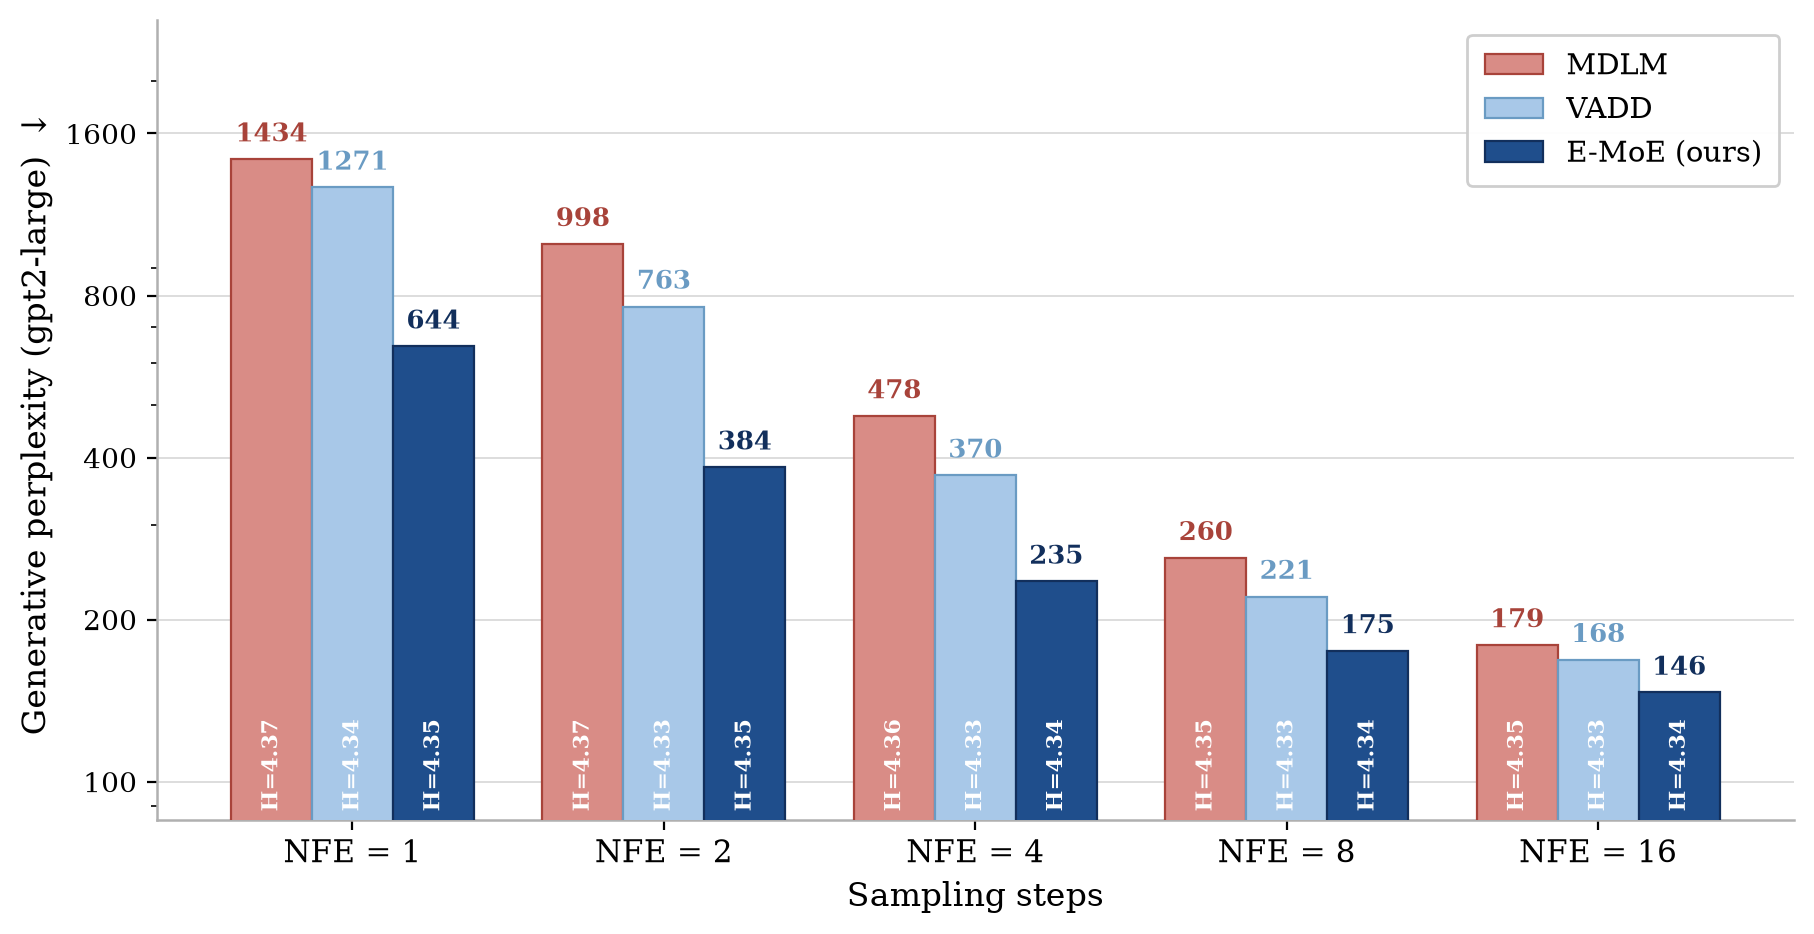
掩码扩散模型(MDMs)通过每步解掩蔽若干 token 来生成序列,但其反向过程通常在位置上做因子化处理,这限制了少步采样下的样本质量——而少步区间正是扩散相对自回归解码的速度优势最关键的场景。 近期研究引入连续高斯隐变量,以 VAE 方式训练来建模位置间的相关性,但此类方法容易出现后验坍缩,隐变量被静默忽略。 我们提出 Enhanced Mixture-of-Experts(E-MoE),它把反向过程建模为离散共享隐变量上的因子化分布之混合,该隐变量由 MoE 主干网络的专家路由决策给出,且相对因子化基线不增加激活参数量。 在合成多模态基准、二值化 MNIST 与 LM1B 上,E-MoE 相比因子化基线改善了少步生成效果。
论文精读
TL;DR **E-MoE** 利用 MoE 专家路由决策引入离散共享隐变量,使掩码扩散模型的反向过程非因子化,显著提升少步生成质量且不增加激活参数。
问题
Masked diffusion models (MDMs) 通过逐步去掩码生成序列,在推理时能并行解码,吸引了对 few-step 生成 的关注:少步去噪可大幅降低延迟,但需保持样本质量。
现有 MDMs 的 reverse process 大多在位置上 factorized,即每个 token 独立预测,忽略了 token 间依赖。在少步采样时,这种独立性假设导致模型无法覆盖多模态数据分布,生成质量显著下降。近期工作引入 continuous Gaussian latent 作为 VAE 潜变量来捕获位置间相关性,但此类方法容易发生 posterior collapse:潜变量被模型忽略,退化为普通的 factorized baseline,训练目标并未真正利用潜变量,且需要额外正则化或退火技巧,工程上不稳定。
难点在于为离散序列引入有效的共享潜变量。连续潜变量存在 collapse 风险,而 E-MoE 提出用 Mixture-of-Experts (MoE) 的专家路由决策作为离散共享潜变量,将 reverse process 构建为 factorized 分布的混合,不增加 active parameters,训练稳定。业界关注 few-step 扩散生成,因为它是扩散模型走向实际部署的关键瓶颈;E-MoE 提供了一种轻量、无额外计算开销的增强方案。
行业类比:类似流式语音合成中需要全局韵律规划来协调局部声学特征,E-MoE 的离散潜变量可视为全局生成规划器,指导每个位置的 token 预测。
核心洞察
- **E-MoE** 将 Mixture-of-Experts 的专家路由决策作为离散共享潜变量,在不增加 active 参数的前提下为掩码扩散模型反向过程引入非因子分解依赖。传统 MDM 反向过程因子分解导致少步采样质量受限,而连续高斯潜变量方法(如 VAE 变体)易发生后验坍塌。E-MoE 利用 MoE 路由本身产生的稀疏离散表征作为潜变量,混合多个因子分解分布,既保持计算效率又捕捉跨位置相关性,且路由网络在正常训练中就能有效利用该潜变量,无需额外正则化或编码器。
- **少步生成(few-step regime)** 是扩散模型相对自回归模型的速度优势区间,E-MoE 精准针对该场景优化。在低函数评估次数(NFE)下,因子分解反向过程难以在单步内生成多个依赖 token,而 E-MoE 的混合分布通过共享潜变量提供全局协调,显著提升样本质量。相比连续潜变量方法,E-MoE 的离散路由潜变量在训练中保持有效使用,避免了后验坍塌导致的退化。实验在合成多模态数据、二值化 MNIST 和 LM1B 上均表现出稳定的少步生成增益,验证了该机制在语言建模和图像生成中的通用性。
方法
输入与总体流程
E-MoE 作用于 Masked Diffusion Model (MDM) 的去噪反向过程。输入为带掩码的 token 序列(部分位置为 [MASK],部分为已知 token),模型需要在单步内预测所有掩码位置的 token 分布,逐步去掩码生成完整序列。
关键模块:离散共享潜在变量 + MoE 路由
传统 MDM 的反向过程在位置间做因子分解,即每个位置的预测独立进行,忽略 token 间相关性。E-MoE 的核心创新是引入一个离散共享潜在变量,由 Mixture-of-Experts (MoE) 骨干网络的路由决策给出。具体流程:
- 输入序列通过 MoE 骨干,每个位置的 token 经路由器选择 top-k 专家,该选择模式构成一个离散潜在变量(全局共享)。
- 在该潜在变量条件下,反向过程仍保持各位置的条件独立(因子分解),但不同位置共享同一潜在变量,从而捕捉跨位置相关性。
- 最终反向分布定义为不同潜在变量取值下的因子分解分布的混合,即多个因子分解分布的加权求和。
输出与训练
模型输出为每个掩码位置的 token 预测概率(用于逐步去掩码),训练使用变分下界(ELBO),但潜在变量是离散的,不需要重参数化或高斯先验。与连续高斯潜在变量的 VAE 方法相比,离散路由潜在变量避免 posterior collapse:路由决策是确定性的 top-k 选择,模型必须使用该潜在变量来最小化损失,因此不会像高斯潜在那样被忽略。
工程要点
- 参数效率:MoE 的专家路由直接复用骨干网络计算,不增加激活参数量(仅增加少量路由器参数)。
- 采样:可先采样离散潜在变量(路由模式),再在每个模式下按因子分解分布并行采样每个位置 token,保持与因子分解基线相似的推理速度。
与同类方法差异点:相比基于连续高斯潜在的 VAE 扩散语言模型,E-MoE 用离散 MoE 路由作为共享潜在变量,在不增加激活参数的前提下实现非因子化反向过程,且更抗 posterior collapse。
实验
实验设计
作者在三个基准上评估 E-MoE:
- 合成多模态数据集(二维玩具示例),用于验证模型捕捉多模态分布的能力。
- binarized MNIST:像素级图像生成,评估似然和生成质量。
- LM1B:文本生成,评估生成文本的 perplexity、MAUVE 等指标。
E-MoE 通过 MoE 骨干的专家路由决策获得离散共享潜变量,构建非因子化反向过程。训练采用类似 VAE 的变分下界优化,与因子化基线比较。
关键发现
- E-MoE 在 few-step 生成(少量去噪步骤)上优于因子化基线,而因子化基线在少步时因忽略位置间相关性导致质量下降。
- 相比连续潜变量方法,E-MoE 避免了 后验坍塌(posterior collapse),因为离散潜变量由专家路由自然产生,且路由决策在训练中被强制使用。
与基线对比解读
因子化基线在每个位置独立预测 token,位置间相关性仅通过 backbone 隐式建模,但在少步生成时由于反向过程近似误差累积,性能受限。E-MoE 通过混合因子化分布(每个专家对应一种潜变量状态)显式建模位置间依赖,且 不增加激活参数,在保持计算效率的同时提升少步生成质量,对实际部署中减少采样步数、降低推理成本具有工程意义。
行业影响
落地场景
E-MoE 适用于扩散语言模型 的低步数解码场景,如实时对话系统、代码补全、内容生成 API。在电商场景中,商品描述自动生成需要高吞吐和低延迟,少步采样 (4-8 步)能显著降低首 token 延迟;在内容平台,短视频标题/摘要生成同样依赖快速批量推理。E-MoE 通过 MoE 路由引入离散共享潜变量,缓解因子化假设导致的多样性和连贯性损失,使扩散模型在少步时也能产出可用的文本。
商业价值
- 降本:减少扩散步数直接降低 GPU 推理成本和能耗,对大规模文本生成服务尤为重要。
- 体验提升:提升少步生成质量可减少重试/后处理,提高用户留存。例如电商文案生成若质量不稳定,运营人员需大量人工修正;E-MoE 改善多样性可减少此类开销。
- 增收:更好的生成质量可支撑更多付费 API 调用,或提高广告文案点击率。
与现有工作流的接口
E-MoE 建立在 MoE 骨干 上,不增加 active parameters,因此可复用现有 MoE 大模型(如 Mixtral、DeepSeek-MoE)的权重和推理优化。集成时只需替换 reverse process 的分布计算:将专家路由概率作为离散潜变量的混合权重,采样时按路由分布采样专家并计算各专家因子化分布的加权和。这可以包装成自定义采样器,对接 vLLM、TensorRT-LLM 等推理框架,无需改动底层 kernel。对于已部署的扩散语言模型,可作为一次轻量微调或采样逻辑升级引入。
局限
- **可扩展性验证不足**:论文仅在 `binarized MNIST` 和 `LM1B` 等小规模数据集上验证,缺少在大规模语言模型(如数十亿参数)或更复杂文本语料上的实验。虽然理论上不增加 active parameters,但 MoE 路由网络的额外参数和训练复杂度并未在大模型上得到验证,其与现有扩散语言模型流水线的集成效果仍待观察。此外,离散共享 latent 的表达能力可能随序列长度增加而受限,需要更多专家或更深路由设计。
- **离散路由的稳定性与语义对齐问题**:将 MoE 的 expert-routing decisions 作为离散 latent,其路由过程通常由 top-k 选择或 argmax 产生,梯度传递需通过离散采样或 straight-through estimator,这可能导致训练不稳定或路由坍缩到少数专家。虽然避免了连续 VAE 的 posterior collapse,但可能引入新的模式崩溃或专家利用不均。论文未系统分析路由多样性或专家利用率,也未与连续 latent 方法在同等设置下直接对比采样质量和多样性。
- **与连续 VAE 方法相比的潜在损失**:相比使用连续 Gaussian latent 的 VAE 方法,E-MoE 的离散 latent 可能限制 latent 空间的平滑插值能力,使得在 latent 上做条件生成或可控采样更困难。同时,论文实验主要关注 few-step generation 的样本质量指标(如 BPD、Gen PPL),缺乏对生成多样性、语义一致性等更全面评估。此外,在 LM1B 上的文本生成结果可能受限于数据集规模,难以外推到开放式生成任务。