SkillGym:通过自动可验证环境生成训练技能使用 Agent
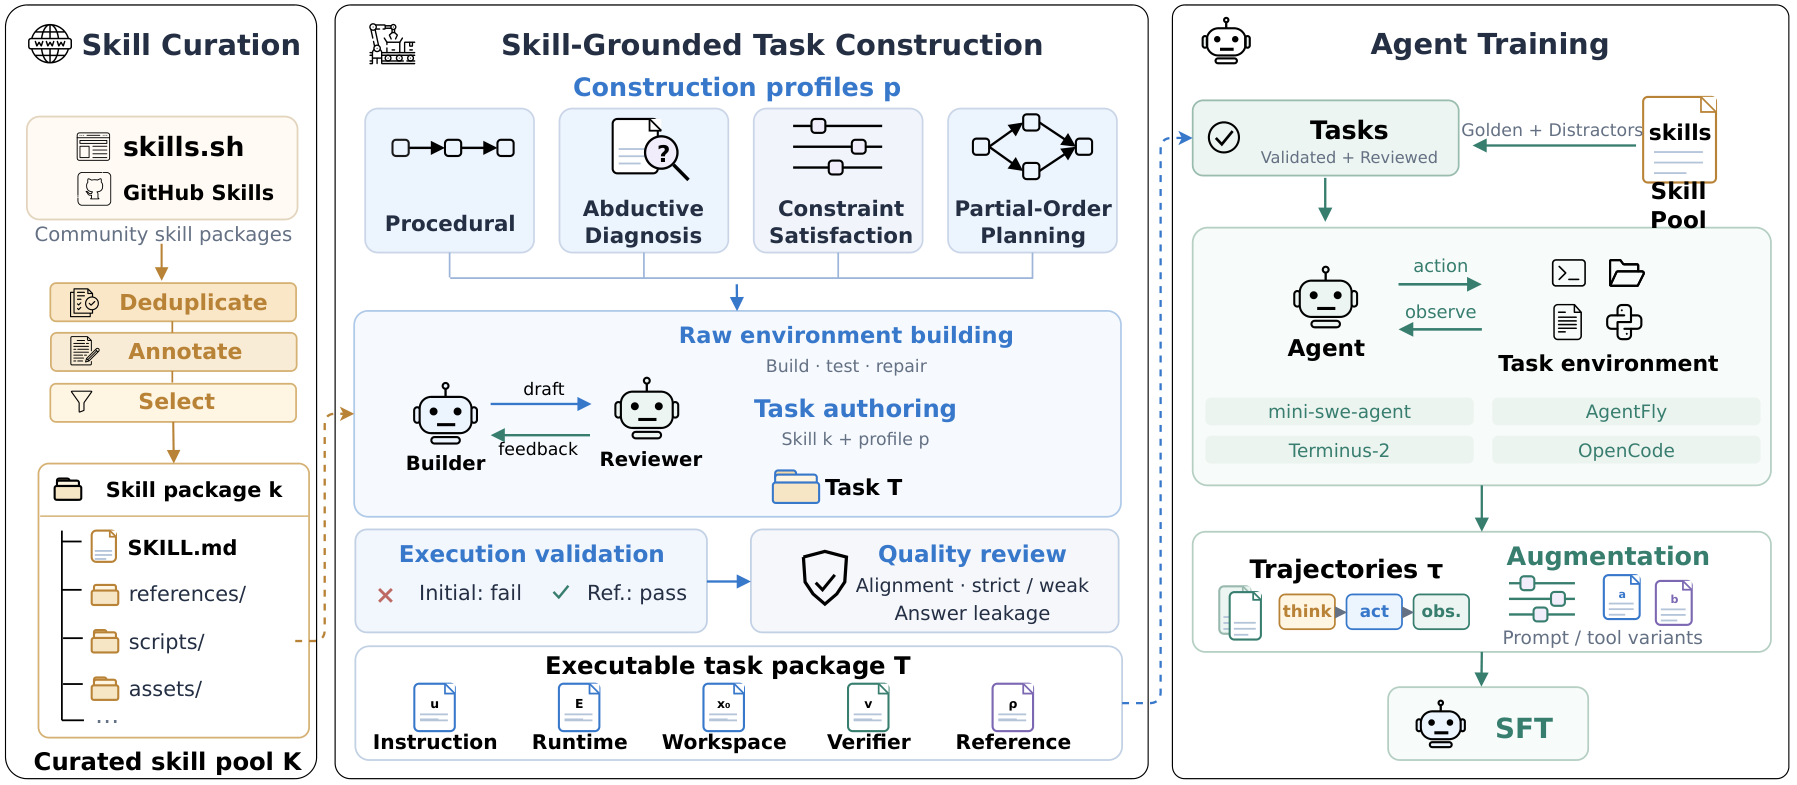
技能 为 LLM agent 提供了专业知识与指导,使其能完成长程复杂任务。尽管技能已被广泛用于各类 agent 范式与 harness,但如何合成可靠的训练数据、如何训练 agent 使用技能仍缺乏探索。 本文提出 SkillGym,一条自动流水线,用于构建可验证环境、采集轨迹并训练技能使用 agent。SkillGym 首先从互联网抓取大量技能,保留那些工作流可离线可复现运行的技能;随后通过 builder-reviewer 流水线构造难度可控的任务,覆盖 四类任务,每类均配有参考解与可执行 verifier。 基于该流水线,作者构建了 6.8k 个环境,采集 19k 条经验证的成功轨迹用于监督微调。在四个技能使用基准上,用这些轨迹微调可提升 2B 至 122B 参数的不同系列与规模 LLM;其中 Qwen3.5-9B SFT 模型在其中两个基准上超过 397B 未经训练的模型。 进一步分析表明,训练教会 agent 调用技能,将读取相关技能的比例从 28% 提升到 96%;增益在不同推理结构下均成立,并可泛化到仅占训练数据少数的任务类型以及训练中未出现的技能。
论文精读
TL;DR SkillGym 自动构造可验证环境并收集 19k 条成功轨迹,微调后让 2B-122B 模型学会主动调用技能,9B 模型在部分基准上超越 397B 大模型。
问题
问题背景
LLM agent 借助 skills 获得专业知识与操作指引,以完成长周期、复杂任务。技能已在主流 agent 框架(如 Anthropic 的 pptx / MCP skills)中广泛集成。
现有方法局限
尽管 skills 在推理阶段被大量采用,但如何合成可靠训练数据、如何训练 agent 有效调用技能,仍属欠探索方向。现有工作通常依赖:
- 人工构建有限环境,缺乏可扩展性;
- 任务不可验证,训练信号噪声大;
- 未控制任务难度,无法区分技能关键程度。 这导致 agent 在未见任务上倾向跳过技能阅读,直接猜测,调用率仅约 28%。
为什么这个问题难 / 重要
构建可验证环境的难点在于:技能来自互联网,工作流需能离线复现;任务需覆盖多种类型、具备参考解与可执行 verifier;训练数据需大规模、高质量。业界对 agent 技能使用的关注持续升温,但缺乏标准化的训练 pipeline。SkillGym 自动构建 6.8k 环境、收集 19k 验证成功轨迹,将技能调用率从 28% 提升至 96%,并让 9B SFT 模型在部分 benchmark 上超越 397B 未训练模型,证明训练能显著改善技能使用行为。
行业类比
类似为代码生成 agent 自动合成带单元测试的训练任务,SkillGym 为技能调用 agent 提供了可验证的环境生成器。
核心洞察
- SkillGym 的核心创新在于将“可复现离线运行”作为技能筛选标准,并自动构建带可执行验证器的任务环境,从而高效生成大量可靠的有监督轨迹。与以往依赖人工标注或仅基于真实环境的方法相比,它同时解决了训练数据在可验证性、规模和成本上的矛盾,使得从互联网海量技能中自动化构建训练集成为可能,为技能使用代理的训练提供了可扩展的数据管线。
- 训练带来的根本变化并非仅是任务成功率提升,而是代理行为模式的转变:模型学会了主动调用技能,相关技能阅读率从 28% 跃升至 96%,并且这种能力泛化到训练中未见的技能与少数任务类型。这表明模型习得的是一种通用的“技能使用”元能力,而非对特定技能的简单记忆,为设计更鲁棒的技能增强代理提供了训练目标上的启示。
方法
输入
SkillGym 从互联网爬取大量技能包(skill packages),这些技能包含任务指导、专业知识和可执行脚本。通过自动执行验证,仅保留工作流能够离线可复现运行的技能,剔除依赖在线服务或环境不确定的候选。
关键模块
- 技能筛选与标注:对爬取的技能进行可运行性检查,确保每个技能都能在隔离环境中稳定执行,并提取出对应的结构化工作流描述。
- 任务构建管道:采用 builder-reviewer 双阶段生成。Builder 根据技能内容构造难度可控的任务,覆盖四种任务类型;Reviewer 校验任务逻辑合理性,并为每个任务生成参考解决方案和可执行验证器。验证器能够自动判断任务是否成功完成。
- 轨迹收集:让 LLM 代理在生成的环境中执行任务,记录完整交互轨迹。只有通过验证器确认的轨迹才被保留,最终获得 6.8k 个环境和 19k 条验证成功轨迹。
- 监督微调:使用收集到的轨迹对 LLM 进行 SFT,训练其学会在合适时机调用技能、遵循技能指引完成任务。
输出
训练得到的技能使用代理,在四个技能使用基准上均表现提升;其中 Qwen3.5-9B SFT 模型在两个基准上超越 397B 参数的未训练模型。
跟同类方法的差异点
现有工作多依赖人工标注任务或静态数据集,而 SkillGym 首次实现从技能获取到环境生成、轨迹验证的全流程自动化,证明了大规模训练技能调用能力的可行性。
实验
实验设计
SkillGym 自动 pipeline 从互联网爬取技能,筛选可离线复现的工作流,通过 builder-reviewer 构建四类难度可控任务,每任务配有参考解和可执行验证器。构建 6.8k 环境,收集 19k 验证成功轨迹用于监督微调。在不同家族与规模(2B–122B)的 LLM 上进行微调,并在四个 skill-use 基准上评估。
关键发现
- 微调提升所有测试模型,Qwen3.5-9B SFT 在两个基准上超越 397B 未训练模型。
- 训练将技能阅读率从 28% 提升至 96%,表明模型学会主动调用技能。
- 增益跨推理结构泛化,对训练数据中占少数的任务类型和未见技能同样有效。
与基线对比
相比未训练的大参数模型,小模型经 SkillGym 轨迹微调后可在部分基准达到更优性能,说明高质量技能使用数据比单纯扩大模型规模更高效。与依赖人工构造环境的方法相比,自动化验证和难度控制大幅降低数据获取成本。
行业影响
落地场景
在企业级 Agent 平台(如客服自动化、RPA 流程执行、垂直领域助手)中,SkillGym 可为技能调用型 Agent 提供自动化训练数据合成。典型场景:电商运营 Agent 调用商品上下架、库存查询等 skill;内容平台审核 Agent 调用违规检测、标签生成 skill;金融流程 Agent 调用合规检查、报表生成 skill。这些场景均存在大量可复现的 tool/skill 工作流,适合用 SkillGym 构建带 verifier 的任务环境进行 SFT。
商业价值
核心价值在降本与体验提升:
- 数据标注成本:自动生成 6.8k 环境与 19k 成功轨迹,无需人工编写参考答案和验证器;
- 推理成本:训练后 Qwen3.5-9B SFT 在部分 benchmark 超过 397B 未训练模型,可在边缘或私有化部署中替代大模型,降低 token 成本;
- 任务成功率:skill 阅读率从 28% 提升至 96%,直接改善长链路任务完成率,减少用户反复交互。
跟现有产品/工作流的接口
SkillGym 输出的是 SFT 数据集 与 可执行验证器,可无缝接入主流 Agent 训练栈:
- 数据侧:将生成的轨迹转换为 OpenAI Chat 格式或 LlamaFactory 数据集,直接用于 LoRA/全参微调;
- Skill 侧:可与 Anthropic MCP、OpenAI Assistants 或 LangGraph 的 skill 库对接,作为 skill 选择的 reward 信号;
- 推理侧:微调后的模型可替换现有 Agent 框架中的 planner 模块,仅需保持 skill 接口一致。
对工程实践而言,SkillGym 证明了「无需人工标注,靠自动验证环境合成轨迹」在 skill-use 场景可规模化,是一条高性价比的数据飞轮路径。
局限
- 技能获取与过滤依赖“可离线复现”这一强约束,导致最终保留的技能分布偏向自包含、无需外部 API 或实时服务的脚本类技能,可能系统性排除大量现实世界中需要云服务、认证或动态数据的技能。这限制了训练数据的多样性,也使训练出的技能使用代理在面对需要外部交互或状态更新的技能时泛化能力存疑。
- 轨迹收集与验证器均由 LLM 或规则构建,虽然声称 verified successful,但验证器可能无法覆盖任务的全部语义正确性,尤其是开放式或需要人类判断的任务。合成轨迹可能包含模型偏好偏差,例如过度乐观的成功标注或捷径行为;作者未充分分析错误轨迹的分布和过滤阈值,可能影响 SFT 数据的质量上限。
- 实验仅在四个技能使用基准上评估,且这些基准本身可能同样来自合成或有限场景;虽然展示了从 2B 到 122B 的改进,但跨模型家族的提升程度不一致,部分情况下性能增益有限(如某些基准上提升较小)。此外,论文缺乏与更强基线的对比(如采用其他数据合成方法或 RL 训练),难以判断 SkillGym 相对于现有数据增强或环境生成框架的实际增益。