用 Night Science 强化科学构想中的智能体创造力
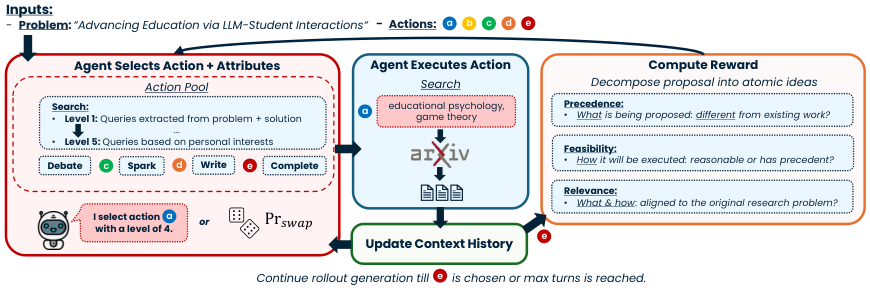
大语言模型(LLMs)擅长结构化、可验证的任务,但其低熵偏好往往导致输出同质化、可预测,限制了它们在开放式科学构想中的价值。而真正的科学发现涵盖更宽的创造谱系:从结构化的 day science 到松散、偶然的 night science,后者能触及常规思维之外的构想。 我们提出 AI Night-Scientist —— 一个智能体框架,用强化学习教模型判断何时、以及如何偏离可预测的推理路径。受认知科学启发,我们将创造力建模为三个维度: - 行动(做什么、以何种创造性去做) - 过程(何时探索、何时利用) - 结果(所产生构想的新颖性与实用性) 基于这三个维度,我们用 GRPO 训练模型,在训练全程让其接触不同程度与形式的创造力。相比基座模型,该方法生成的科学提案多样性显著提升:研究方向范围扩大 27.8%,贡献类型增加 14.9%;预测引用影响力最多提升 32.0 个百分点,原创性提升 66.2 分。 这些增益无法仅靠提高解码温度复现;相反,我们发现,明确“追求何种创造力”的语义引导至关重要。总体而言,结果表明创造力是一种可学习的多层能力,可被塑造,从而帮助研究者触及 LLMs 通常难以探索的构想。
论文精读
TL;DR 用 GRPO 强化学习训练科学假设生成智能体,教会模型何时偏离可预测推理(夜间科学);研究多样性 +27.8%、原创性 +66.2 分,且证明单靠升温无效,需要语义级创造力引导。
问题
问题背景:LLM 辅助科学研究正从文献检索、代码生成扩展到开放式研究构思(research ideation),目标是产出新颖且可行的科研提案。
现有方法局限:主流 LLM 在低熵解码下表现出强烈的模式坍缩,生成的研究方向与贡献类型高度同质化。常规做法如升高 temperature 只能提高表层词汇随机性,无法注入语义层面的创意方向;而现有 RLHF / DPO 优化主要针对有明确对错的可验证任务(如数学或代码),对“什么是好的开放创意”缺乏可分解的奖励信号,导致无法引导模型在何时跳出常规推理。
为什么这个问题难/重要:科学发现本身存在从 structured day science 到 loosely structured night science 的连续谱,创造力需要同时在动作层(做什么、怎么做)、过程层(何时探索 vs 利用)和结果层(新颖性与有用性)被刻画。单一指标难以评价,必须引入多级奖励与过程奖励;同时,科研灵感往往来自低概率的意外联想,与 LLM 的高概率偏好天然冲突。业界对 AI 辅助科研自动化关注度持续上升,但若模型只能复现主流路径,其价值有限。
行业类比:这类似于推荐系统仅利用热门内容会导致信息茧房,必须显式建模探索与新颖性来发现长尾兴趣。
核心洞察
- 将创造力建模为可优化的多轴强化学习目标,而非依赖解码参数或提示词工程。通过分离 action、process、outcome 三个维度,用 GRPO 显式训练模型何时偏离可预测推理,使多样性与质量同时提升;而仅提高 temperature 无法复现收益,证明低熵偏差的根源不是采样随机性,而是缺乏语义层面的创造性引导。
- 过程级奖励与结果级奖励对创造力维度的影响可分离:过程奖励更偏向原创性而非广度,说明探索-利用权衡可以在训练中独立调控。这为开放域生成任务的 RL 设计提供了新视角——不应只奖励最终输出的指标,而应奖励生成过程中的动作选择(如搜索、辩论、火花),从而塑造不同风格的创意行为。
方法
输入
研究主题或初始种子作为上下文,LLM 作为 agent 在科学提案生成任务中执行多步动作。基础动作空间包含 search、debate、spark、write 等,对应文献检索、观点辩论、灵感触发与提案撰写。
关键模块
多级创造力表示 基于认知科学,框架将创造力分解为三个轴:
- action 轴:决定每一步做什么以及动作的创造性程度(如搜索关键词的激进程度);
- process 轴:决定何时探索新方向、何时利用已有知识;
- outcome 轴:评估最终提案的新颖性与实用性。
强化学习训练 使用 GRPO(Group Relative Policy Optimization) 训练模型。奖励设计包含三个层次:
- 提案质量奖励:从相关性、可行性和先例引用等维度评估提案;
- 探索激励:奖励生成过程偏离常见模式的行为,鼓励偶然发现(serendipity);
- 过程级奖励:对探索得分和贡献得分进行细粒度建模,引导中间步骤。
训练时向模型暴露不同形式和程度的创造力,同时注入语义指导(例如指定追求"发散性"还是"跨界连接"),使模型学会根据上下文调整创造性策略。
输出
模型生成的研究提案在研究方向多样性上扩展 27.8%,贡献类型多样性提升 14.9%,且预测引用影响和原创性显著提高。
与仅提高解码温度的常见做法不同,本方法通过强化学习塑造了模型在何时偏离可预测推理的能力,而非简单增加随机性。
实验
实验设计:本文构建 AI Night-Scientist 框架,基于认知科学三轴(action / process / outcome)建模创造力,使用 GRPO 强化学习训练 LLM,生成开放式研究提案。数据集覆盖多领域,评估指标包括方向多样性、贡献类型多样性、预测引用影响与原创性。
关键发现:训练后模型在研究方向多样性上提升 +27.8%,贡献类型多样性提升 +14.9%,预测引用影响提升 32.0 个百分点,原创性提升 66.2 点。这些收益无法通过简单提高解码温度复现,说明并非随机发散,而是受控的创造性偏离。语义引导(指明追求哪种创造力)至关重要,过程级奖励更偏向提升原创性而非广度。
与基线对比解读:相对于基座模型(未经过创造力对齐 RL),AI Night-Scientist 同时改善了多样性与质量指标,证明创造力是可学习的多层级能力。仅增加温度会产生噪声而非有效探索;本框架通过组合动作、过程与结果奖励,实现“何时偏离、如何偏离”的策略学习。对实际工程的启示:开放式生成任务中,奖励设计需区分探索 vs 利用,并引入过程级信号以塑造行为分布。
行业影响
落地场景
AI Night-Scientist 框架可直接嵌入科研辅助软件、企业创新管理平台与垂直领域研发工具。典型场景包括:
- 药物早期发现:生成非保守的靶点假设或分子设计思路,扩大筛选空间。
- 材料科学:提出跨领域材料组合与合成路径,突破常规搜索。
- 企业战略/产品概念生成:从海量市场信号中产出多样化创新提案,避免同质化。
商业价值
核心价值来自 降低创意探索的人力成本 与 提高研发产出质量。论文显示,训练后模型在科学提案上:
- 研究思路多样性提升 27.8%,贡献类型多样性提升 14.9%;
- 预测引用影响最高提升 32.0 个百分点,原创性提升 66.2 点。
对企业而言,这意味着同等算力下可探索更多潜在方向,缩短从 idea 到可行概念的周期;同时通过引入“夜间科学”式发散,避免错过高价值非共识方向,潜在增收来自专利数量与转化率提升。
与现有产品/工作流的接口
该框架可作为 强化学习微调服务 或 模块化 Agent 插件 集成。具体路径:
- 在已有 LLMOps 平台(如 vLLM、Azure ML)上部署训练好的 policy 模型;
- 通过 API 接入科研项目管理软件(如 Benchling、Notion AI)或企业知识库,前端提供“创造力等级”参数选择;
- 将内部数据(实验记录、文献库、专利库)作为 reward 中的 precedence 与 feasibility 评分输入,实现持续对齐。
与同类工作的差异:相比单纯提高 decoding temperature,该方法通过语义级创造力指导(semantic guidance)实现可控探索,更适合需要稳定输出与审计的生产环境。
局限
- 论文自述存在**计算成本**与**训练稳定性**问题。使用 GRPO 进行多轮采样与多奖励模型(precedence、feasibility、relevance 等)训练,对 GPU 资源和调参要求较高,相比仅调整解码温度或提示词工程,工程复杂度显著增加。这限制了其在资源受限环境或快速原型阶段的直接应用。虽然论文证明单纯增加 temperature 无法复现效果,但引入完整 agentic RL 管线的运维与故障排查成本仍需纳入实际决策。此外,RL 训练中奖励 hacking 与策略退化风险未详细讨论,可能影响长期稳定性。
- 评价体系大量依赖**LLM 评判**(如 SciJudge)与模拟引用影响指标,尽管包含人工评估,但其可靠性与真实科学价值之间存在差距。原创性、可行性等维度由模型主观打分,可能引入偏差或过度奖励表面新颖性;预测引用影响基于历史数据,难以反映真正突破性想法。论文未验证这些指标与后续真实研究产出(如实际论文发表、引用)的相关性。因此,目前增益更多体现在自动化基准上,对于实际科研工作流的提升效果仍待长期观察。
- 实验基于特定学术语料构建的数据集,领域分布可能偏向计算机科学,对其他学科(如生物、物理)的泛化能力未充分测试。创造力三轴(action/process/outcome)的建模虽借鉴认知科学,但实际科学发现过程高度非线性且依赖隐性知识,奖励设计中 serendipitous actions 与 precedence reward 可能过于简化,无法全面捕捉所谓“night science”的复杂性。此外,研究提案生成任务与实际科研决策仍有距离,框架在真实协作场景下的表现需要进一步验证。