WM-VLM: 探究用于图文交错推理的内部世界模型
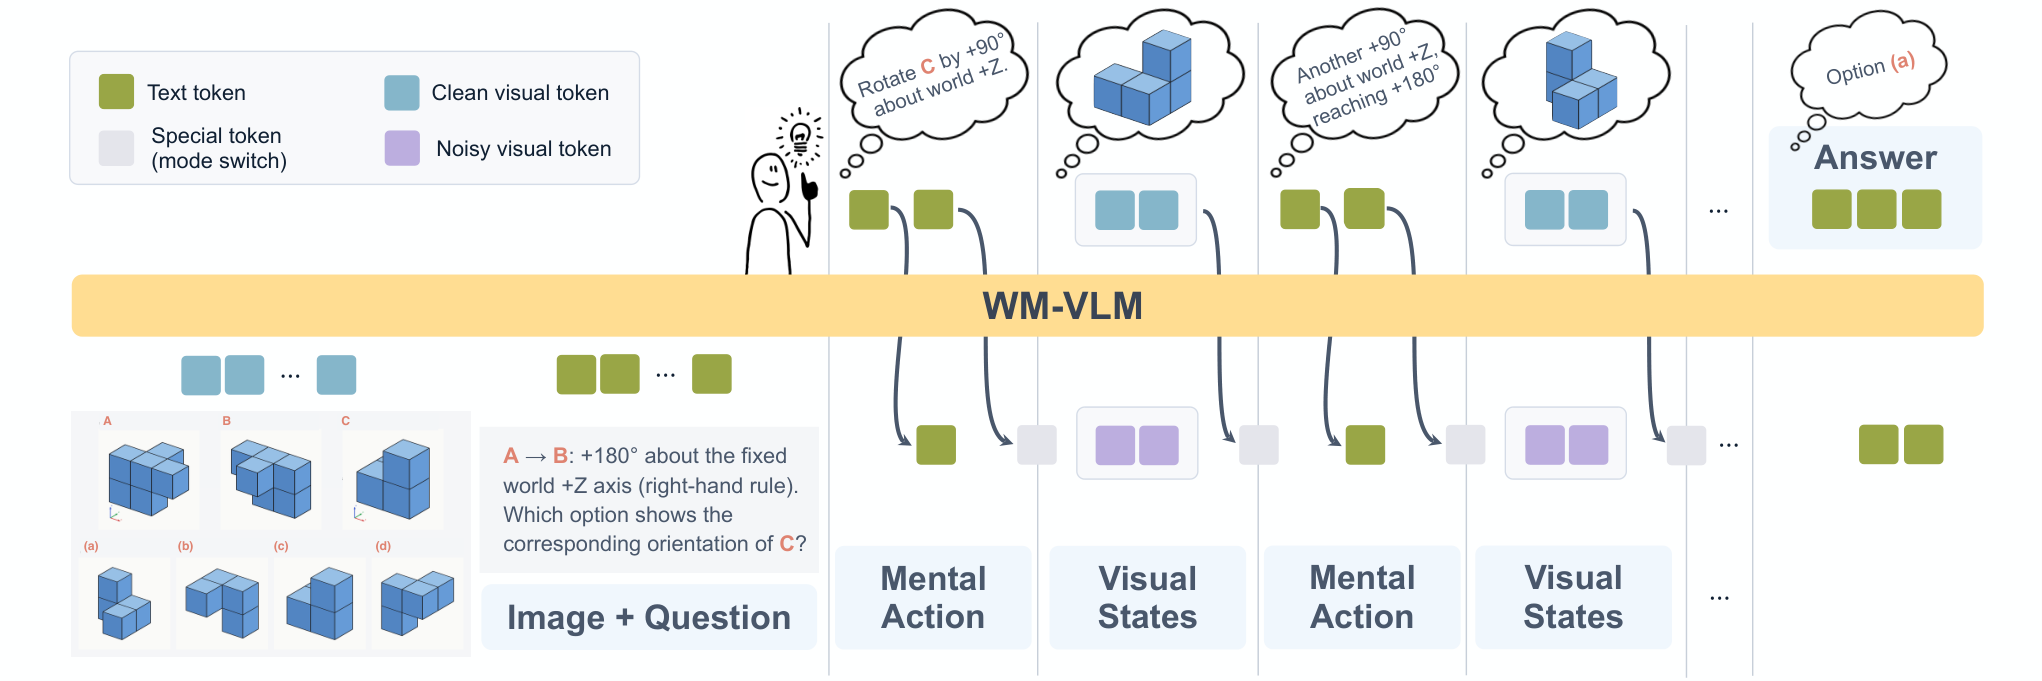
人类常通过在心智中模拟视觉变换来解决空间问题,而传统 vision-language models(VLM) 主要依赖语言进行推理。本文探究 VLM 能否结合文本与生成的视觉状态来解决空间问题。为此,我们提出 WM-VLM,为预训练 VLM 配备一个轻量的 world model 分支,用于生成中间视觉状态。 训练分为两个阶段:首先教会模型生成下一个视觉状态,然后让它利用该状态进行推理。我们以程序化方式构造带有可验证中间视觉状态的空间推理任务,从而能够评估模型生成视觉状态的质量,以及它在多大程度上依赖这些状态来回答问题。 在 2D 与 3D 心理旋转任务上,WM-VLM 一致优于有监督微调的骨干模型,提升幅度最高达 39.25 个百分点。消融实验表明,这些增益依赖于所生成的视觉状态——移除或破坏这些状态会显著降低性能。 综上,结果表明内部世界模型为构建同时以语言和视觉空间进行推理的 VLM 提供了一条有前景的路径。
论文精读
TL;DR WM-VLM 给 VLM 加装轻量世界模型分支,先生成中间视觉状态再推理,在 2D/3D 心理旋转任务上最高提升 39.25 个百分点,证明视觉模拟能显著增强空间推理。
问题
问题背景
当前视觉-语言模型(VLMs)在空间推理任务上主要依赖语言作为推理中介,鲜有显式生成并利用中间视觉状态。
现有方法局限
传统 VLMs 通常将图像编码为 patch 序列后,在 Transformer 内部通过 attention 隐式融合视觉与文本,推理链以文本 token 为主。这种设计缺乏对视觉变换的逐步模拟,难以处理需要“在头脑中旋转物体”的任务(如 2D/3D 心理旋转)。即使通过监督微调(SFT)提升任务表现,模型仍可能仅学习文本层面的模式匹配,缺少可验证的视觉状态序列,导致推理过程不可解释,泛化性存疑。
为什么这个问题难/重要
空间推理要求模型具备在连续视觉空间模拟变换的能力,这需要同时解决两件事:1) 生成合理的下一视觉状态;2) 让模型在生成状态之上进行后续推理。技术上,引入生成分支会增加训练难度,且模型可能忽略生成状态,只用原始文本捷径作答。此外,如何验证生成的中间状态是否忠实于真实变换,也是一个挑战。业界对“世界模型”在 VLM 中的应用关注度上升,认为其能增强具身智能与规划能力,因此该问题兼具理论与工程价值。
行业类比
类似自动驾驶中的预测模块,系统需要先预测未来占用栅格(occupancy grid),再基于该预测做决策,而不是仅仅依靠语言描述路况。
核心洞察
- 将世界模型作为 VLM 内部视觉状态生成分支,使推理在视觉-文本交错空间中进行,突破了纯语言推理的局限。传统 VLM 通常以语言作为唯一中间表示(如 chain-of-thought),难以处理需要空间想象的任务。WM-VLM 引入轻量 world model 分支,预测下一步视觉状态,并让模型利用该状态进行联合推理。这一设计模拟人类心理旋转过程,为空间推理提供了视觉锚点,而不是仅在文本层面描述变换。与同类工作相比,它直接操作像素级表示,从而在 2D/3D mental rotation 任务上获得显著提升(最高 +39.25 个百分点)。
- 两阶段训练和可验证中间状态的程序化任务构造,提供了模型确实依赖于生成视觉状态的因果证据,而不仅仅是相关关系。许多多模态推理工作只报告最终精度,无法证明中间生成物是否被有效利用。本文先训练模型生成下一视觉状态,再训练利用该状态推理,并在消融中通过移除或破坏生成状态观察性能急剧下降,证实了视觉状态的因果作用。这种实验设计分离了生成质量和利用能力,为评估内部世界模型的贡献提供了严谨框架。特别是程序化构造的 Tetris-2D 和 Tetris-3D 任务,带有可验证的中间状态,使研究者能够量化模型对视觉 tokens 的依赖程度。
方法
输入与任务构建
- 程序化构造 2D/3D 心理旋转任务(
Tetris-2D/Tetris-3D),每个样本包含自然语言问题、初始视觉状态、可验证的中间视觉状态序列与最终答案。 - 中间状态有 ground truth,可独立评估生成质量与推理依赖度。
关键模块:WM-VLM 架构
- 在预训练 VLM 基础上增加一个轻量 world model 分支。该分支接收当前视觉状态,通过 rectified flow 采样生成下一中间视觉状态的 visual tokens。
- 生成的 visual tokens 以 interleaved 方式插入文本 token 序列,共同进入 LLM decoder 进行推理。
两阶段训练
- Stage 1 世界建模阶段:只训练 world model 分支,用生成损失(如 flow matching 噪声预测损失)使预测的中间视觉状态逼近 ground truth,目标是学会“想象”变换结果。
- Stage 2 推理微调阶段:联合训练 world model 与 VLM,用交叉熵损失优化最终答案预测。梯度会反向传播到 world model,促使它生成对下游推理更有用的中间视觉表示。
输出
- 最终答案 + 完整中间视觉状态序列,可与 ground truth 逐帧比对,用于诊断模型是否真正依赖内部视觉模拟。
关键实验证据:移除或破坏生成的 visual tokens 会导致性能大幅下降,说明模型确实使用了内部世界模型,而不是纯文本捷径。
与同类方法的差异点:相比纯文本 CoT 或调用外部图像生成器,WM-VLM 将世界模型作为 VLM 内部可训练组件,在视觉 token 空间进行隐式状态推演,避免了语言描述带来的信息瓶颈。
实验
实验设计
- 任务构建: 程序化生成 2D / 3D 心理旋转 任务(Tetris-2D 与 Tetris-3D),中间视觉状态可验证。
- 模型架构: 预训练 VLM 增加轻量 world model 分支,用于生成中间视觉状态。
- 训练流程: 两阶段训练——Stage1 训练模型预测下一视觉状态;Stage2 利用生成的视觉状态辅助推理。
- 评估维度: 生成状态质量 + 模型对生成视觉状态的依赖程度(通过移除/破坏生成状态观察性能变化)。
关键发现
- 性能增益显著: 在 2D 和 3D 心理旋转任务上,WM-VLM 相对 SFT 微调 backbone 最高提升 39.25 个百分点。
- 增益依赖生成状态: 消融实验移除或破坏生成的视觉 tokens 后性能大幅下降,证明内部世界模型是增益来源。
- 生成能力本身有效: 世界建模目标(预测下一视觉状态)本身提高了需要想象力的任务性能。
- 视觉 vs 文本媒介: 论文探讨了生成视觉 tokens 的数量、Stage2 损失比例、两阶段训练必要性、生成层数量/位置等细节。
对比解读
- 相对于仅做 SFT 的 VLM,WM-VLM 通过引入可微的视觉状态生成分支,显式建模中间状态,避免了纯语言推理的瓶颈。
- 与一些隐式内部推理方法(如思维链)不同,WM-VLM 将中间状态显式化为像素级 tokens,直接受视觉损失监督,更贴近人类心理模拟机制。
- 消融强调生成视觉状态的重要性,说明增益不是来自额外参数或训练信号,而是来自正确的推理媒介。
行业影响
落地场景
WM-VLM 的内建世界模型分支让 VLM 在语言之外生成并利用中间视觉状态,适合需要空间推理与模拟的产品:
- 电商 / 家居:商品摆放助手、房间布局规划;模型可生成家具移动后的中间视图,并回答“这个沙发能否通过门口?”
- 工业设计 / 自动驾驶:CAD 装配验证、机械臂路径规划中的碰撞检查;自动驾驶中预测障碍物未来轨迹并生成可视化中间帧。
商业价值
- 降本:用轻量生成分支替代物理仿真引擎或人工标注中间状态。
- 增效与体验:用户可看到中间视觉推理过程,提升可解释性与信任;在教育 / 客服中提供可视化解题步骤,降低沟通成本。
- 新收入:输出带中间状态的推理过程可作为增值 API 或订阅功能。
与现有工作流的接口
- 模型侧:基于预训练 VLM(如 LLaVA / Qwen-VL)加装世界模型分支,两阶段训练(先生成下一视觉状态,再联合推理),复用现有微调框架。
- 部署:中间视觉状态由
rectified flow采样生成,可作为 tokens 插入视觉序列;推理时可选关闭生成分支以降延迟。 - 产品侧:输出结构可包含
final_answer与intermediate_states(图像或 token 序列),便于前端渲染分步推理。
局限
- **任务设定局限**:论文在程序化构造的 **Tetris-2D / Tetris-3D** 空间推理任务上验证 WM-VLM,中间视觉状态可通过规则精确生成并验证。然而真实世界图像中的空间推理(如机械装配、场景导航)包含噪声、遮挡与语义歧义,模型能否生成有意义的中间视觉状态未知。且任务类型局限于心理旋转,未覆盖更广泛的空间操作(如折叠、拼接),限制了结论的普适性。
- **生成状态可靠性未充分验证**:论文通过消融证明生成视觉状态对推理有贡献,但未量化生成内容的质量——错误或偏离真实状态的中间图像是否会导致误导性推理并未讨论。世界模型分支为轻量设计,生成分辨率低且仅用 **Rectified Flow** 训练,与专用生成模型(如 Stable Diffusion)相比保真度有限。缺少生成状态的定量评估指标(如 FID、LPIPS)或人工评测。
- **对比基线薄弱**:实验仅与 **SFT 骨干**做对比,未纳入已有的 interleaved visual-textual reasoning 方法(如 **Visual Chain-of-Thought**、**IMMA**)或其他显式世界模型方案。无法判断增益源于生成视觉状态这一设计本身,还是两阶段训练带来的额外正则化。此外仅在两个合成数据集上测试,缺少真实图像基准(如 **CLEVR**、**VSR**),泛化能力存疑。