SeLMRoute:面向大语言模型路由的概率化语义证据
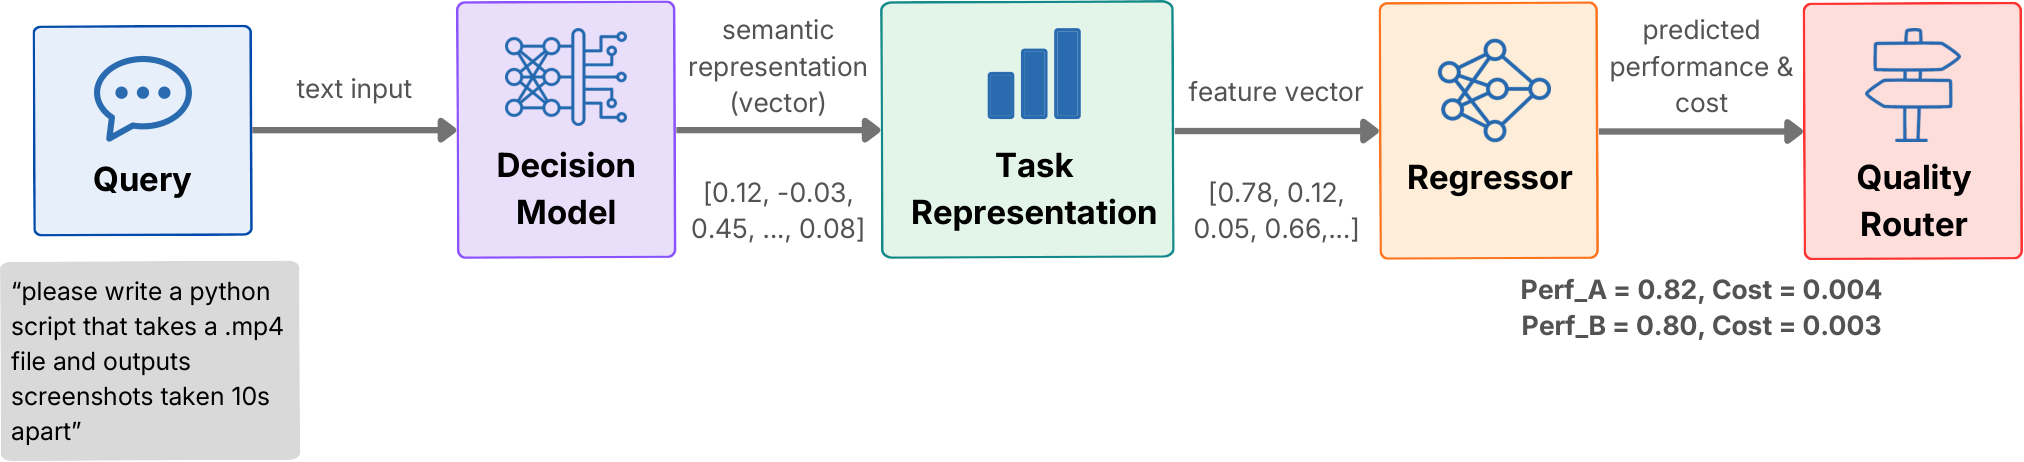
LLM 路由(routing)旨在为每个到来的 query 选择最合适的模型。现有路由器大多直接从 query embedding、模型表示、偏好数据或相似样本聚类中学习这一决策。这类方法虽然有效,但用于路由的表示很少明确说明一个 query 究竟需要什么。 我们提出 SeLMRoute,一个将「候选无关语义证据的抽取」与「候选性能学习」及「部署目标的应用」相分离的路由框架。 - 语义证据抽取:决策模型首先对 query 的一组可解释问题(如推理需求、外部知识使用)作出判断,每个判断以概率分布的形式保留。 - 性能估计:所得的概率化语义状态 由一个轻量监督路由器用于估计候选模型的性能。 - 目标应用:路由目标在性能估计之后施加,使同一语义状态可同时支持性能导向与成本感知的决策。 在 LLMRouterBench(15 个数据集、20 个候选模型、11,481 条 query)上,SeLMRoute 取得 72.08% ± 0.45 的平均准确率,分组五折 out-of-fold 评估达 72.64%,而最强的固定候选为 69.23%。在评估的语义、稠密、词法与领域级表示中,该表示取得最高平均性能。在另一个 13 模型的性能-成本设定中,SeLMRoute 在全部五个分组划分上均有提升,平均 PerfGain 为 2.66%。代码见 https://github.com/Indigma-Innovations/SeLMRoute 。
论文精读
TL;DR SeLMRoute 通过提取查询的可解释概率语义证据(如推理深度、知识需求)来路由 LLM,在 LLMRouterBench 上准确率达 72.08%,超过最强固定模型的 69.23%,同时支持成本感知决策。
问题
当前 LLM routing 领域聚焦于在多个候选大语言模型之间动态分配查询,以在性能与成本之间取得平衡。实际部署中,不同模型擅长不同任务,单模型难以覆盖所有查询类型。
现有路由器大多直接从 query embedding、model representations、preference data 或相似样本聚类中学习决策映射。这类表示隐含地编码了查询特征,但很少显式陈述查询真正需要什么——例如是否需要多步推理、外部知识或长上下文理解。同时,路由决策与部署目标(性能最优或成本受限)耦合,难以在同一表示上灵活切换目标。此外,硬性能力标签丢失不确定性信息,无法刻画查询的边际需求。
挑战在于查询需求具有高维度和模糊性,候选模型能力分布差异大,准确估计每个查询在各模型上的相对表现需要可解释、可泛化的中间表示。业界关注度高是因为 LLM 推理成本昂贵,而模型间的性能差异可达数十个百分点,路由系统可以显著提升性价比。此外,路由目标需要适应动态业务约束,如延迟、预算、吞吐量,因此将语义证据与目标解耦成为关键设计。
这类似于 API 网关根据请求的路径、方法和负载特征动态路由到不同后端服务,既保证满足服务等级协议,又控制资源消耗;或者像数据库查询优化器根据查询计划选择不同的执行引擎。
核心洞察
- 将查询需求显式编码为候选无关的概率语义状态,而非从隐式表示或偏好数据直接学习路由决策。现有的 query embedding 路由、偏好学习路由或 cluster 路由通常只学习“哪个模型历史上赢过类似查询”,但没有明确表示查询在推理强度、外部知识、代码生成等方面的实际要求。SeLMRoute 通过一组可解释问题获得概率分布,让路由依据“查询需要什么”而不是“哪个模型被选过”,从而提升对 OOD 查询和跨候选模型的泛化能力。
- 将性能估计与路由目标解耦,使同一个语义状态可以同时支持性能导向和成本感知的路由决策。传统端到端路由器通常把成本、延迟等约束直接编码进训练目标或推理规则,切换部署目标需要重新训练或调整阈值。SeLMRoute 先估计候选模型性能,再应用用户配置的目标函数,因此可以在不改变语义证据提取和性能学习模块的前提下,动态切换从“选最强模型”到“在预算下选最优模型”等策略,显著降低多目标运维成本。
方法
输入与流程概览
输入为用户查询 query。SeLMRoute 将路由拆分为三个阶段:语义证据提取 → 性能学习 → 目标应用,其中语义提取与候选模型无关。
关键模块
- 语义证据提取:一个决策模型对每个查询评估一组可解释问题(如推理复杂度、是否需要外部知识、指令遵循难度等),每项判断输出概率分布而非硬标签,形成 概率语义状态(probabilistic semantic state)。这一步捕捉查询真正需要的能力,且与候选 LLM 集合解耦。
- 性能学习器:轻量级监督路由器接收上述语义状态,为每个候选模型估计其在该查询上的预期性能(如正确率)。学习器只在语义状态上训练,不直接访问原始查询或模型内部表示,从而保持可解释性。
- 路由目标应用:在得到性能估计后,再根据部署目标做决策。若只追求准确率,选性能最高者;若考虑成本,可在性能阈值内选择更便宜模型。由于目标与性能估计分离,同一语义状态可复用。
输出
最终输出为一个候选模型或排序,直接服务查询。
与同类方法差异:现有路由器多从查询嵌入、模型表示或偏好数据端到端学习决策,特征隐式且不表达查询需求;SeLMRoute 用显式概率语义证据作为中间表征,实现了可解释、可迁移且目标可配置的路由。
实验
实验设计
SeLMRoute 在 LLMRouterBench 基准上评估,覆盖 15 个数据集、20 个候选模型、11,481 个查询。采用分组五折 out-of-fold 协议,防止同 query 族泄漏。框架先提取查询的 概率语义证据(可解释问题判断),再学习候选性能,最后应用路由目标。
关键发现
- SeLMRoute 平均准确率 72.08% ± 0.45,分组五折 out-of-fold 72.64%,超过 最强固定候选 69.23%。
- 该表示在语义、稠密、词法、领域级表示中达到最高平均性能。
- 在 13 模型性能-成本设置中,所有五个分组拆分均获提升,平均
PerfGain为 2.66%。
深度解读
与直接学习路由决策的方法相比,SeLMRoute 的中间语义状态提供可解释性和目标解耦,允许同一状态支持性能导向与成本导向路由。性能提升幅度相对固定候选约 3 个百分点,实际价值取决于部署场景的成本敏感度。语义证据抽取的额外算力成本需在工程中权衡,尤其在高吞吐场景下应评估其延迟影响。
行业影响
落地场景
- LLM 网关与多模型路由:适用于同时部署多个大模型(如 GPT-4、Claude、Llama 3、Mistral)的云服务或企业内部平台,根据查询语义动态选择最优模型。
- 成本敏感型 AI 应用:如客服机器人、内容审核、RAG 系统等,需要平衡性能与推理成本。
- 可解释性要求高的场景:金融、医疗等对决策可追溯性有要求的业务,SeLMRoute 的语义证据提供可审计的路由理由。
具体 use case:电商平台的智能客服系统,将查询分为简单 FAQ(用轻量模型)、复杂售后推理(用旗舰模型);内容平台的自动摘要与推荐,根据文章复杂度选择不同规模模型。
商业价值
- 降本:通过将简单查询路由到低成本模型,可显著降低推理 token 费用(如简单查询占比高时,成本下降 30-50%)。
- 体验提升:对复杂查询选择更强模型,减少回答错误,提高用户满意度与留存。
- 性能增强:相比固定使用最强模型,平均准确率提升(论文中 72.08% vs 69.23%),同时保持成本可控。
与现有产品/工作流的接口
- 轻量集成:SeLMRoute 可作为推理网关或模型服务层的前置插件,输入查询,输出模型 ID 与置信度。
- 与 LLM 框架集成:支持 LangChain、LlamaIndex 等,通过自定义 Router 组件调用 SeLMRoute 的决策模型。
- 与监控系统配合:语义状态可导出至日志或监控工具(如 LangSmith、W&B),用于后续分析与调优。
- 部署灵活:决策模型与性能学习器均可独立训练与更新,便于持续迭代。
局限
- 语义提取依赖额外的决策模型(可能是大型语言模型)进行可解释问题的概率判断,这引入了额外的推理延迟和计算成本。虽然论文在 4.12 和 4.13 节分析了美元成本和系统开销,但与直接使用查询嵌入的轻量路由器相比,部署复杂度和资源需求明显更高,可能不适合对实时性要求极高的在线服务或边缘设备场景。
- 可解释语义问题集是人工预先定义的,覆盖范围有限,难以穷举所有影响路由决策的因素;决策模型对问题判断的概率分布本身带有不确定性,若出现系统性偏差或错误,会传播到后续性能估计和路由决策中。此外,该框架需要额外训练一个监督路由器来学习语义状态到候选性能的映射,训练数据质量和分布可能影响泛化。
- 在 LLMRouterBench 上的准确率提升相对最强固定模型仅约 2.85 个百分点(72.08% vs 69.23%),绝对收益有限;且实验集中在特定基准,真实生产环境中的分布漂移和未知模型组合尚未充分评估。与一些基于嵌入的零样本路由器相比,该方法需要训练阶段,启动成本较高,限制了快速迭代和跨域迁移的灵活性。