RLE-Bench: 面向机器人学习工程师编码智能体的资格考试
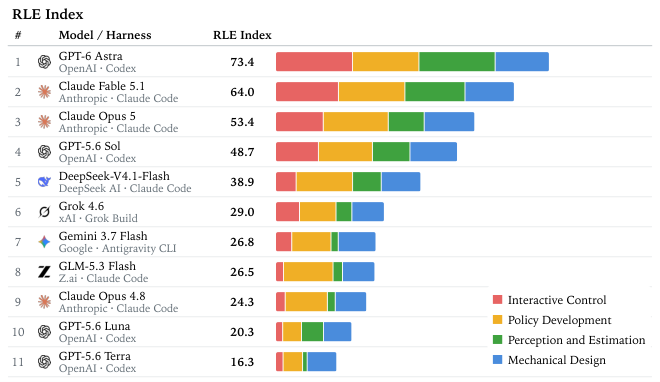
编码智能体正开始超越纯数字任务,转向攻克物理世界挑战,机器人领域尤为典型。然而,现有机器人基准大多只关注单个产物(如策略或控制器)的性能,对编码智能体更广泛的工程能力覆盖有限。真实机器人开发远不止控制:agent 需在资源约束下构建、集成、诊断并改进异构产物,并从多模态反馈中进行推理。 为评估这些更广泛的能力,我们提出 RLE-Bench,一个覆盖四类代表性机器人开发工作流的基准: 1. 交互控制(interactive control) 2. 策略学习(policy learning) 3. 感知与估计(perception and estimation) 4. 机械设计(mechanical design) 我们采用多样化的任务特定指标来评估编码智能体提交的产物,涵盖智能体达到的成功率、训练出的 policy agent、构建的 harness、设计的机械结构等。这些指标被聚合为 RLE Index,并生成各工作流的能力画像,从而支持在多维度上系统比较编码智能体的能力。 除性能排名外,我们还针对代表性任务开展深入案例分析,考察智能体的行为,既揭示其当前能力与局限,也指出机器人任务为未来智能体训练所提供的机遇。
论文精读
TL;DR RLE-Bench 是首个面向机器人学习工程师能力的编码代理基准,覆盖交互控制、策略学习、感知估计与机械设计四类工作流,用 RLE Index 量化代理工程综合实力,揭示与人类差距。
问题
问题背景
Coding agents 正在从纯数字任务扩展到物理世界的机器人开发,这要求代理具备超越单一模型训练的综合工程能力。
现有方法局限
现有机器人基准主要评估单个工件的性能,例如策略成功率、控制器跟踪误差。它们把代理视为“策略生成器”或“控制器调参器”,无法覆盖真实机器人工程项目中的关键环节:
- 无法评估代理整合异构组件的能力,如将感知模块与控制模块联合调试;
- 缺少对资源约束下设计决策的考核,例如计算预算、传感器精度、执行器噪声;
- 不要求代理诊断与迭代改进已有系统;
- 忽略对多模态反馈(视觉、力觉、点云)的推理能力。
因此,现有基准无法给出编码代理在机器人领域的工程能力剖面,难以反映其胜任“机器人学习工程师”角色的程度。
为什么这个问题难/重要
真实机器人开发远不止训练一个策略:代理需要理解任务规范,构建测试框架(harness),处理传感器标定、域随机化、系统集成等工程细节。这些步骤非线性、反馈稀疏,且交互控制、策略学习、感知估计、机械设计等工作流要求不同的专业知识和评估协议。业界对能在物理世界自主迭代的代理有强烈需求,但缺少统一且多维度的能力评测基准,导致模型迭代缺乏明确方向。
行业类比
类似 SWE-bench 为软件工程代理提供代码补丁与单元测试的标准化评估,RLE-Bench 试图为机器人工程代理提供一场“资格考”,只不过考核对象从纯代码仓库扩展到需要在仿真或真实反馈中闭环优化的工程系统。
核心洞察
- **RLE-Bench 将 coding agent 评估从单一 artifact 性能推进到机器人工程全流程,填补了 SWE-bench 与策略评估之间的空白。** 现有机器人基准如 SIMPLER 仅测策略成功率,SWE-bench 只测软件任务,而 RLE-Bench 通过四个工作流(交互控制、策略学习、感知估计、机械设计)要求 agent 在资源约束下构建、集成、诊断多个异构 artifacts,并用 RLE Index 聚合任务特定指标。这种设计更接近真实机器人研发中多角色、多模态反馈的工程挑战,为横向比较 agent 的工程能力提供了维度化剖面。
- **RLE-Bench 的案例研究揭示了 coding agents 在物理世界任务中的独特短板:善于生成代码,但难以从多模态传感器反馈中诊断物理交互失败,且在计算预算约束下缺乏有效的设计权衡。** 与纯数字 SWE 任务相比,RLE-Bench 要求 agent 在仿真环境中迭代试错,这使得只有代码合成能力不足以获得高分。该发现为后续 agent 训练提供了明确信号:需强化物理推理、诊断式探索与成本意识,而不仅仅是扩大代码语料或模型规模。
方法
方法概览
RLE-Bench 是一个面向 coding agents 的机器人学习工程基准,旨在评估智能体在真实机器人开发工作流中的综合能力。
输入 → 关键模块 → 输出
输入:给定一组机器人学习任务,覆盖四种代表性工作流:
- 交互控制(
Family01-03) - 策略学习(
Family04-05) - 感知与估计(
Family06-07) - 机械设计 每个任务要求 agent 提交可执行的 artifacts(如控制器、训练策略、评估 harness 或机械结构设计),并在资源约束下通过多模态反馈迭代改进。
- 交互控制(
关键模块:
- 任务与评估设置:每个工作流包含多个任务族,模拟真实机器人工程中的构建、集成、诊断与改进环节。
- 评估协议:根据工作流采用任务特定指标,例如交互控制的成功率、策略学习中的策略性能、感知估计的误差、机械设计的可制造性。评估对象是 agent 提交的 artifacts 而非过程。
- 指标聚合:将各任务得分归一化后聚合为全局 RLE Index,同时输出各工作流独立的 capability profile,用于多维度能力对比。
- 案例研究:深入分析 agent 在代表性任务上的行为,提炼当前能力边界与改进方向。
输出:总体 leaderboard、RLE Index、各工作流能力雷达图,以及 agent 行为洞察。
与同类方法的差异:现有机器人基准多聚焦单一策略或控制器性能,而 RLE-Bench 覆盖异构 artifacts 的完整工程工作流,更贴近真实机器人系统工程,能更全面地暴露 coding agents 在规划、集成与诊断上的综合短板。
实验
实验设计
RLE-Bench 设计了四类机器人开发工作流任务:交互控制、策略学习、感知与估计、机械设计。每个任务要求编码智能体提交可运行的工件,如控制器、训练好的策略、测试 harness 或机械结构。评测使用任务特定指标(如成功率、策略性能、harness 质量、设计合理性),并将这些指标聚合为统一的 RLE Index,同时报告每个工作流的能力画像。
关键发现
现有编码智能体在不同工作流上表现差异明显:交互控制类任务完成度较高,而机械设计与多模态反馈推理仍存在明显短板。案例研究表明,智能体能够独立完成部分单一工件的构建,但在跨工件集成、资源约束下的诊断与改进方面频繁失败。RLE-Bench 由此揭示:机器人工程任务对智能体的长程规划、错误恢复和物理常识推理提出了更高要求。
与基线对比
传统机器人基准仅评估单个策略或控制器的性能,无法反映编码智能体的完整工程能力。RLE-Bench 从开发流程全链路切入,覆盖构建、集成、诊断与改进,显著扩展了评估维度。与纯数字领域的 SWE/MLE 基准相比,该基准引入了物理世界约束和异构工件协同,为编码智能体提供了更贴近真实机器人开发的资格测试。
行业影响
落地场景
RLE-Bench 评估的是 coding agents 在机器人工程中的全流程能力,直接对应机器人开发团队的实际工作:交互控制、策略学习、感知与估计、机械设计。典型场景包括电商仓库的移动抓取机器人部署、自动驾驶仿真中的控制器调参、物流分拣系统的视觉模块迭代。例如,一个电商平台使用 coding agents 自动生成并测试物体抓取策略,或自动驾驶公司让 agent 在仿真中优化路径跟踪控制器,RLE-Bench 可充当筛选与验收关卡。
商业价值
核心价值在 降本 与 加速交付。机器人工程涉及大量跨栈集成与调优,现有工程师资源稀缺,coding agents 可将部分重复性开发(如策略超参搜索、感知模块调试)自动化,降低每台机器人部署的工程成本。同时,缩短从需求到可运行 artifact 的周期,帮助机器人服务商更快响应客户定制需求,扩大服务规模。体验提升方面,更可靠的机器人系统减少现场故障与人工干预,提升客户满意度。
与现有产品/工作流的接口
RLE-Bench 的评估协议可作为现有机器人开发栈的 质量门禁。例如,在 CI/CD 管道 中集成 RLE-Bench 任务子集,对 agent 提交的代码变更自动跑分。与 ROS 2、Isaac Sim、Gazebo 等主流仿真环境兼容,可直接嵌入 MLOps 平台 (如 Weights & Biases、Kubeflow)记录指标。此外,其多维能力画像可辅助模型选型:团队根据自身任务分布(如偏重感知 vs 控制)选择对应 workflow 得分高的 agent。
局限
- **任务覆盖度与真实性有限**:RLE-Bench 目前只包含 7 个任务家族(Family01–07),覆盖四个工作流,但任务数量远少于真实机器人开发场景。所有任务均在仿真环境中完成,无法完全模拟硬件噪声、传感器失效、通信延迟等物理世界干扰,导致评估结果可能高估编码代理在真实部署中的鲁棒性。
- **评估协议与指标聚合存在偏差**:虽然引入 RLE Index 聚合多个工作流指标,但不同任务的难度和指标尺度差异可能导致聚合分数受少数任务主导。此外,各代理与基准环境的交互方式、重试策略和资源消耗未完全标准化,影响跨代理公平比较,也使成本和时间指标的可比性受限。
- **作为基准的贡献定位为诊断而非改进**:论文没有提出新的代理架构或训练方法,仅对现有编码代理进行测试。因此其核心价值在于暴露能力短板,而非直接推动机器人学习工程能力提升;且随着代理模型快速迭代,基准上的排名可能迅速过时,需要持续维护和更新任务集。