PreviewDiff: 面向扩散潜变量的多模态评论家引导搜索
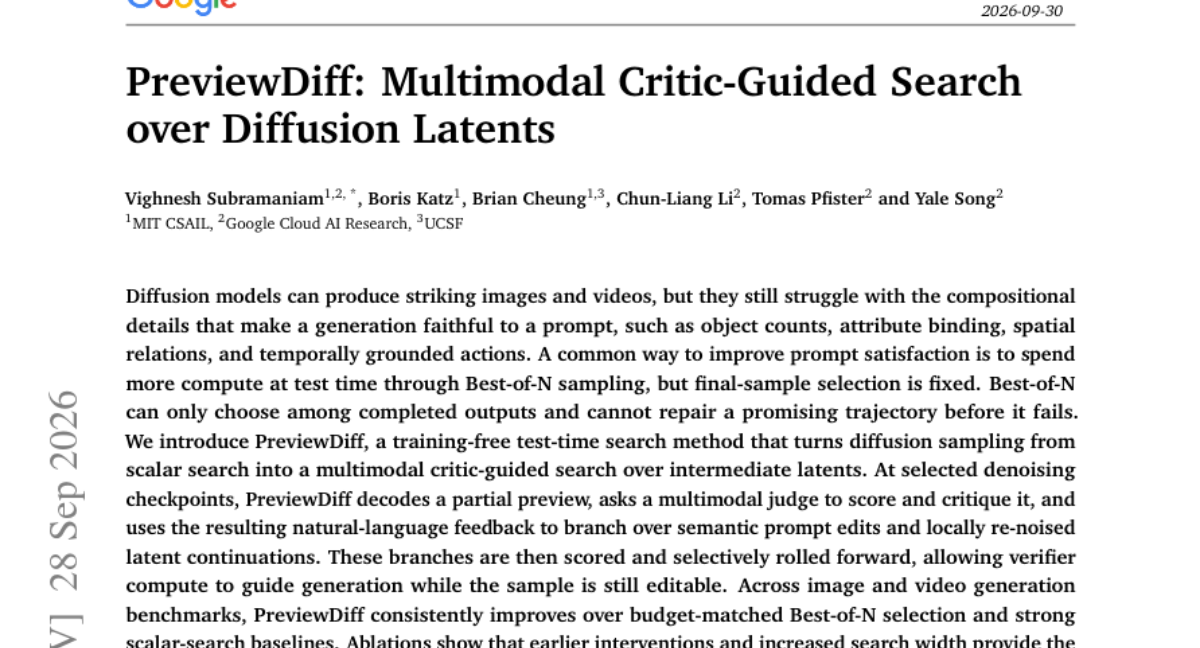
扩散模型能生成惊艳的图像与视频,但在组合细节上仍然不足,例如物体计数、属性绑定、空间关系以及时序动作等对提示词忠实度至关重要的要素。常见的改进方式是测试时增加算力做 Best-of-N 采样,但最终样本的选择是固定的:只能在已完成的输出中挑选,无法在一条有潜力的轨迹失败之前进行修复。 我们提出 PreviewDiff,一种无需训练的测试时搜索方法,将扩散采样从标量搜索转变为在中间潜变量上的多模态评论家引导搜索。在选定的去噪检查点,PreviewDiff 解码出部分预览,让多模态评判器对其打分并给出评论,再利用自然语言反馈在语义提示词编辑与局部重新加噪的潜变量延续上进行分支。这些分支随后被打分并选择性地继续前推,使验证算力在样本仍可编辑时就引导生成。 在图像与视频生成基准上,PreviewDiff 持续优于算力匹配的 Best-of-N 选择以及强标量搜索基线。消融实验表明:更早的干预与更大的搜索宽度带来最大收益,而更深的搜索与额外的语义变体则提供互补提升。PreviewDiff 说明多模态反馈不仅可作为最终验证器,更可作为去噪过程中的主动控制器。
论文精读
TL;DR PreviewDiff 将扩散模型的测试时搜索从最终标量打分扩展到中间潜变量的多模态批评引导,在可编辑阶段用自然语言反馈修正轨迹,图像和视频生成均超越 Best-of-N。
问题
问题背景
扩散模型在文本到图像 / 视频生成中已能产出高保真结果,但组合性细节——对象计数、属性绑定、空间关系、时序动作——仍常偏离 prompt。
现有方法局限
主流测试时提升手段 Best-of-N 通过生成 N 个完整样本再选择,计算消耗大且无法干预中间过程;一旦某一轨迹早期偏离语义,只能废弃重来。标量奖励搜索(如基于 CLIP score 或 reward model)虽能引导去噪,但反馈粗糙,难以定位“哪一步、哪个语义属性出错”。此外,这些方法通常在去噪后期介入,彼时 latent 结构已大致固化,可编辑性低。
为什么难 / 重要
扩散去噪是逐步细化过程,早期中间 latent 高度可塑但难以预测最终质量;需要既能理解多模态语义、又能给出可执行反馈的评判器,并将自然语言批评转化为对 latent 的实际分支操作。同时,测试时计算预算有限,必须在搜索宽度、深度与语义变体数量之间取得平衡。业界对 prompt 遵循度和生成可靠性要求持续提高,测试时扩展(test-time scaling)被视为有前景但尚未成熟的方向。
行业类比
类似 LLM 推理中的过程奖励模型(PRM)引导树搜索:不是只看最终答案,而是在中间步骤就引入价值判断和纠偏,从而提升复杂任务的成功率。
核心洞察
- PreviewDiff 将测试时搜索从最终样本选择前移至中间潜在空间的可编辑阶段。Best-of-N 只能从已完成输出中选择,无法修复中途出错的轨迹;PreviewDiff 在去噪检查点解码部分预览,由多模态 critic 评分并给出批评,据此对中间潜在进行语义提示编辑和局部重加噪分支,使验证算力在样本仍可编辑时介入。相比标量奖励搜索,自然语言反馈提供更细粒度语义诊断,指导有针对性修复,提升搜索效率和可解释性。
- 多模态批评作为控制器而非仅最终验证器,是 PreviewDiff 的核心差异。它将 VLM 的语义理解注入扩散采样闭环,critique 既打分又指出具体失败模式(如对象计数、属性绑定),驱动生成多个语义变体分支并选择性滚动。与 SVDD、进化算法等标量搜索不同,该方法拥有可操作的失败归因;且训练免费、即插即用,任何扩散模型都能通过增加推理计算提升提示遵循度,为工程中低成本提高生成质量提供了直接路径。
方法
输入与总体思路
PreviewDiff 接收扩散生成过程的中间潜在变量序列,在选定的去噪检查点暂停采样。核心改变是把传统测试时搜索从“在完成样本上做标量选择”升级为“在可编辑的中间潜在空间做多模态批评引导的树搜索”。
关键模块
- 局部预览解码:在中间时间步
t将当前潜在z_t直接解码为部分预览(图像或视频帧),无需等待完整去噪。这样可以在样本仍有可塑性时获取可读的视觉反馈。 - 多模态评判器:使用视觉-语言模型(VLM)对预览同时进行打分和自然语言批评。批评内容会指出与提示不符的组合细节,例如对象数量错误、属性绑定缺失、空间关系颠倒或时序动作不连贯。
- 分支生成:根据批评反馈生成两类候选分支:
- 语义提示编辑:自动调整文本提示中相关的语义片段(如修改数量词、属性短语),重新引导后续采样方向。
- 局部重噪声潜在延续:对当前潜在加入局部噪声后继续去噪,以探索相邻潜在空间中的其他可行路径。
- 评分与选择:所有分支继续向前去噪,后续检查点再次调用多模态评判器评分,选择性淘汰低分分支,只保留高置信路径继续滚动。
输出
最终输出为更符合提示组合约束的图像或视频。该方法在相同计算预算下,把验证器计算从“最终筛选”转移到“生成过程中的主动控制”,因而能修复即将失败的轨迹。
与同类方法的差异点
不同于 Best-of-N 和标量搜索只能在已完成输出中做固定选择,PreviewDiff 在中间潜在空间引入多模态批评并支持分支修复,将验证器从被动打分器转变为生成过程内的主动控制器。
实验
实验设计
PreviewDiff 在图像与视频生成基准上验证,采用预算匹配的 Best-of-N 和强 scalar-search 基线。在选定的去噪 checkpoint 解码部分预览,调用多模态评判器打分并生成自然语言批评,据此对语义 prompt 编辑与局部重噪潜在延续进行分支,随后筛选并继续前向生成。
关键发现
- 相比预算匹配的 Best-of-N 与 scalar-search 基线,PreviewDiff 在对象计数、属性绑定、空间关系、时序动作等组合性指标上稳定提升。
- 消融显示:越早介入搜索、增加搜索宽度带来最大收益;更深的搜索与更多语义变体提供互补改进。
- 多模态反馈在去噪过程中作为主动控制器,比仅作最终验证器更有效。
基线对比解读
传统 Best-of-N 只能在已完成样本中选择,无法修复中间轨迹的缺陷;scalar-search 仅使用标量奖励缺乏可解释反馈。PreviewDiff 通过自然语言批评与分支编辑,在样本仍可塑阶段注入验证算力,将测试时计算从“选择”转为“控制”,对工程实践启示为:在生成中间层引入可解释反馈能更高效地利用推理预算。
行业影响
落地场景
PreviewDiff 适合文生图/视频服务 中的高要求 prompt 遵循场景,例如:
- 电商商品图合成:确保指定数量、颜色、空间布局的商品准确呈现;
- 广告创意生成:让品牌 Logo、文案、人物关系精确绑定;
- 短视频/动画自动生成:对时序动作和因果连贯性敏感的内容。
商业价值
PreviewDiff 将测试时搜索 从最终样本选择前移到中间潜在空间,可显著降低生成废片率,减少人工重试与 GPU 重复采样成本。对于平台型生成服务,这直接转化为单位算力产出合格内容 的提升;对于终端用户,意味着“一次生成即符合预期”,提高付费转化与留存。
与现有工作流接口
PreviewDiff 是 training-free 的采样策略,可作为现有 diffusion pipeline 的 drop-in 增强:
- 在现有
DDIM/DPM-Solver采样循环中插入检查点; - 调用现成的多模态大模型 (GPT-4V / Claude) 作为 critic;
- 根据反馈分支:局部重噪声或编辑文本提示再继续;
- 通过
search_width/depth/schedule等参数与现有算力预算对接。
原作者指出:多模态反馈不只是最终验证器,而应成为去噪过程中的主动控制器。
由此,生成平台可在不重训模型的前提下,将 PreviewDiff 作为质量增强插件,与已有的 Best-of-N 或人类反馈评分体系兼容。