是什么让循环机制在 LoopLM 中有效?
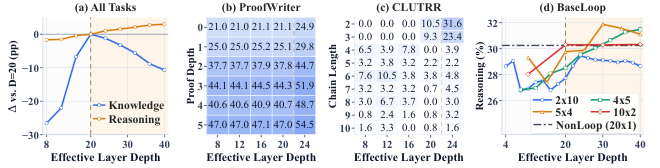
LoopLM(循环语言模型)通过参数共享增加计算深度,为在不增加参数的前提下扩展推理计算提供了路径。然而,额外循环何时有益、架构选择如何影响其效果,仍不清楚。 作者通过受控实验系统考察三个问题:1. 循环何时有帮助;2. 应施加在何处;3. 其条件化方式如何影响性能。评测覆盖训练视野之下、之内与之上的推理预算,涉及知识类与推理类任务。 主要发现: - 循环能提升超出训练视野的推理表现,却会损害知识性能;但更难的推理样本并不一定获益更多。 - 性能还取决于不同层与循环迭代的分配方式,有效深度 本身不足以预测行为;非循环输出层可提升对不足展开的鲁棒性,输入与输出层的偏好位置随推理预算变化。 - 常规初始状态注入对变化循环深度的鲁棒性有限。作者因此提出 history-state injection(历史状态注入),并表明通道级历史状态注入 结合时间步条件化是一种低成本且更有效的设计:在延长展开时更好地保留知识,同时提升跨推理预算的鲁棒性。 总体而言,该工作厘清了循环计算何时有益、何处失效,并为在不同推理预算下设计 LoopLM 提供了实用指南。
论文精读
TL;DR 系统实验揭示循环语言模型中递归的收益边界:递归能提升超出训练步数的推理但损害知识;提出 history-state 注入与 timestep 条件化,低成本提升不同推理预算下的鲁棒性。
问题
问题背景
Looped Language Models (LoopLMs) 通过参数共享增加推理计算深度,为在不增加参数规模的前提下扩展推理能力提供了新路径。当前业界对推理时计算扩展(如思维链、自适应深度)关注度上升,但循环架构的潜力尚未被充分理解。
现有方法局限
已有 LoopLM 变体多采用启发式设计,缺乏系统性验证:
- 循环位置:哪些层应共享参数、哪些层保持独立(如输入/输出层)未明确;
- 状态条件化:常规 初始状态注入(将输入嵌入作为循环初始状态)在循环深度超过训练范围时鲁棒性不足,导致知识类任务性能显著下降;
- 深度分配:仅凭“有效深度”无法预测模型行为,不同层分配策略在相同深度下表现差异大。
这些局限使实际部署难以选择架构,且对推理预算变化敏感。
为什么这个问题难/重要
核心挑战在于训练与推理的循环深度不一致:训练时固定循环次数,推理时可能增加或减少循环,导致状态分布偏移。参数共享使计算图动态变化,难以用标准容量指标(参数量、深度)解释性能。此外,需要同时兼顾知识保持(推理预算低时)与复杂推理增益(预算高时),二者对循环设计的需求存在张力。业界对 无参数扩展推理 兴趣浓厚,但缺少可复用的设计准则。
行业类比
类比 KV 缓存 在长上下文生成中的作用:若循环状态注入机制不当,推理时深度扩展会像缓存污染一样引发知识遗忘或推理崩溃。
核心洞察
- 循环收益与任务类型强相关,且推理难度不单调决定收益。该研究通过受控实验发现,循环在超出训练 horizon 的推理任务上能提升性能,但对知识任务有负面影响;同时更难推理实例并非总是收益更多。这与以往主要关注有效深度或参数效率的工作不同,揭示了循环计算应针对任务类型与实例难度进行选择性分配,而非简单增加展开步数。
- 仅用有效深度不足以预测循环架构行为,非循环输出层与输入输出层放置位置对欠展开鲁棒性影响显著。在此基础上,论文提出 history-state injection 替代传统 initial-state injection,并组合 timestep conditioning,以较低成本在扩展展开时保留知识并提升跨推理预算的鲁棒性。相比同类工作仅优化循环内部状态或条件机制,该工作从架构层面明确了循环组件与非循环组件的协同设计原则。
方法
研究框架
论文通过 受控实验 系统分解 LoopLM 设计空间,围绕三个核心问题:何时循环有益、何处应用循环、如何条件化循环。
输入与模型变体
以预训练语言模型为骨干,构建 BaseLoop 与 CoreLoop 等变体。输入为 token 序列,经嵌入后送入循环模块;循环模块通过参数共享在不同深度重复执行,输出最终 logits。
关键模块
- 层分配策略:比较不同数量的非循环层与循环迭代分配,特别关注输入层与输出层是否参与循环,以及非循环输出层对欠展开鲁棒性的影响。
- 状态条件化机制:对比传统 初始状态注入 与提出的 历史状态注入。后者利用前次迭代的隐藏状态作为条件,并引入 通道级注入 与 时间步条件化,增强对不同推理预算的适应能力。
- 评估设置:覆盖推理预算低于、等于、超过训练 horizon 三种情况,使用知识型与推理型任务(如 BBH 子任务)评估性能。
输出与度量
输出为模型在知识/推理任务上的准确率,并辅以几何探针(如角度距离、状态方差)分析循环行为。
与同类工作的差异:本文不提出新架构,而是通过系统消融与可控实验,厘清循环语言模型有效性的条件,并提供跨推理预算的实用设计指南。
实验
实验设计
本研究通过受控实验系统考察循环语言模型(LoopLMs)中循环计算的有效性,从三个维度展开:何时有帮助、应用于何处、如何条件化。评估覆盖不同推理预算(低于、等于、超出训练视野),任务包括知识与推理场景,其中推理任务选取了 BIG-Bench Hard (BBH) 子集。
关键发现
- 循环能提升超出训练视野的推理性能,但会降低知识任务表现;更困难的推理实例并不总是获益更多。
- 仅凭有效深度无法预测行为,层与循环迭代的分配方式至关重要。
- 非循环输出层能提高对欠展开的鲁棒性;输入/输出层的最佳放置位置随推理预算变化。
- 常规初始状态注入对变化循环深度鲁棒性有限;作者提出 历史状态注入 + 通道级注入 + 时间步条件化 的组合,在扩展展开时更好地保留知识,并提升跨预算鲁棒性。
与基线对比
与传统初始状态注入(initial-state injection)相比,历史状态注入结合时间步条件化在低计算成本下实现了更优的性能-鲁棒性权衡。这一改进尤其在推理预算超出训练视野时减缓了知识遗忘,且无需增加参数。
行业影响
落地场景
LoopLM 特别适合推理密集型 且需求弹性大的产品,例如企业服务中的合同条款审查、金融风控报告生成、教育平台的数学/代码自动批改。这些场景请求复杂度差异显著,可按需分配更多循环迭代。反之,纯知识问答或事实检索不应过度展开,因为循环可能损害知识准确性。
商业价值
- 降本:参数共享用一个模型替代多尺寸模型,降低存储与显存占用,部署维护成本显著下降。
- 增收:可按推理深度设置阶梯定价(如
depth=4/16/32三档 API),形成差异化 SKU,挖掘高价值复杂推理需求。 - 体验提升:history-state injection + timestep conditioning 让模型在不同展开深度下更稳定,减少深度误判带来的准确率波动;非循环输出层提升欠展开鲁棒性,有助于在低延迟档位保持可用性能。
与现有产品/工作流集成
- 在现有 Transformer 推理服务中把循环次数暴露为
num_loops超参数,与max_tokens、temperature并列,由路由层根据请求难度动态设置。 - 训练阶段采用recurrent backpropagation,可将现有模型的部分层替换为共享权重循环块后微调。
- 与 RAG 或知识检索模块配合,补偿循环对知识性能的削弱,适合知识+推理混合型产品。
- 监控不同
num_loops下的准确率、延迟、成本,设置默认值和自动降级策略。
局限
- **实验规模与任务覆盖有限**:论文采用受控实验,模型规模与训练预算低于工业级大模型,且主要评估 BBH 推理子任务和知识基准,未涵盖对话、代码生成、多语言等能力,结论是否可迁移至数十亿参数级模型或更复杂任务尚待验证。此外,评估仅覆盖有限推理预算范围,超出训练 horizon 的深度未做系统性扩展研究。
- **缺乏机制层面的理论解释**:论文通过消融实验提出 history-state injection 与 timestep conditioning 组合更有效,但未从优化动力学或表示几何角度深入解释为何该设计能保持知识并提升鲁棒性,也未分析不同层状态注入对内部表征的具体影响,这限制了设计原则的普适性推导。
- **对比基线可能不够全面**:与已有 LoopLM 工作相比,论文侧重架构搜索与条件机制,但未与最新参数高效缩放方法(如 mixture-of-depths、early exit 等)在相同预算下进行横向比较,也未探索非均匀 iteration 分配等精细策略,故其提出的准则在更广阔的设计空间中的相对优势尚不明确。