ALICE: 上下文内、零样本的互信息估计
从样本中估计互信息(MI)是众多科学领域的核心目标。现代神经估计器在大数据情形下精度可观,但在数据稀缺时表现不佳,且对每个待研究的分布都必须重新拟合;此外它们还受限于特定的数据类型。这些限制使得在逐分布训练不可行、样本量又小的诸多应用中难以落地。 为此,作者提出 ALICE——一个基础模型,它免去逐分布训练,同时保持有竞争力的估计精度。ALICE 仅在广泛的合成分布族上训练,充当整流流速度场(rectified-flow velocity fields)的上下文内估计器:以未见分布的样本为条件,无需任何显式训练即可估计该分布的速度场。随后,MI 通过一个固定恒等式得到,该恒等式对联合场与条件场之差的平方做积分。 实验方面: - 在标准且具挑战性的 benchmark 上完成验证; - 应用于 biology、genetics、neuroscience 三个领域,其数据模型从未见过; - 首次表明,单一模型可逼近为每个分布单独训练的神经估计器,同时原生支持不同的数据维度与样本基数,实现跨科学领域的零样本 MI 分析。
论文精读
TL;DR ALICE 是一个零样本互信息估计基础模型,通过上下文学习整流流速度场,无需按分布训练即可从样本计算 MI,支持多变维度和样本量,性能接近单独训练的神经估计器。
问题
问题背景
互信息(Mutual Information, MI)估计是科学计算中的基础任务,用于量化变量间的统计依赖,广泛应用于生物学、神经科学、表征学习与因果发现等领域。近年来,基于神经网络的估计器(如 MINE、InfoNCE、DIME)在大样本条件下已能达到较高精度,推动了 MI 在高维数据上的应用。
现有方法局限
- 小样本性能差:现代神经估计器依赖大量样本训练,数据稀缺时偏差大、方差高,难以给出可靠结果。
- 逐分布重新训练:每个待分析的分布都需要单独拟合一个模型,无法跨分布复用,计算开销大,不适合快速探索或元分析场景。
- 数据类型绑定:估计器通常针对特定数据模态(连续向量、图像、序列)设计,难以直接处理混合类型或不同维度的数据。
- 缺乏零样本泛化:目前没有统一的基础模型,无法在未见分布上直接推理,限制了 MI 估计在科学发现中的规模化应用。
为什么这个问题难/重要
技术挑战:MI 估计本质上是估计概率密度比或梯度场,高维数据下存在维数灾难;同时需要处理联合分布与边缘分布的关系,其积分形式难以直接计算。近年来扩散模型与流匹配(Flow Matching)的进展表明,学习速度场(velocity field)可以间接估计密度比,为 MI 估计提供了新思路,但尚未形成通用基础模型。
业界关注度:在单细胞组学、神经科学等数据密集型领域,MI 是因果推断、特征选择、表征解耦的核心工具。一个可零样本、跨数据类型的统一估计器能大幅降低应用门槛,加速科学假设检验。
行业类比
类似于大语言模型中的上下文学习:传统 NLP 下游任务需要逐任务微调,而 GPT 等基础模型通过提示即可泛化到新任务。ALICE 的目标正是“一次训练,处处估计”,对 MI 估计领域而言,相当于**“MI 估计的 GPT 时刻”**。
核心洞察
- 核心洞察:ALICE 将互信息估计重构为 rectified flow 速度场的 in-context 估计,将每分布训练转化为条件推理。传统神经估计器如 MINE 或 InfoNCE 必须在每个目标分布上单独训练,小样本时容易过拟合;而 ALICE 通过在大规模合成分布族上预训练速度场基础模型,推理时仅依据新分布的几个样本直接预测速度场,再用闭式积分计算 MI。这种从直接回归 MI 到学习中间表示的分层设计,解耦了估计器和分布,显著提升跨分布泛化能力。
- 核心洞察:ALICE 利用 transformer 的集合输入特性,原生支持不同数据维度和样本数量,摆脱了以往估计器对固定输入维度的依赖。传统方法通常需要为每个维度定制网络;ALICE 将样本编码为维度无关的 token,使单一模型可处理从低维到高维、样本数变化的数据。论文在生物学、遗传学、神经科学等未见的真实数据上实现零样本估计,精度与 per-distribution 训练相当,证明了统计估计模型跨模态、跨样本量的泛化可行性,为小样本科学分析提供了新工具。
方法
输入与任务定义
ALICE 接收一组来自未见过分布的样本,这些样本可以是联合分布 P(X,Y) 或条件分布 P(X|Y=y) 的采样点。输入样本的 维度 和 样本数量 均不固定,模型需直接输出速度场估计。任务本质是零样本互信息 (MI) 估计:不针对目标分布做任何训练或微调。
关键模块:In-context 速度场估计器
核心是一个 Transformer 架构的集合编码器,将变长样本集映射为每个样本点的 rectified flow 速度场 预测。训练时,模型在大量合成分布上学习:输入一批样本,输出对应分布从标准高斯到目标分布的 rectified flow 速度。速度场由条件样本集隐式表征——模型通过注意力机制聚合样本信息,实现对任意分布的快速适应。
MI 计算与预训练
MI 通过一个固定恒等式获得:对联合分布和条件分布分别估计速度场,然后对两个场的平方差进行积分。该积分等价于 KL 散度的速度形式,无需额外训练。预训练语料覆盖多种合成分布族,包括 Copula 混合、潜在空间扭曲、非参数回归 和 流形分布,并构造特定批量策略,让模型学会从有限样本推断全局速度场。训练目标为速度预测的均方误差,并加入噪声指示器以支持不同噪声水平。
与同类方法的差异
不同于 MINE、InfoNCE 或基于扩散的 MI 估计器需对每个分布单独训练或拟合,ALICE 以单一预训练模型实现跨分布、跨维度、跨样本量的零样本 MI 估计,且计算过程不依赖目标分布的任何参数化假设。
实验
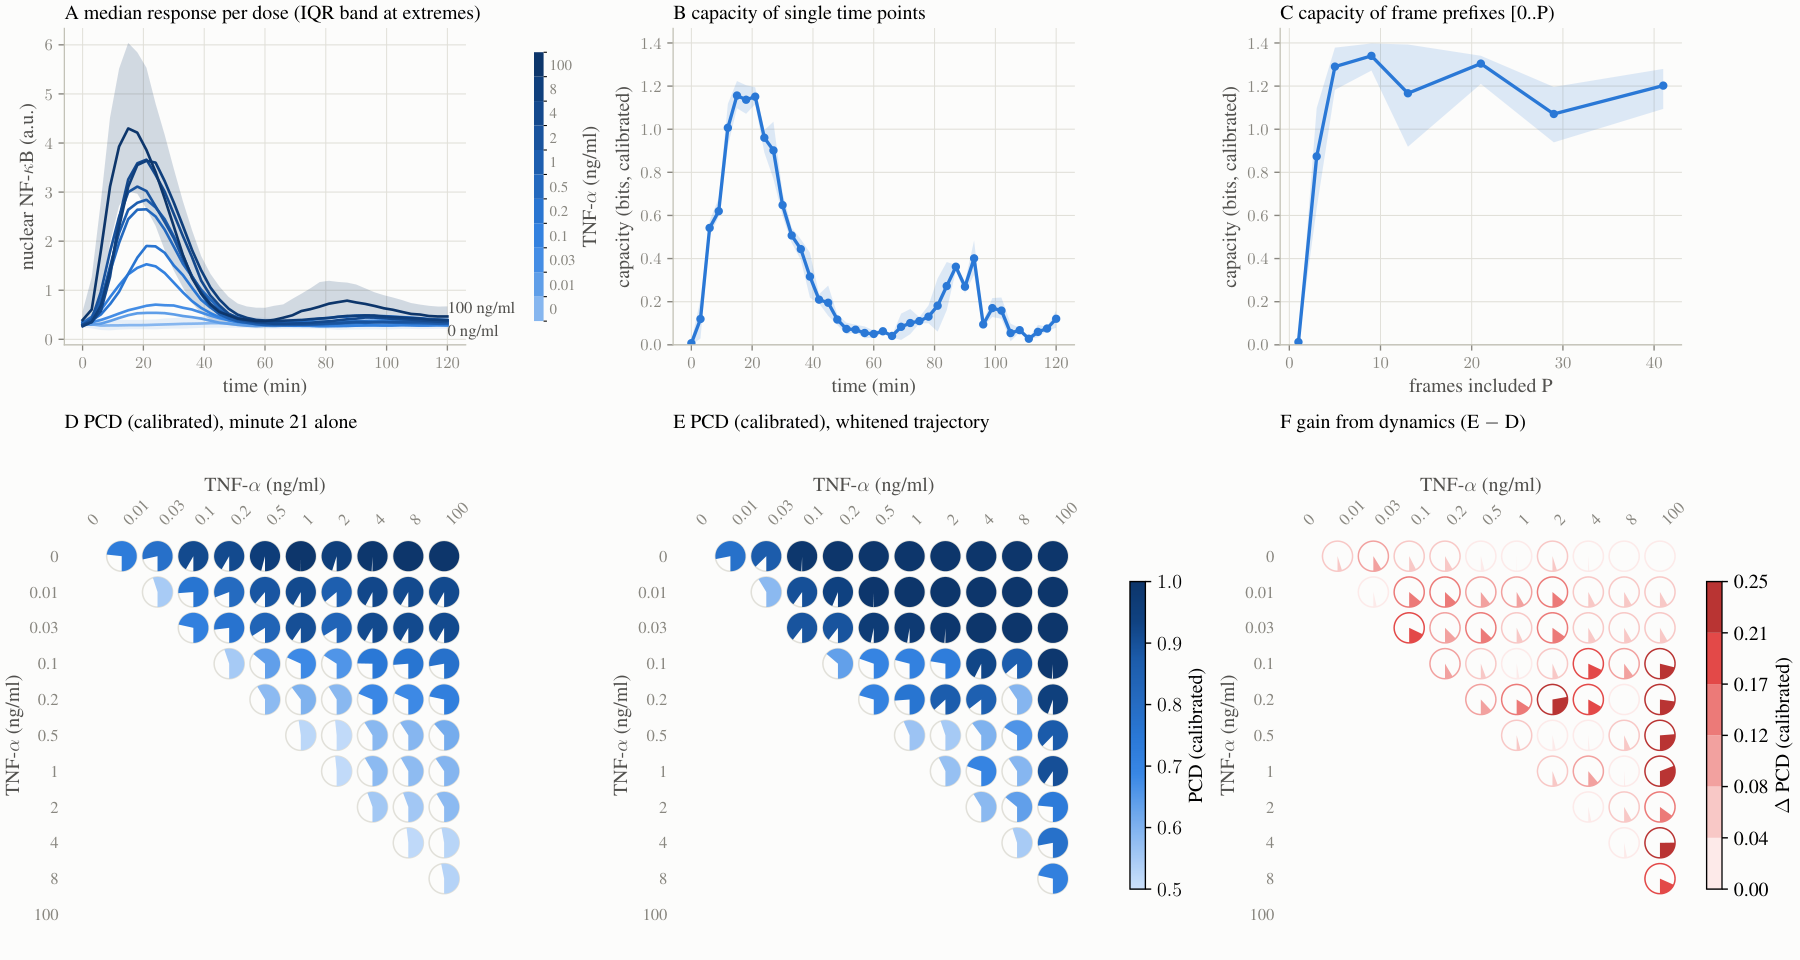
实验设计上,ALICE 在由多种合成分布构成的语料库上预训练,学习作为上下文的校正流速度场估计器。验证阶段,模型在标准 MI 估计基准上测试,并与单独训练的神经估计器对比。随后,零样本迁移到三个科学领域:单细胞信号响应、启动子识别和脑区活动模式,这些数据在训练中完全未见。关键发现是 ALICE 首次实现了单一模型在跨领域 MI 估计中缩小与按分布训练的神经估计器的差距,同时原生支持不同的数据维度和样本基数,无需任何微调。与基线对比的深度解读:传统神经估计器需要为每个分布重新训练,且依赖大量样本,限制了小样本和快速应用场景。ALICE 通过上下文学习消除了按分布训练,虽然可能在极端分布上略有不足,但在零样本场景下提供了实用性和泛化能力,为科学数据分析提供了新的范式。
行业影响
落地场景
ALICE 作为零样本互信息估计基础模型,可嵌入数据科学平台与 MLOps 工具链。典型场景包括:
- 电商推荐冷启动:新商品缺少历史交互,用 ALICE 快速估计用户特征与转化之间的 MI,指导特征筛选。
- 金融风控:评估交易行为特征与欺诈标签的依赖强度,辅助变量选择。
- 生物信息分析:单细胞数据中基因-基因调控关系推断,无需逐实验训练。
商业价值
降低计算成本:无需为每个分布拟合专用神经估计器(如 MINE),直接推理即可获得 MI,缩短分析周期。提升产品竞争力:数据平台可提供零配置依赖分析功能,吸引需要快速探索数据关系的团队。增强模型可解释性:MI 估计帮助识别关键特征,改善审计与合规流程。
与现有产品/工作流的接口
ALICE 提供 Python API,风格接近 scikit-learn:alice.estimate_mi(X, Y)。可集成到:
- 特征工程阶段:作为预计算步骤,生成特征依赖图,写入特征存储。
- 分布式流水线:与 Spark / Ray 结合,对数据分片并行推理。
- 自动化机器学习 (AutoML) 系统:在特征选择模块中替换或补充现有 MI 估计器。
具体落地用例
- 电商平台:新品冷启动时,利用 ALICE 估计用户历史行为与购买意图的 MI,筛选出高信息量特征,提升排序模型初期效果。
- 生物医药企业:分析单细胞测序数据,快速估计信号通路中的互信息,加速药物靶点发现。
局限
- - **训练分布域差距**:ALICE 仅在合成分布家族上训练,虽然覆盖 copula、流形等多种结构,但真实科学数据(如单细胞信号、遗传启动子、脑区活动)存在更复杂的噪声、缺失值、长尾依赖,可能不在合成语料中。零样本泛化在这些场景下可能出现系统性偏差,导致 MI 估计不可靠。工程启示:在关键应用中需要建立域适应评估协议,或考虑用少量目标域样本微调(尽管违背零样本初衷)。
- - **速度场估计的小样本精度限制**:ALICE 通过估计 rectified flow velocity field 并积分平方差得到 MI,velocity field 的估计误差会直接传播到 MI 值。尽管支持可变样本数,但在样本极少(如个位数样本对)或高维情况下,模型可能难以准确回归条件场,导致 MI 估计方差大。论文未提供与专用神经估计器(如 MINE、InfoNCE)在极端小样本下的严格对比,可能掩盖性能悬崖。工程上需要明确适用样本量下限。
- - **推理成本与模型规模未充分披露**:作为 foundation model,ALICE 的 Transformer 架构参数量可能较大,推理时需对每对样本计算 velocity 并在多对间积分,时间复杂度可能高于轻量级估计器(如 KSG、MINE)。论文未给出详细的延迟和内存基准,这对实时或大规模数据分析是重要限制。另外,目前开源仓库 star 为 0,社区验证不足,实际部署风险较高。