Unmask the State:状态自适应何时对 Masked Diffusion Language Models 重要
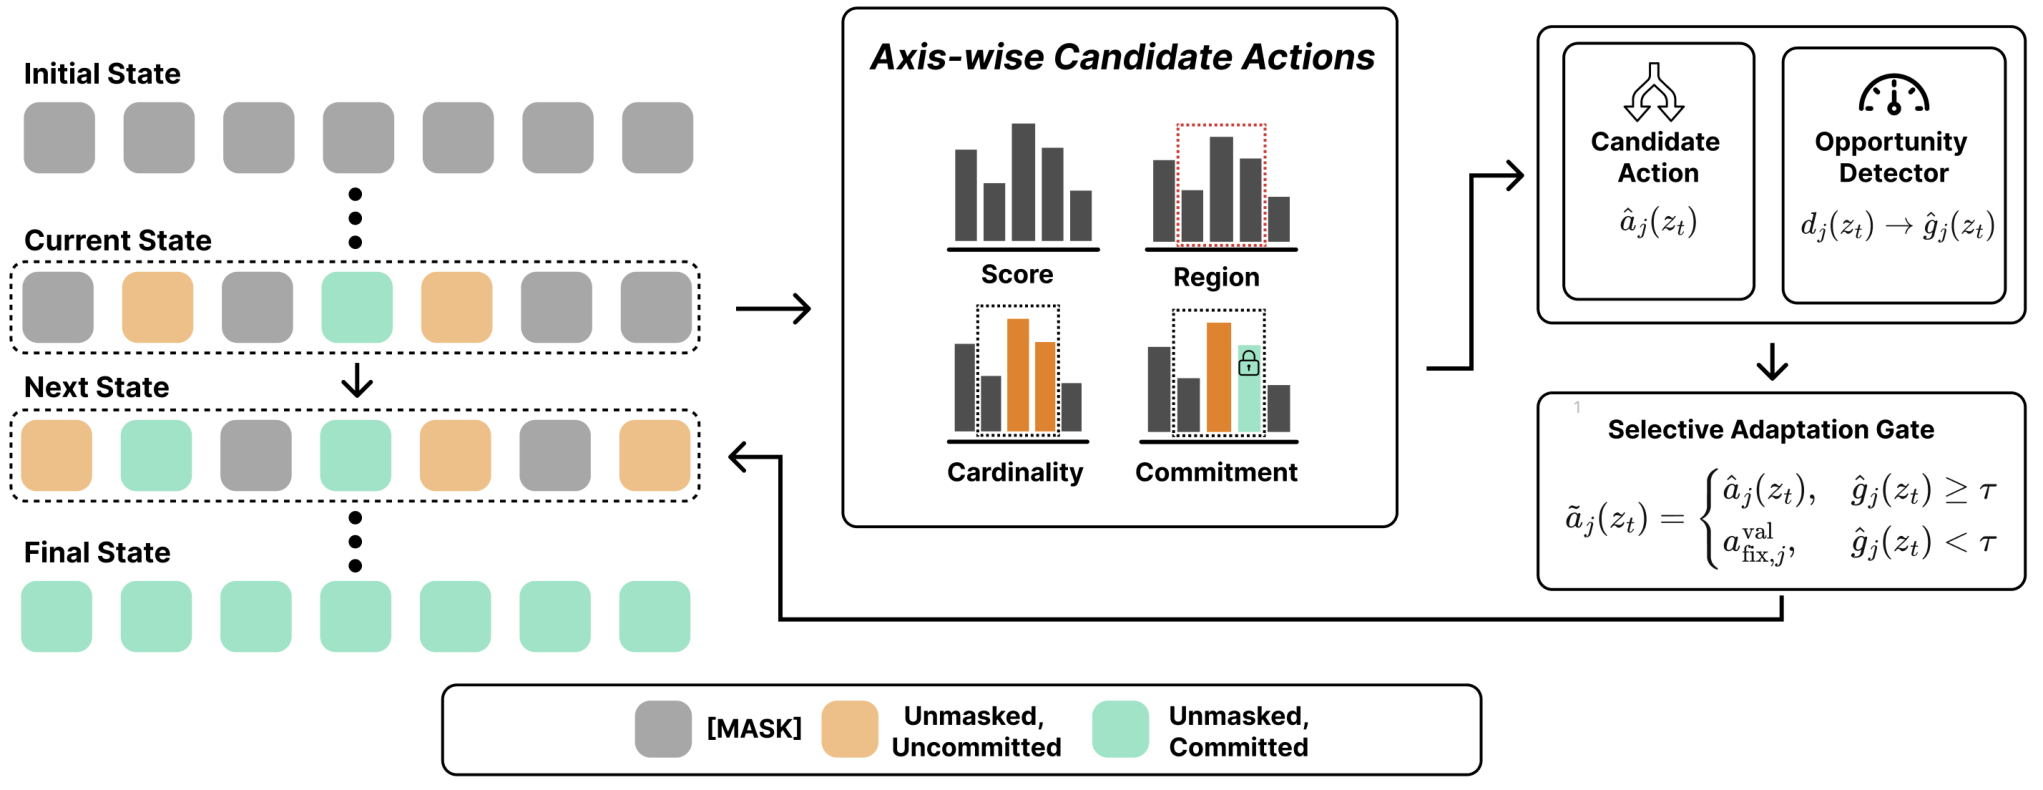
Masked diffusion language models (MDMs)允许灵活的生成顺序,使 unmasking 策略成为一种推理决策。现有方法在位置优先级排序、并行度控制、选择区域限制、预测修正与未来去噪规划等方面各不相同,但这些选择何时应在生成过程中发生变化,仍不清楚。 我们通过 strategy reversals(即替代动作优于固定选择的情形)研究这一问题,并将 MDM 推理归纳为五个轴:score、cardinality、region、commitment 与 planning。我们把 adaptation opportunity 定义为最佳候选动作相对验证集选定固定动作的一步效用优势,该视角表明自适应价值同时取决于此类反转的频率与幅度。 在三个 MDM 与十个任务上,自适应机会高度异质,部分 regime 呈现集中且可预测的一步收益。这引出了 selective adaptation 的思路:由验证提示校准的轻量检测器来识别高机会状态。例如在 LLaDA-8B 的约束 JSON 填充任务中,仅对前 10% 状态进行自适应,即可捕获候选集 oracle 机会的 56.9%。 基于 transition-level 的结果表明,状态自适应在选择性应用时最为有效,而非统一应用。
论文精读
TL;DR 本文研究掩码扩散语言模型在生成过程中何时需要调整解掩码策略,提出基于五轴反转的适应机会指标,发现机会高度异质且可预测,从而设计轻量检测器实现选择性适应,在仅 10% 状态上捕获过半候选集增益。
问题
问题背景:masked diffusion language models (MDMs) 由于允许灵活生成顺序,使 unmasking 策略成为推断阶段可优化的决策变量。近期工作开始探索解码时动态调整 score、cardinality、region 等选择。
现有方法局限:多数现有工作将 unmasking 策略视为静态超参,或仅在单个轴向上做局部改进,缺少跨轴统一视角。它们通常根据验证集平均效用选择固定动作,忽略生成过程中状态条件分布的变化。事实上,同一个动作在不同解码阶段的优劣可能发生反转(strategy reversal),固定策略无法捕捉这种依赖性。此外,逐状态穷举最优动作不可行,而统一动态调整又可能引入不必要的计算开销。
为什么难/重要:MDM 推断的状态空间随长度和词汇表指数增长,如何判断“何时换策略更有利”是一个在线决策问题。论文提出的 adaptation opportunity 将这种判断转化为一步效用优势,并发现机会高度异质且部分可预测,这为 selective adaptation 提供了理论依据。业界关注推理成本与生成质量的权衡,自适应解码有望在不显著增加延迟的前提下提升质量。
行业类比:类似 LLM 推理中的 speculative decoding 根据前缀难度动态调整草稿长度,MDM 状态适应根据当前掩码状态选择性切换去掩码动作,集中算力于高机会状态。
核心洞察
- 本文将 MDM 推理中的“策略反转”(strategy reversal) 作为适应机会的基本单位,考察在单个状态上更换动作带来的单步效用提升。与以往工作通常比较完整解码轨迹或端到端指标不同,这种细粒度分解揭示了适应价值高度异质且集中,为选择性适应提供了理论依据,并指明了何时应当偏离固定策略。
- 通过将去掩码策略解构为 score、cardinality、region、commitment、planning 五个轴,本文建立了统一的 MDM 推理决策空间。相比以往各自为政的方法(如仅关注置信度排序或并行数),该框架使跨方法对比和逐轴分析成为可能;实验表明不同任务中各轴的适应机会分布差异显著,可指导工程师优先优化收益最高的轴。
- 论文提出选择性适应(selective adaptation)策略:仅在检测到高机会状态时采取非固定动作,余下沿用验证集选取的固定策略。在 LLaDA-8B 约束 JSON 填充任务中,仅对前 10% 状态适应即可恢复候选集 oracle 机会的 56.9%,证明轻量级检测器能高效捕获大部分增益,降低 MDM 推理延迟与计算开销。
方法
统一决策空间与五轴参数化
将 MDM 的 unmasking 过程分解为五个可调轴:score(位置优先级)、region(可选区域)、cardinality(并行揭示数量)、commitment(是否允许修正已揭示预测)、planning(未来去噪规划)。每个轴对应不同策略,构成一个高维离散动作空间。
状态-动作效用与适应机会
对每个生成步骤,定义 state–action utility(一步效用),即在当前状态 s 下采取动作 a 获得的期望质量增益。Adaptation opportunity 定义为候选动作集合中最佳动作相对于验证集选出的固定动作的效用优势。通过 strategy reversals(固定动作在某状态不再最优)来量化适应必要性,将机会分解为反转的频率和幅度。
轴级诊断与动作提议
针对每个轴设计训练无关的诊断器:例如 score 轴使用不确定性聚合,region 轴考虑位置鲁棒性,cardinality 轴利用跨轮上下文传递,commitment 轴权衡上下文价值与修正成本。这些诊断器为当前状态生成少量候选动作(如改变 cardinality 或切换 region 约束),形成候选集合。
机会检测与选择性适应
训练轻量机会检测器(validation-calibrated),输入状态特征(如注意力读出的不确定性、位置漂移等),输出该状态是否属于高适应机会(top-k 分位)。生成时仅对检测为高机会的状态执行候选动作选择,其余状态沿用固定策略。由此实现 selective adaptation:不是每一步都做复杂搜索,而是在少数高收益状态切换动作。
与同类方法差异:以往 MDM 解码策略通常在全局固定一套启发式或专门优化单一轴,本文提出统一框架并通过状态级检测实现按需适配,在计算成本与增益间取得平衡。
实验
实验设计
论文在 3 个 masked diffusion language models (MDMs) 和 10 个任务 上评估状态适应策略。推理动作被组织为五个轴:score、cardinality、region、commitment、planning。通过定义 adaptation opportunity 为最佳候选动作相对验证集选定固定动作的一步效用优势,作者量化策略反转的频率与幅度,并使用验证集校准的轻量检测器识别高机会状态,实现选择性适应。典型任务包括 constrained JSON filling 与 CSV missing cells。
关键发现
适应性机会高度异质,部分 regime 表现出集中且可预测的一步收益。在 LLaDA-8B 的 constrained JSON filling 任务上,仅适应 top 10% 状态 即可捕获 候选集 oracle 机会的 56.9%。transition-level 结果表明,选择性适应比均匀适应所有状态更有效,说明状态适应的价值取决于反转的频率与幅度,而非全局统一调整。
与基线对比
与固定动作基线相比,选择性适应在只干预少量状态的情况下,捕获了超过一半的 oracle 机会,显著降低计算开销。相比均匀适应所有状态,该方法在保持大部分收益的同时,将干预比例降低至 10%,证明推理阶段的自适应应由状态特征动态触发,而不是采用静态全局策略。这为 MDM 解码提供了更高效的工程路径。
行业影响
落地场景
Masked diffusion language models (MDMs) 的 unmasking 策略自适应可应用于任何需要高质量文本生成且对推理成本敏感的场景:
- 电商产品描述生成:根据商品属性动态调整 unmasking 顺序,生成结构化 JSON 格式的商品规格与卖点文案,减少人工校对。
- 金融报告自动化:在生成合规摘要或数据表格时,针对关键字段(如数值、日期)优先使用高置信度 unmasking,降低错误率。
- 企业服务中的代码补全与数据清洗:例如 SQL 查询生成、CSV 缺失单元格填充,利用 selective adaptation 在上下文复杂时切换策略,在简单时保持默认,实现推理延迟与精度的平衡。
商业价值
论文提出的 selective adaptation 思路直接作用于降本与体验提升:
- 降本:仅在约 10% 的生成状态触发 adaptation,避免全流程调用复杂策略,显著减少计算开销(如 LLaDA-8B 场景)。
- 体验提升:通过 lightweight detector 实时识别高机会状态,捕获 56.9% 的 oracle opportunity,在关键生成步骤提高 token 质量,减少重试与二次修正。
- 可解释性:五轴 taxonomy(score, cardinality, region, commitment, planning)为工程团队提供清晰的推理策略调优框架,降低试错成本。
与现有产品/工作流的接口
该方法可作为推理时插件集成到现有 MDM 推理栈:
- 在模型输出 logits 后、unmasking 动作选择前插入 axis-wise diagnostics 和 opportunity detector,无需重新训练。
- 与 vLLM、TensorRT-LLM 等推理引擎协同,通过配置项控制 adaptation 阈值(如 top-k 状态比例)。
- 对生产环境中的 prompt 分布进行 validation 校准,离线训练 detector,在线推理时仅增加少量前向计算。
核心启示:不要把 unmasking 策略当作全局固定配置,而是作为可动态调节的决策变量,用轻量检测器实现“按需适应”,在生成质量与推理成本之间取得最优平衡。
局限
- **单步视角的局限**: 论文将 adaptation opportunity 定义为 one-step utility advantage,即候选动作相对固定动作的单步效用增益。这忽略了多次 unmasking 步骤之间的长期依赖和累积效应,单步最优未必导致整体序列质量最优。实验主要报告 one-step utility recovery,对端到端文本生成的困惑度、多样性或人类偏好等宏观指标的提升证据有限,可能低估或高估 selective adaptation 在实际部署中的价值。
- **检测器的校准依赖**: selective adaptation 需要在一个 validation prompt 集合上校准轻量检测器,用以判断哪些状态值得适应。该校准过程对任务分布、模型 checkpoint 和 prompt 风格较为敏感,当推理场景与验证分布存在偏移(例如从 constrained JSON filling 迁移到开放式生成)时,检测器可能误判高机会状态,导致适应策略失效。论文未系统评估检测器在跨域或零样本条件下的泛化能力,也未提供自适应在线校准机制。
- **任务和模型覆盖有限**: 实验基于三个 MDMs 和十个任务,但任务类型偏向结构化或约束生成(如 CSV/JSON filling),缺乏对长文本开放式生成、多轮对话或代码生成等场景的验证。此外,与 planning-based 或更复杂的 unmasking 策略(如结合搜索的算法)的对比主要集中在单步效用层面,缺少端到端解码质量的完整基准,因此结论的普适性有待进一步检验。