结构化残差连接对 Diffusion Transformers 至关重要
Diffusion Transformers(DiTs) 已成为高保真图像生成的可扩展主干。但与依赖刚性手工 skip connections 的 U-Net 扩散模型不同,DiTs 主要使用统一残差流,将所有前置层整合为单一整体状态。本文重新审视 DiT 的残差连接,提出将其从被动求和转变为面向图像去噪优化的主动检索机制。 作者系统分析了 DiT 的内部表示,发现其隐含偏好浅层特征复用、对称层引导。基于此,提出结构化连接设计,将局部残差连接与长程路径显式整合。不同于静态 skip connections 或稠密的全层路由,该方法让每个 transformer block 选择性地“关注”关键的早期表示,通过直接、可微的跨深度路径动态检索空间与语义线索。 实验表明,这种自适应连接带来更快收敛,训练迭代次数最多减少 1.73 倍,并在额外参数少于 0.1% 的情况下显著提升 FID 与视觉质量:强基线 REPA-XL/2 在无引导下由 5.9 提升至 4.34 FID,配合 classifier-free guidance 更达到 1.39 FID。 研究表明,自适应跨层连接是扩散 Transformer 中关键却未被充分探索的因素,引入结构化信息通路为改进可扩展生成模型提供了简单有效的方向。
论文精读
TL;DR 本文重新设计 DiT 的残差连接,将被动求和变为主动跨层检索,利用早期层特征重用偏好构建结构化信息通路,以不足 0.1% 额外参数实现 1.73 倍训练加速与显著 FID 提升。
问题
问题背景
扩散 Transformer (DiTs) 已成为高保真图像合成的主流可扩展骨干,其残差连接设计直接影响训练收敛速度与生成质量。
现有方法局限
与 U-Net 扩散模型依赖手工设计的 skip connections 不同,DiTs 普遍采用统一残差流(monolithic state),仅通过简单求和累积所有前层输出。这种方式缺少显式的跨深度结构化通路,难以捕捉网络内部对早期层特征重用 和 对称层引导 的偏好——这些偏好已在本文的表示分析中被实验验证。因此,模型在训练后期难以高效复用关键空间与语义线索,导致收敛慢、FID 提升受限,且无法在不增加参数量下动态调整信息流。
为什么这个问题难/重要
为 DiT 设计自适应残差连接面临三重挑战:
- 需要保持端到端可微、可训练的 routing 机制
- 必须控制额外参数与计算开销,避免破坏 DiT 的可扩展性
- 扩散模型的多步去噪使层间信息需求随噪声水平变化,静态连接难以适应
业界对生成模型的训练效率与推理质量高度关注,稀疏、动态的结构化连接已成为提升大模型性能的关键方向,但在扩散 Transformer 中探索较少。
行业类比
这类似于大语言模型中用稀疏门控 MoE 动态选择专家来提升计算效率与表现——本文则把“专家”换成“历史层特征”,在深度维度上做可微检索。
核心洞察
- 残差连接应从被动求和转变为可学习的深度路由,让每个 transformer block 动态检索早期关键表示。与 U-Net 的静态跳连和 DiT 的均匀残差流不同,本工作通过对 DiT 内部表示的系统分析,发现其偏好早期层特征重用与对称层引导,并据此设计结构化连接(局部残差 + 长程路径)。该方案以不到 0.1% 的额外参数实现更快收敛(最高 1.73 倍迭代缩减)和显著 FID 提升,证明自适应跨层连接是扩散 transformer 中未被充分挖掘的关键因素。
- DiT 的对称层引导(mirror routing)是一种简单高效的连接先验,在几乎不增加计算开销的情况下提升模型性能。以往工作要么采用密集全连接路由,要么依赖手工跳跃连接,而本文通过梯度相似性分析揭示对称层对之间存在强耦合,据此提出只路由镜像层的策略。实验表明,这种受表示结构启发的路由策略在 REPA-XL/2 上从 5.9 FID 降至 4.34 FID(无引导),且达到 1.39 FID(分类器引导),展示了针对扩散 transformer 内部对称性设计连接模式的巨大潜力。
方法
方法核心:动态跨层检索的残差连接
输入:含噪图像潜变量(图像 token 序列)及条件信息(类别标签或文本嵌入),送入 DiT 的多个 Transformer 块。
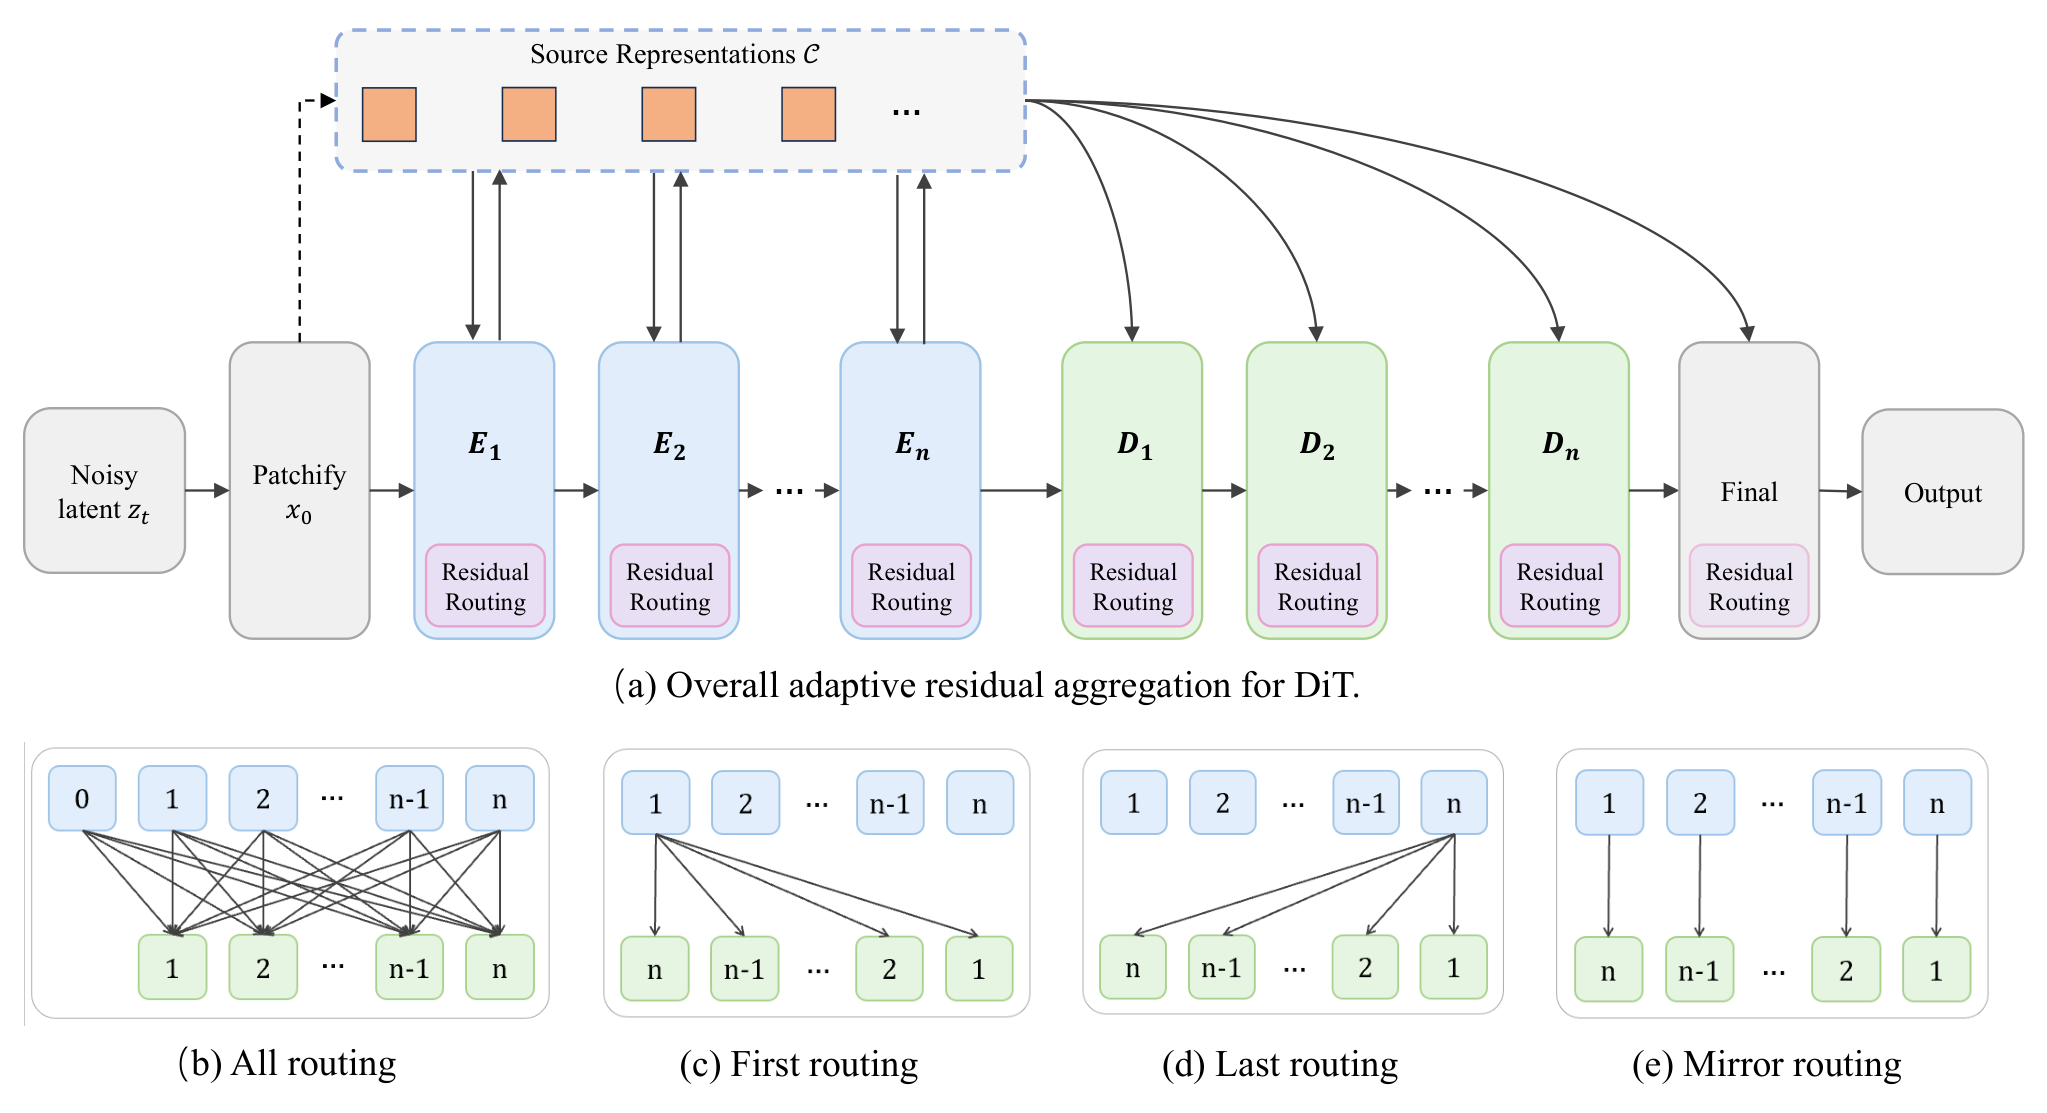
关键模块:本方法将传统 DiT 中统一的残差流改造为可微的残差路由集合。每个 Transformer 块不再简单接收上一层的输出,而是从预先定义的源池(早期层或特定层的特征表示)中动态检索重要的中间表示。具体包含以下组件:
- 局部残差:保持标准的短路连接,确保梯度流动和训练稳定。
- 长程路径:引入可学习的路由算子,根据当前块的内容计算与源池中各表示的相似度(或相关性分数),并软性地加权聚合这些历史特征。
- 源路由策略:设计多种候选模式,如
all routing(所有先前层)、first/last routing(仅首层或末层)、mirror routing(对称层配对),以适应不同去噪阶段的需求。
输出:路由聚合后的特征与当前块输出融合,继续传递到后续层;最终通过解码头预测噪声,用于扩散采样中的去噪步骤。
训练:路由算子可微,与主干网络端到端联合优化;额外参数量不到主干模型的 0.1%。
作者通过分析 DiT 内部表示发现,模型天然倾向于重用早期层特征并呈现对称层引导,因此显式构建此类结构化连接能加速收敛并提升生成质量。
与同类方法差异:不同于 U-Net 的固定跳跃连接或 DenseNet 式密集全层路由,本方法实现了按需、动态、可微的跨层信息检索,在不增加大量参数的情况下强化了扩散 Transformer 的表示能力。
实验
实验设计
论文在 ImageNet 上评估所提方法,基线包括标准 DiT-XL/2 和强基线 REPA-XL/2。首先对 DiT 内部表示进行系统分析,发现模型倾向于重用早期层特征,并呈现对称层间的引导关系。基于此,提出 结构化残差连接,将每个 transformer block 的残差求和替换为对历史表示的可微分检索,同时集成局部残差与长程路径。
主要评估指标为 FID,分为无引导和 classifier-free guidance (CFG) 两种设置,并统计收敛所需训练迭代次数和参数增量。
关键发现
- 收敛加速:自适应连接使训练收敛所需迭代减少至多 1.73×,显著降低算力成本。
- 质量提升:在无引导下,将强基线 REPA-XL/2 的 FID 从 5.9 降至 4.34;配合 CFG 后进一步达到 1.39 FID。
- 轻量高效:额外参数占比 <0.1%,几乎不增加模型复杂度。
与基线的深度对比
与传统 DiT 的均匀残差流相比,本文方法类似 U-Net 的跳跃连接,但丢弃了刚性手工设计,改为内容感知的动态检索。与静态跳跃连接或密集全层路由相比,所提的选择性跨深度路径既避免冗余,又显式建模了层间依赖。
作者认为,自适应跨层连接是扩散 Transformer 中未被充分探索的关键因素,结构化信息通路为可扩展生成模型提供了一条简单有效的改进方向。
这一发现挑战了“残差仅需被动求和”的惯例,提示在深层 DiT 中主动设计信息流动可能带来比堆叠更多层或增大宽度更高的收益。
行业影响
落地场景
该工作提出结构化残差连接(Structured Residual Connectivity),为 Diffusion Transformers (DiTs) 引入可学习的跨层检索机制,适用于各类高分辨率图像生成任务。典型场景包括:
- 电商商品图生成:训练更快的 DiT 模型可快速产出高质量商品展示图,减少人工拍摄与修图成本。
- 内容平台素材生成:用于短视频封面、广告 Banner 等创意内容的自动生成,提升素材更新频率。
- AI 辅助设计:在建筑、游戏、影视概念设计中快速生成高保真预览图,加速迭代流程。
商业价值
主要体现为降本增效与质量提升:
- 训练成本降低:同类模型收敛所需训练迭代数最多减少 1.73 倍,直接降低 GPU 时长与能源消耗。
- 生成质量提升:在不使用 classifier-free guidance 时,将强基线 REPA-XL/2 的 FID 从 5.9 降至 4.34;使用 guidance 后达到 1.39,显著改善视觉真实感。
- 参数开销极小:仅增加 <0.1% 参数,几乎不增加推理延迟或显存占用,对线上部署友好。
与现有工作流接口
该方法可作为即插即用的残差连接模块嵌入现有 DiT 训练流程:
- 代码层面:仅需替换 transformer block 内部的残差求和逻辑,不改变输入输出维度或优化器设置,可与现有扩散训练框架(如 Hugging Face Diffusers)快速集成。
- 训练流程:在预训练或微调阶段启用自适应路由,推理时路由已固化,无额外计算开销,不影响现有推理优化(如 TensorRT、ONNX 导出)。
- 与现有技术叠加:可与 REPA 等特征对齐方法、classifier-free guidance 等采样策略兼容,适合作为基础架构升级项部署到已有生成管线中。
局限
- **动态跨层路由** 虽然只增加不到 0.1% 的参数,但每层需要计算路由权重并聚合来自不同深度的特征,训练与推理时额外计算和内存开销不可避免,可能削弱其在大规模模型或低延迟场景下的优势。此外,该方法需要从头训练或全量微调,难以直接用于已部署的预训练 DiT 模型,**迁移成本** 较高。
- 实验仅在标准图像生成数据集(如 ImageNet)上验证,对视频、3D 或音频等 **非图像模态** 的适用性未知。同时,方法基于 DiT 架构设计,对近期出现的 **Mamba 扩散模型**、**混合架构** 或其他非纯 Transformer 骨干的兼容性缺乏探索,其残差连接改进可能无法直接迁移。
- 论文中源路由策略(如 **mirror routing**、**first/last routing**)仍需依赖对内部表示的先验分析进行手工选择,尚未实现完全端到端的连接结构学习。与一些基于可微分搜索或稀疏学习的跨层连接方法相比,**人工先验** 的引入可能限制方法在未知任务或更复杂网络拓扑中的自适应能力。