In-Flight KV Cache 与 Clean Anchors:更快的自回归视频扩散
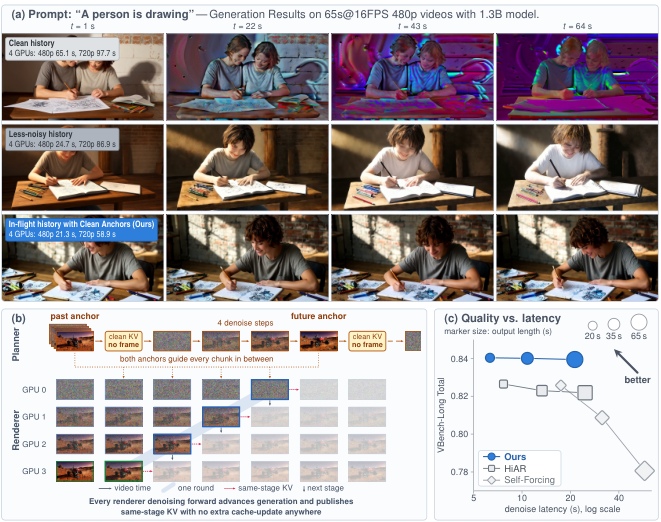
少步自回归视频扩散(few-step autoregressive video diffusion)把视频切成时间块逐块生成,每块经过一小段去噪阶段。此前方法为了记忆已生成的块,需要额外的模型前向来重建干净或低噪声的 KV cache,而不推进输出 latent。 FlashForward 直接复用每次去噪前向本身已经算出的当前块 in-flight KV,省掉大量仅用于更新 cache 的模型前向。当前块完成一个去噪阶段后,其 stage-specific cache 已可供下一块使用;因此把每个阶段分配到一块 GPU,就能让不同块并发地处在不同阶段。 这种提前可用会带来质量代价:阶段匹配的历史是带噪的,导致块间出现外观与运动漂移。为此 FlashForward 在对应区域生成之前先产生稀疏的辅助 clean anchor latents,用双边条件稳定生成轨迹。两种记忆处于不同时间尺度:稀疏 clean anchor KV 提供粗粒度、长程的双边结构引导,稠密的 stage-matched history 保留细粒度、近期的演化信息。 在最多 4 块 GPU 上,FlashForward 比 HiAR 快 1.16--1.69 倍,比 Self-Forcing 快 1.42--2.92 倍(1.3B 与 14B 规模、480p 与 720p、16 FPS、20 秒以上视频)。在 VBench 上,1.3B 模型 480p 取得更高分数,并在更长时长下保持稳定,说明它在 20s、35s、65s 时长上都能更快地生成高质量、时序一致的视频。
论文精读
TL;DR FlashForward 直接复用去噪过程中的 in-flight KV cache,省去额外缓存更新前向,并利用稀疏干净锚点稳定块间一致性,在长视频生成上实现最高 2.92 倍加速且质量更高。
问题
问题背景
少步自回归视频扩散模型将长视频切分为时间块逐块生成,每个块经过少量去噪步骤。当前研究聚焦于在保证时序一致性的前提下提升生成速度。
现有方法局限
已有方法(如 HiAR、Self-Forcing)为记住已生成块的信息,需要重建干净或低噪声的 KV 缓存,这通常通过额外的前向计算完成,且这些前向不推进输出 latent。这种 cache-update-only 前向消耗大量算力,成为速度瓶颈。同时,缓存构建与生成流程串行耦合,难以利用多 GPU 并行加速。
为什么这个问题难且重要
难点在于:如果直接复用去噪过程中的 in-flight KV 缓存作为历史记忆,虽然可以避免额外前向,但该缓存对应特定去噪阶段,噪声较大,会导致不同块之间的外观和运动漂移。如何在复用缓存加速的同时引入干净的锚点信息来稳定生成轨迹,是核心挑战。长视频生成(20 秒以上,甚至 65 秒)在视频生成、数字人、内容创作等场景有广泛应用需求,加速生成且不牺牲质量对实际部署至关重要。
行业类比
类似大语言模型长文本推理中,通过复用上下文缓存减少冗余前向,但需额外机制处理陈旧或噪声缓存,以保持输出一致性。
核心洞察
- FlashForward 的核心洞察是直接复用当前分块去噪过程中实时产生的 in-flight KV cache 作为历史记忆,避免先前方法(如 HiAR、Self-Forcing)需要额外前向重建 clean KV cache 的昂贵开销。这一设计将 KV 缓存生成与去噪计算重叠,使得每个去噪阶段完成后其 stage-specific cache 即可用于下一分块,从而允许多 GPU 按阶段流水线并发处理不同分块,实现 1.16--1.69 倍加速。
- 直接复用 stage-matched history 虽然高效,但该缓存是带噪的,会导致分块间外观与运动漂移;FlashForward 的策略是引入稀疏 clean anchor latents,为生成轨迹提供粗粒度、长程的两侧结构引导。这与以往仅依赖单侧历史或需要 clean cache 的方案有本质区别:用稀疏干净锚点弥补噪声历史的不足,同时保持稠密近期演化细节,实现了质量与速度的平衡。
方法
方法概述
输入:长视频被划分为多个时间 chunk,逐块生成。每个 chunk 经历少量去噪步(few-step diffusion),模型为 shared planner-renderer 架构。
关键模块一:Stage-Matched Renderer History(In-Flight KV Cache)
- 当前 chunk 在去噪过程中,每个 stage 的前向计算本身会自然产生该 chunk 的 KV cache,直接保存下来供下一个 chunk 作为历史信息使用。
- 这避免了以往方法(如 HiAR、Self-Forcing)需要额外 forward 重建 clean KV cache 的开销。
- 由于不同 stage 的 cache 匹配不同去噪阶段,可以按 stage 分配 GPU,形成流水线:不同 chunk 同时处于不同 stage,提升并行度。
关键模块二:Clean Anchor KV Bank(稀疏干净锚点)
- 直接复用 stage-matched history 是 noisy 的,会导致 chunk 间外观与运动漂移。
- 为此,在对应区域生成前,预先计划并生成稀疏的 clean anchor latents,将它们的 KV 作为长期结构指导。
- 两种记忆在不同时间尺度上互补:稀疏 clean anchor 提供粗粒度、长程双向结构条件;密集 stage-matched history 保留近期细节演化。
训练流程
- Phase 1:监督微调(SFT),同时训练 planner(规划 anchor 位置)和 renderer(生成视频 chunk)。
- Phase 2:自 rollout 蒸馏,让模型在自身生成序列上进一步稳定轨迹,减少漂移。
输出:支持 20s、35s、65s 长视频生成,16 FPS,480p/720p。在 1.3B 和 14B 模型尺度上,使用最多 4 个 GPU 时,速度比 HiAR 快 1.16–1.69 倍,比 Self-Forcing 快 1.42–2.92 倍;VBench 指标在 1.3B@480p 上超越 HiAR 且长时稳定。
差异点:不同于 HiAR 等需要额外 forward 构建 clean KV cache 的方法,FlashForward 直接复用去噪过程中的 in-flight KV,并用 clean anchors 补偿噪声历史,实现多 GPU 流水线加速。
实验
实验设计
FlashForward 在 few-step autoregressive video diffusion 框架下评估,覆盖 1.3B 与 14B 主干规模、480p 与 720p、16 FPS 和 20 秒以上视频。使用最多四块 GPU 以流水线方式并行执行不同 denoising stage,基线包括 HiAR 与 Self-Forcing。质量评测采用 VBench,考察 20s、35s、65s 时长。
关键发现
- 速度:FlashForward 比 HiAR 快 1.16–1.69 倍,比 Self-Forcing 快 1.42–2.92 倍。
- 质量:在 VBench 上,1.3B 模型 480p 取得更高分数,且随时间延长保持稳定性,未出现明显质量衰减。
- 稳定性:通过稀疏 clean anchor KV 提供粗粒度双向结构引导,抑制 stage-matched cache 中的噪声导致的 appearance/motion drift。
对比解读
FlashForward 直接复用每个 denoising stage 产生的 in-flight KV cache,避免额外的 cache-update-only forwards。HiAR 与 Self-Forcing 需要先构建干净缓存,前向次数更多。FlashForward 的 stage-matched history 虽噪声较高,但配合 two-sided conditioning 下的 clean anchors,形成不同时间尺度的记忆分工:稀疏 anchor KV 负责长程结构,密集 history 保留近期演化。该设计在 wall-clock 加速与生成质量之间取得平衡,为长视频生成提供更高效的推理范式。
行业影响
落地场景
FlashForward 适合对长视频生成时延敏感的产品,例如:
- 电商虚拟试衣 / 商品展示:用户上传图片后,生成 20s 以上连贯模特展示视频,替代传统实拍。
- 内容平台的短剧 / 预告片自动生成:自动扩展短剧本为 1 分钟以上视频,或从长视频中自动剪辑高光片段。
- 教育动画课件:批量生成历史事件、科学原理的分镜动画,需要长时间保持角色与场景一致性。
商业价值
- 降本:与 HiAR 相比加速 1.16–1.69 倍,与 Self-Forcing 相比加速 1.42–2.92 倍,在相同 GPU 集群上视频生成吞吐量显著提升,单秒视频推理成本下降。
- 增收:支持 65s 级长视频稳定生成且质量不退化(VBench 指标更高),可解锁长时长付费套餐或高端广告定制订单。
- 体验提升:用户等待时间缩短,且跨块外观和运动漂移被抑制,长视频观感更连贯,减少人工后期修复成本。
与现有产品 / 工作流的接口
- 替换缓存策略:现有自回归视频扩散模型(如 HiAR、Self-Forcing)通常需要额外前向构建 KV cache,FlashForward 直接复用在飞 KV cache,只需改动缓存复用与调度逻辑,主干网络可保持不变。
- 多 GPU 流水线集成:算法按去噪阶段分配 GPU,需要底层推理框架支持波前调度(wavefront scheduling)。可参考论文附录 A 的延迟与显存分析,将其适配到 Ray Serve / Triton 等推理服务中。
- 训练侧接口:若采用论文的时间重基 SFT + 自滚动蒸馏两阶段训练,需对现有模型做少量微调;但推理阶段可直接加载微调后的权重,无需额外硬件改造。
具体 use case:
- 电商直播代播:输入商品 3D 模型或图片,实时生成虚拟主播解说视频,要求 720p、20s 以上且动作不漂移。FlashForward 的加速比使单卡可同时服务多个直播流,降低实时渲染成本。
- 企业培训视频自动化:从文本 SOP 生成合规操作演示动画,需 1 分钟以上且步骤间一致性高。干净锚点提供的长程结构引导能避免不同片段间装备或环境突变。
局限
- 该方法依赖多 GPU 流水线并行来获得加速,单 GPU 场景下由于额外的锚点生成与缓存管理开销,实际加速可能有限甚至不如基线。论文主要展示了最多 4 个 GPU 的加速效果,未系统评估单 GPU 或更少 GPU 下的性能与效率权衡,限制了在资源受限环境的部署。
- 干净锚点 KV 的生成需要额外的 planner 网络和两阶段训练(监督微调 + 自滚动蒸馏),增加了训练复杂度和显存占用。锚点仅覆盖稀疏位置,可能无法完全消除长视频中的外观和运动漂移,尤其在快速运动或复杂场景下仍可能出现块间不一致。
- 实验评估主要基于 VBench 自动指标和有限的人工评估,未充分展示在真实开放域视频上的鲁棒性。仅测试了 1.3B 和 14B 模型,对于更大规模模型或更高分辨率(如 1080p)的扩展性仍需验证。