KeyRec: 面向流式与长视频理解的有界视觉记忆
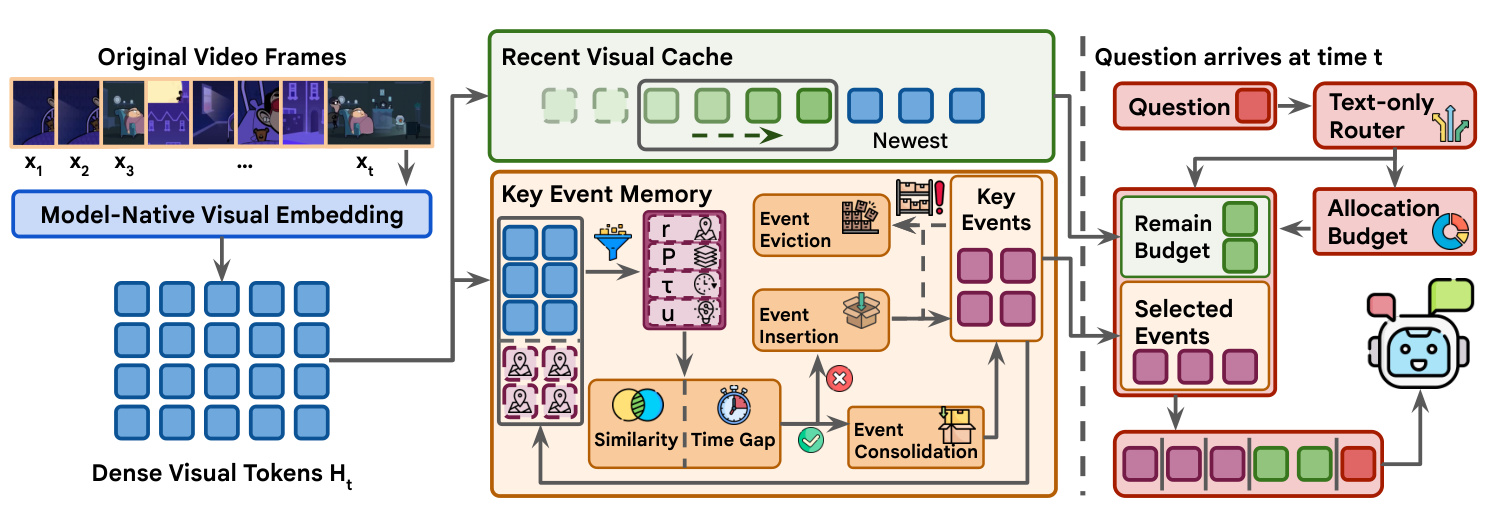
视觉语言模型 越来越多地被用于理解长视频与连续视频流。然而,密集视觉 token 随视频时长累积,使长上下文推理成本高得难以承受。现有的免训练视觉 token 选择方法通过保留信息量大的 token 来降低成本,但可能丢失连贯的事件证据,也无法区分近期细节观测与长程历史。 我们提出 KeyRec,一个用于构建 有界视觉记忆 的免训练框架: - 在 与查询无关的写入阶段,KeyRec 将细粒度的近期观测保存在视觉缓存中,并把历史证据组织为结构化的 事件库;候选事件依据其相对已存事件的新颖性被提出,并通过在线的 add–merge–evict 更新加以维护。 - 当问题到来时,一个 纯文本路由器 在近期记忆与事件记忆之间自适应地分配固定的读取预算,无需重新处理历史帧。 KeyRec 作用于面向模型的视觉 embedding,同时支持模块化的 encoder–projector VLM 以及无需 encoder 与 projector 的 NEO-ov 架构。在四个 流式与长视频 基准和三个 VLM 骨干上,KeyRec 仅用 10% 的面向 decoder 的密集视觉 token 预算,就在 15 个设置中的 13 个取得最佳压缩性能:在实时问题上超越最强压缩基线 2.21–18.37 分,在 6 个长视频设置中的 5 个取得最佳压缩结果,并在所有 NEO-ov 2B 设置中表现最佳。
论文精读
TL;DR KeyRec 训练无关地为流式和长视频构建有界视觉记忆:细粒度缓存最近帧、结构化事件库压缩历史,并用文本路由器自适应分配固定读取预算,仅用 10% 视觉 token 在多数基准上取得最优压缩性能。
问题
问题背景
随着视觉语言模型(VLM)在长视频与连续流理解中的普及,视觉 token 数量随视频时长线性增长,导致长上下文推理成本 急剧上升,成为实际部署的主要瓶颈。
现有方法局限
现有 training-free 视觉 token 选择方法 通过保留“有信息量”的 token 降低计算量,但存在三方面不足:
- 事件连贯性丢失:独立挑选 token 可能破坏关键事件的时间一致性,导致回答需要连续证据的问题时性能下降。
- 近期/历史区分不足:无法同时保留细粒度近期观察与结构化历史事件,常将两者混为一谈,影响对时序敏感问题的响应。
- 在线更新困难:多数方法需重新处理全部历史帧才能更新记忆,缺乏增量维护有界缓存的机制,难以适应流式设置。
为什么难且重要
在有界内存预算下构建结构化视觉记忆 面临核心挑战:
- 需在线判断事件新颖性,执行合并与淘汰,同时保持对近期帧的精细编码。
- 查询到达时,需自适应分配固定读取预算给近期记忆与历史事件记忆,而非简单回放全部历史帧。
该问题在视频问答、监控分析、具身智能等场景中具有高业界关注度,因为实际系统无法无限存储视觉 token,必须设计压缩且可增量更新的记忆机制。
行业类比
类似自动驾驶 中的环视视频流:车辆需持续理解周围环境,并在被询问“刚才经过的行人是否穿红衣”时,能从有界缓存中检索相关事件,而非重放全部历史帧。
核心洞察
- 事件级记忆而非 token 级选择。现有训练无关的视觉 token 选择方法通常基于显著性独立保留信息量大的 token,容易丢失跨帧的事件连贯性。KeyRec 提出以事件新颖性驱动历史压缩,将视觉历史组织成可在线更新的事件库(event bank),通过 add-merge-evict 维护结构化语义,从而保留证据的完整性与事件边界。这一点与 token 级剪枝形成本质差异,在长视频问答中能够提供更稳定的上下文支撑。
- 查询自适应的固定预算读取。传统压缩方法在写入阶段就决定保留哪些视觉信息,与后续查询无关。KeyRec 引入一个 text-only router,在读取阶段根据问题动态分配固定读取预算给 recent cache 和 event bank,无需重新处理历史帧即可平衡近期细节与长程事件。该机制将压缩策略与查询解耦,既满足流式场景的低延迟约束,又提升了针对不同问题类型的证据召回效率。
- 面向 model-facing embeddings 的架构通用性。KeyRec 直接操作模型内部的视觉嵌入,不依赖特定的 encoder-projector 结构,因此既能用于模块化 VLM(如 LLaVA 类架构),也能用于 encoder/projector-free 的 NEO-ov 原生一视觉模型。这种设计降低了对底层视觉编码器假设的限制,使有界视觉记忆方法可以迁移到更广的多模态模型家族,为流式与长视频理解提供了统一的压缩接口。
方法
输入与总体流程
KeyRec 接收连续视频帧流,经 VLM 视觉编码器(或 NEO-ov 的无编码器投影)得到模型面向的视觉嵌入(model-facing visual embeddings),不保留原始帧;整个框架训练无关(training-free),不修改模型权重。
查询无关写入(query-agnostic writing)
- 近期视觉缓存(recent visual cache):缓存最近一小段帧的细粒度嵌入,保留实时细节。
- 关键事件记忆(key event memory):将更早的历史帧组织为结构化的事件银行。候选事件按相对已存事件的新颖性评分,再通过在线添加-合并-淘汰(add--merge--evict)规则更新:高新颖且不重复的事件加入,相似事件合并,低价值事件淘汰,使记忆规模有界。
查询自适应固定预算读出(query-adaptive fixed-budget readout)
- 当问题到达,文本专用路由器(text-only router)根据问题语义,在近期缓存与事件记忆之间动态分配固定的视觉 token 读出预算。
- 选中的记忆段以分段呈现(segmented memory presentation)方式拼接,输入 VLM 生成答案;整个过程无需重新处理历史帧。
差异点
KeyRec 通过分离细粒度近期观察与结构化历史事件,并用文本路由器动态调度读出预算,在保留连贯事件证据的同时避免重复编码历史帧,优于仅做 token 选择的现有方案。
实验
实验设计
KeyRec 在四个流式与长视频基准上,使用三个 VLM 骨干(模块化 encoder–projector 与 NEO-ov 架构)进行评估。统一采用 10% 的 decoder-facing visual-token budget 作为压缩条件,与多种训练自由视觉 token 选择方法对比。评估覆盖实时问答、长视频问答和流式 setting 共 15 个场景。
关键发现
KeyRec 在 15 个设置中 13 个取得最佳压缩性能;在实时问题上比最强压缩基线高出 2.21–18.37 分;在六个长视频设置中五个最佳;在 NEO-ov 2B 所有设置中最佳。其有界视觉记忆设计(recent cache + event bank + query-adaptive router)有效保留细粒度近期观察和历史事件证据,避免历史帧重处理,且完全 training-free。
基线对比
与传统训练自由 token 选择方法相比,KeyRec 不仅保留信息量最大的 token,还通过事件新颖性维护结构化事件库,区分近期细节与长程历史,因此在需要事件连贯证据的任务上优势明显。优于最强压缩基线最多 18.37 分,说明传统 token 采样可能丢失关键事件链。在无 encoder 的 NEO-ov 架构上依然最佳,表明方法对视觉嵌入格式不敏感,工程落地价值高。
行业影响
落地场景
KeyRec 适用于需要持续处理长视频或实时视频流的 AI 产品,例如:
- 视频内容平台:长视频摘要、自动章节划分、用户问答,在保持准确率的同时降低视觉 token 计算开销。
- 电商直播分析:实时识别商品、讲解事件、用户互动,支持长时间直播流的低成本理解。
- 自动驾驶数据闭环:对行车记录仪长视频进行事件检索、场景标注,压缩存储与推理成本。
- 安防监控:连续视频流的事件检测与回溯,仅保留关键事件 evidence,压缩率高达 90%。
商业价值
KeyRec 的核心价值体现在降本与体验提升:
- 降本:仅使用 10% 的视觉 token 预算,显著降低长视频推理的显存占用和 GPU 成本,适合大规模视频处理任务。
- 体验提升:通过
query-adaptive分配固定 readout budget,优先读取 recent observations 或事件 bank,保证回答质量,增强交互体验。 - 无需训练:训练无关,可直接应用于现有 VLM 推理,降低部署门槛。
与现有工作流的集成
KeyRec 作为模型前端的视觉记忆构建模块,可插入现有 VLM pipeline:
- 支持 modular encoder-projector VLMs 和 NEO-ov 等 encoder-free 架构,兼容性广。
- 实现为 query-agnostic 写入 + query-adaptive 固定预算读出,无需 reprocessing 历史帧,适合在线流式场景。
- 与现有 token 选择方法(如 FastV、SparseVLM)相比,KeyRec 保留结构化事件证据,且不依赖训练数据,更容易作为插件集成。
具体落地 Use Case
- 电商直播智能客服:直播中实时识别商品讲解、价格、优惠活动,用户提问时快速定位相关事件,生成回答,无需处理全部视频帧,降低延迟和成本。
- 长视频内容平台自动章节与问答:对纪录片、教程视频构建事件银行,用户可对任意历史片段提问,系统仅需读取少量事件 token,即生成准确回答,提升用户体验和平台粘性。
局限
- **事件合并与淘汰策略**依赖启发式阈值和固定容量,在超长视频或无限流场景下可能丢失关键线索。在线 `add--merge--evict` 更新仅基于**新颖性**(novelty)决定事件保留,未显式建模事件的语义重要性或未来的查询相关性。当视频时长持续增长(例如多天监控),合并操作可能将稀疏但关键的事件过度抽象,而淘汰操作可能移除罕见但重要的历史证据。论文未给出针对无限流输入的理论分析或自适应容量调节机制,实际部署时仍需人工调整事件粒度与合并阈值。
- **KeyRec 的性能受限于基础 VLM 的视觉 embedding 质量**。方法直接操作模型侧视觉 token,若底层编码器对细粒度视觉特征(如小物体、快速动作)提取不足,recent visual cache 和 event bank 的构建能力会明显退化。此外,论文对 encoder- 和 projector-free 架构的验证仅使用 **NEO-ov 2B** 参数模型,未涉及更大规模或不同设计风格的 NATIVE one-vision 模型,泛化性证据尚不充分。对更高分辨率或更长上下文的视频,视觉 cache 的 token 压缩率可能需要重新权衡。
- **Query-adaptive readout 的 text-only router 设计较为轻量**,未经过可训练优化,可能难以处理复杂查询意图。在需要多跳推理或同时关注多个时间片段的场景下,固定的读取预算在 recent 和 event memory 之间二分,可能无法动态分配足够的 token 给关键事件集。与可训练的记忆控制器(如基于强化学习或注意力机制的选择器)相比,训练无关 router 在精细控制能力上存在固有局限,虽然降低了训练成本,但可能在部分任务上达不到最优分配。