Omni-IO Skills: 让 Agent 实现 Omni-Native
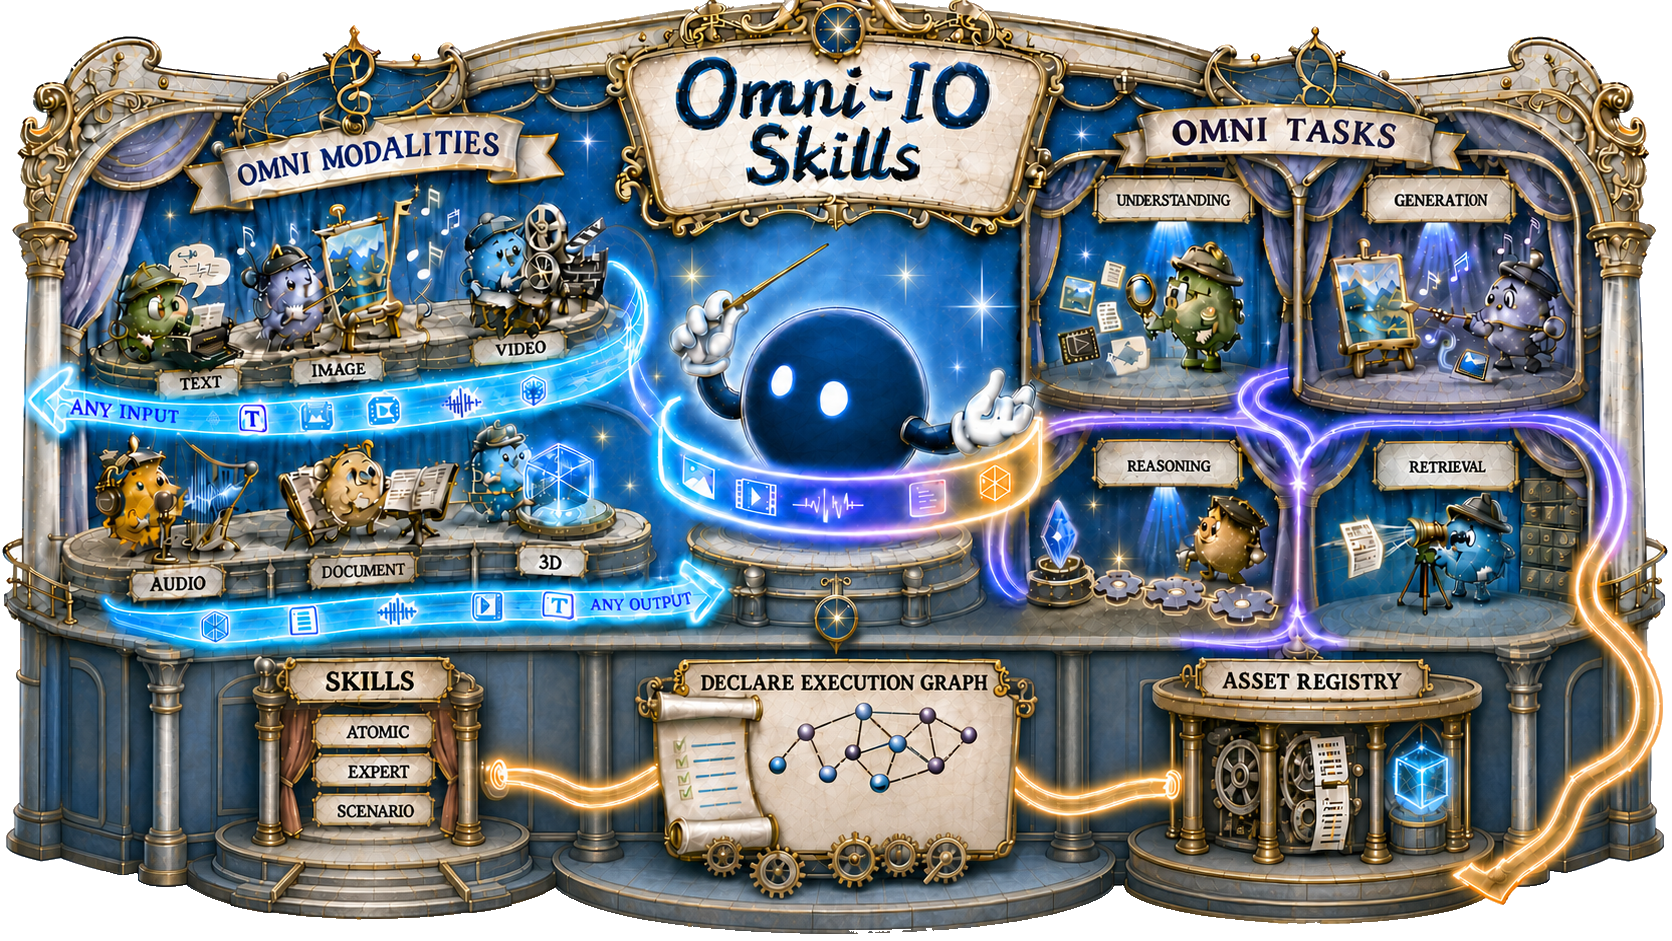
通用 agent 可进行长程规划、推理与行动,但其生产能力仍分散在文本、图像、音频、视频、文档、3D 资产与代码之中。为基座模型扩展模态会把能力增长绑定在昂贵的模型更新上,而拼装专用模型与工具又留下一个悬而未决的问题:流程、依赖、中间资产与跨轮修订该如何协调。 Omni-IO Skills 是一个即插即用的 Agent Harness,通过分层 Skills、标准化多模态执行接口、依赖感知编排以及持久化 Asset Registry,让现有 agent 变为 omni-native。多资产工作流被表示为 Declare Execution Graphs,可并发调度独立操作,并将成功输出登记以供下游与跨轮复用,且执行后端可替换。 其 27 个 Skills 覆盖 38 个代表性任务,横跨七种产物模态与四类能力族:理解、生成、推理与检索。在 UniM-90 上,该 harness 将 GPT-5.6 Sol 与 Claude Sonnet 5 的输入支持率分别从 40.00% 与 38.89% 提升至 100%,并将相对 Semantic--Quality Coupled Score 分别从 26.99 提升到 74.94、从 27.82 提升到 77.78;Strict Structure Score 达到 100.00 与 99.78。 这些结果表明,harness 级能力组合 是一条实用路径:无需改动宿主 agent 的推理核心,即可构建覆盖广泛、可持续演进的 Omni 系统。
论文精读
TL;DR Omni-IO Skills 以即插即用 Harness 为现有 Agent 注入 27 项多模态 Skills,覆盖 7 种模态与 4 类能力,在 UniM-90 上将输入支持率提升至 100%,且不改动宿主推理核心。
问题
问题背景
通用 agent 在长程规划、推理与动作执行上已取得显著进展,但生产环境中的多模态能力仍被割裂在文本、图像、音频、视频、文档、3D 资产和代码等不同管道中。
现有方法局限
扩展基础模型至新模态意味着将能力增长绑定到昂贵的模型更新周期上——每次新增模态都需要重新训练或微调,成本高且难以快速迭代。另一种常见路线是组装专家模型和外部工具,但这种方式缺乏统一的多模态执行接口,无法有效协调跨模态流程中的过程(procedures)、依赖关系(dependencies)、中间资产(intermediate assets)以及跨轮次修改(cross-turn revisions)。多资产工作流往往需要人工拼接多个单模态组件,导致错误传播和资源浪费。
为什么这个问题难且重要
多模态生产任务通常涉及多个依赖步骤,例如从文本生成 3D 模型、再渲染为视频帧、同时处理音频轨道,并要求中间产物能被下游步骤或后续用户修订复用。这需要依赖感知的编排、并发调度、资产持久化与跨模态检索等能力,而现有 agent 框架缺少系统化的支持。业界对可演进的 Omni 系统需求强烈:在不改变宿主 agent 推理核心的前提下,通过可插拔的 skill 层组合跨模态能力,是成本与工程可行性之间的平衡点。
行业类比
类似一条从自然语言描述直接生成可编辑 3D 场景并输出配套视频与音频的流水线,若没有统一的执行图和资产注册表,每一步转换都需要重新生成或手动传递中间文件,效率与一致性都难以保证。
核心洞察
- Omni-IO Skills 的核心洞察是把多模态能力的扩展从模型内部转移到 Agent Harness 层,通过标准化技能接口和层次化技能组合,让现有代理无需修改推理核心即可处理任意模态输入输出。
- 与直接训练 Omni 基础模型或简单拼接专家模型不同,该方法用 Declare Execution Graphs 显式表达多资产工作流中的依赖关系,配合持久 Asset Registry 实现跨步骤、跨轮次的资产复用与修订,解决了此前工具调用方案中流程协调和中间产物管理缺失的问题。
方法
输入
用户下达的多模态任务描述(涉及文本、图像、音频、视频、文档、3D 资产、代码等,可组合跨模态理解、生成、推理、检索),宿主 agent(如 GPT-5.6 Sol、Claude Sonnet 5)接收自然语言指令。
关键模块
Omni-IO Skills 作为可插拔 Agent Harness,通过分层技能与依赖感知编排扩展宿主能力:
- Skill Entry Layer:将高层意图声明式地分解为层级化 Omni-IO Skills。每个 Skill 定义标准化输入/输出 schema 与前置依赖,支持从复合任务到原子操作的递归展开。
- MCP Tool Service Layer:统一 multimodal 执行接口,屏蔽不同后端工具(模型、API、本地脚本)的差异,实现工具调用与参数注入的标准化。
- Provider and Configuration Layer:管理可替换的执行后端与配置,支持动态选择最优 provider 或降级。
- Asset Registry Layer:持久化记录中间产物(图像、音频、代码片段等)的元数据与引用,支持跨步骤、跨轮次复用。
- Dependency-Aware Orchestration:将多资产工作流构建为 Declare Execution Graphs (DEG),通过图验证、波次调度并发执行无依赖操作,处理失败重试与部分回滚;运行时根据图拓扑路由工具并注入上游资产引用。
输出
任务执行结果(生成产物、推理结论或检索结果),同时将有效输出注册到 Asset Registry,供后续任务或会话复用。
工程启示:这种 harness 层组合能力的方式避免了修改基础模型权重,也解决了单纯拼接 specialist tools 时过程协调缺失的问题;DEG 的波次调度天然适配多模态流水线中的并发与依赖管理。
跟同类方法的差异点:相比扩展基础模型或零散组装专家工具,Omni-IO Skills 在宿主 agent 核心不变的前提下,通过声明式技能分层与资产生命周期管理实现全模态能力,演化成本更低且协作语义更完整。
实验
实验设计
论文在 UniM-90 基准上评估 Omni-IO Skills 的通用能力,该基准包含 38 个代表性任务,覆盖文本、图像、音频、视频、文档、3D 资产、代码共 7 种模态,以及理解、生成、推理、检索 4 类能力家族。实验选取 GPT-5.6 Sol 与 Claude Sonnet 5 两个宿主模型,对比加入 harness 前后的表现,重点关注输入支持率、语义-质量耦合分数与严格结构分数。
关键发现
- 输入支持率 从原始模型的 40.00% / 38.89% 提升至 100%,表明 harness 使宿主模型能够处理全部模态输入。
- 相对语义-质量耦合分数 分别从 26.99 / 27.82 提升至 74.94 / 77.78,相对提升约 2.77 倍与 2.80 倍,说明生成内容与输入语义对齐且质量显著改善。
- 严格结构分数 达到 100.00 / 99.78,几乎满分,验证了依赖感知编排与资产注册表能生成结构正确的多资产工作流。
基线对比解读
原始 GPT-5.6 Sol 与 Claude Sonnet 5 虽然推理能力强,但缺少统一的多模态执行接口与跨步骤协调机制,导致大量任务无法接收输入或生成结构混乱。Omni-IO Skills 通过分层技能、声明式执行图与持久化资产注册表,在不修改模型核心的前提下补齐了能力碎片,证明工具链与编排层是解锁 Omni 能力的关键。该结果与直接扩模态模型的方法相比,更具可演化性与部署灵活性。
行业影响
落地场景
Omni-IO Skills 可直接嵌入需要多模态资产处理与长流程协作的产品线:
- 电商内容生成:从商品图片自动生成 3D 展示、营销视频、结构化规格表,减少多工具拼接。
- 企业知识管理:统一处理 PDF、扫描件、音视频会议记录与代码仓库,提取可检索的跨模态索引。
- 内容平台审核与增强:同时处理视频、音频、图像中的实体与语义,输出可复用标注。
商业价值
- 降本:以 harness 插件扩展能力,避免为每个新模态重新训练或微调基础模型,显著降低模型更新与维护成本。
- 增效:在 UniM-90 上,输入支持率从 ~40% 提升到 100%,减少人工兜底与工具切换,交付周期大幅缩短。
- 体验提升:多模态自动化让产品迭代更快,例如电商 SKU 覆盖更全、内容平台标签更丰富,间接拉动转化。
与现有 stack 的集成
- 以 MCP tool service 形式暴露 27 个 Skills,兼容 OpenAI/Anthropic 等 agent 的标准化 tool calling。
- Declare Execution Graph 可对接 Airflow、Temporal 等工作流引擎,显式管理依赖、并发执行与失败重试。
- Asset Registry 作为持久层接对象存储与向量库,支持跨 turn 复用中间资产,保护已有基础设施投资。
- 执行后端可替换,便于混合云/本地 GPU 调度。
具体用例:某跨境电商平台在新品上架时,上传产品图后由 agent 自动生成多语言卖点、3D 展示和风格化场景图,原本需多个 specialist 模型串联,现在一个 harness 调度,交付从小时级降到分钟级。短视频平台则可利用 DEG 并发执行 ASR、CV、OCR 任务,自动生成分段、字幕与封面,并注册结构化片段供后续检索与推荐复用。
局限
- - **技能覆盖与扩展性受限**:论文提出的 27 个 Skills 覆盖 38 个代表性任务,但在真实世界中模态和任务组合可能超出预定义范围。添加新技能仍需领域专家人工定义层次化技能和依赖图,无法从数据中自动学习,限制了开放域任务的自适应性。此外,随着技能数量增加,技能组合可能出现组合爆炸,文中未讨论大规模技能库的管理与冲突消解机制。与端到端多模态大模型相比,该 harness 依赖预先设计的技能,灵活性和泛化能力有限。
- - **实验评估广度不足**:评估仅在 GPT-5.6 Sol 和 Claude Sonnet 5 两个闭源模型上进行,未覆盖开源模型或不同规模模型,无法验证 harness 对基础模型能力的依赖程度。UniM-90 基准可能偏重结构化任务,缺乏真实世界中模糊、长程、多轮交互任务的评估。此外,未与 LangChain、AutoGen、HuggingGPT 等主流 agent harness 直接对比,难以定位相对优势。指标主要关注输入支持率和语义质量,未报告端到端延迟、计算开销、错误恢复率等工程关键指标。
- - **系统复杂度与运行时开销**:依赖感知编排和 Asset Registry 增加了系统复杂度,DEG 构建与调度需要额外计算,并发执行受限于后端资源,文中未提供性能基准。跨轮资产重用可能引入陈旧资产或不一致问题,尤其在多用户并发修改时,缺乏版本控制和失效机制。系统假设执行后端可靠且工具调用成功,对工具失败和部分成功的处理较为简单,可能影响长程工作流的鲁棒性。