JEV-as-a-Judge: 置信时接受,不确定时升级
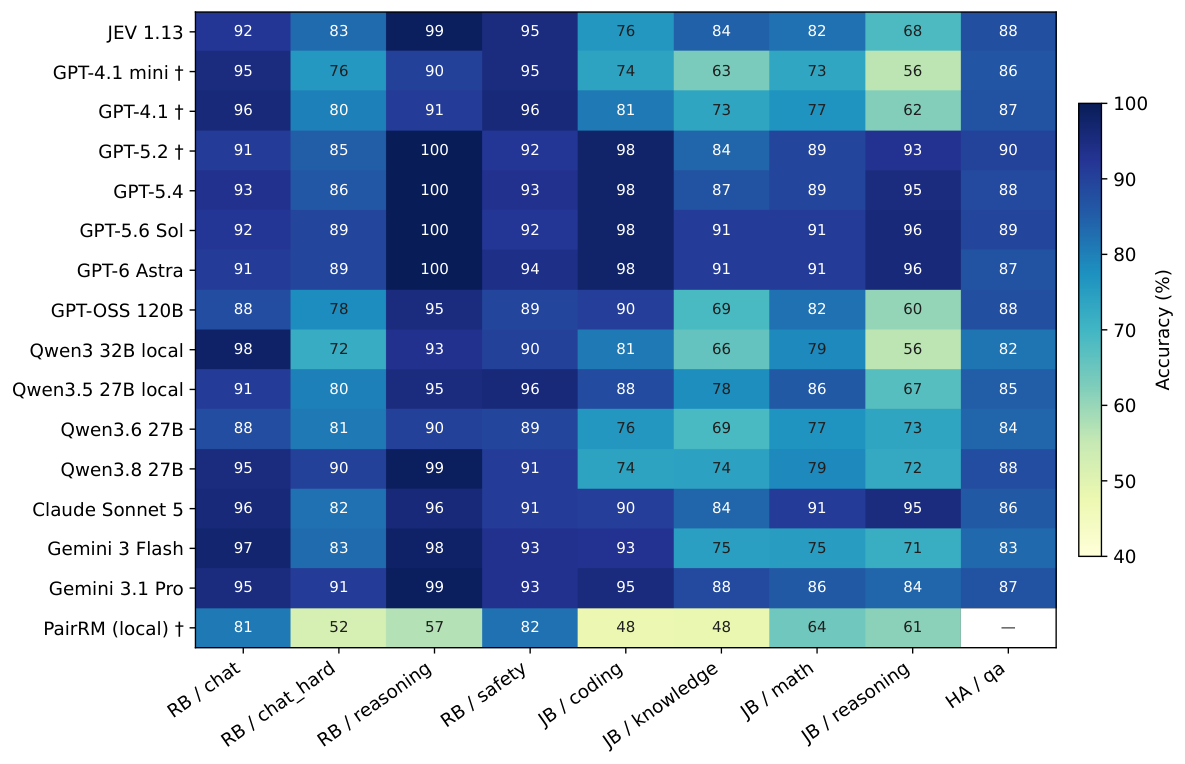
LLM-as-a-judge 支持跨多样任务的评估,但在规模化场景下,推理成本与置信度可靠性成为关键问题。我们探究一个仅输出决策的 judge 是否能提供经济的首轮评估,并识别何时需要更强的评估手段。 我们将 JEV-as-a-judge 与 16 个生成式与奖励模型 judge 进行对比,并采用盲审人工裁定。结果显示: - 在常规偏好与证据支撑的事实性任务上,它与最强的生成式 LLM judge(即我们的最强基线)相差不超过 3 个百分点,而费用仅为其 0.36%; - 当判断需要检查推导过程或抵抗精心编写的错误答案时,差距会明显扩大; - 在若干 benchmark 上,JEV 与最强基线的差距集中在低置信度决策上。 基于此,一个冻结的级联策略会接受高置信度的判定,并将不确定的判定升级处理,从而以更低成本保留了最强基线 99% 的准确率。
论文精读
TL;DR JEV-as-a-Judge 证明:一个仅输出决策的轻量 judge 能以 0.36% 的成本接近 SOTA LLM judge 的准确度,并通过“自信即接受、不确定即升级”的级联策略保留 99% 准确率。
问题
问题背景
LLM-as-a-judge 已成为自动化评估的主流范式,但推理成本与置信度可靠性在大规模部署中成为关键瓶颈。
现有方法局限
当前主流 judge 依赖生成式 LLM 或奖励模型,每个样本消耗大量 token 与费用;部分工作尝试轻量 judge,但要么牺牲准确率,要么缺乏可校准的置信度,无法安全决定何时升级到更强 judge。此外,生成式 judge 易受答案风格、长度等 presentation bias 影响,confidence 输出不稳定,难以直接用于 economical escalation。
为什么难/重要
决策型 judge(decision-only judge)仅输出二元或离散标签,信息量少,必须通过校准或排序机制保证其不确定性估计与真实错误相关,否则 deferral 策略可能错过真正需要强 judge 的样本。业界关注此问题,因为在线评估、RLHF、内容审核等场景每天处理海量样本,全部调用超大模型成本不可接受,需要多级评估流水线。
行业类比
类似于推理服务中的分层缓存 + 高精模型,先由轻量模型快速响应,仅当置信度低时才调用昂贵的 LLM,以维持高吞吐与低成本。
核心洞察
- 决策型轻量 judge(JEV)以极低成本提供第一遍评估,并通过置信度触发升级到强 judge,实现接近 SOTA 的准确率。这一角度独特在于,JEV 不是对 LLM-as-judge 的简单压缩或蒸馏,而是显式利用决策置信度构建冻结级联,将昂贵 judge 的调用集中在不确定样本上。相比直接使用单个生成式 judge 或 reward model,它在普通偏好和证据基础事实性任务上仅以 0.36% 的推理费用保留 99% 的准确率,表明大规模评估中成本与可靠性可以通过计算路由而非模型规模来解耦。
- JEV 与强 judge 的错误模式具有互补性,其低置信度输出恰好对应与 SOTA judge 分歧最大的区域,这为选择性升级提供了强信号。独特之处在于,论文不是依赖传统不确定性估计或集成投票来提升判断质量,而是发现置信度可以同时排序模型自身错误和跨 judge 差异,因此一个固定的置信度阈值即可构建有效的级联策略,无需在线学习或复杂元模型。这种轻量、可复现的机制对需要高频批量评估的工程系统很有参考价值。
方法
输入与输出契约
JEV-as-a-Judge 接收标准化的评估请求:一段待评估文本(如响应偏好对或事实性声明)与任务指令,输出一个二元判定(如 A 优于 B / 声明是否真实)以及一个标量置信度分数。输出遵循严格 schema,不生成自由文本解释,保证低成本与高吞吐。
关键模块
- 决策型评判器:JEV 本身是一个轻量模型,仅输出预定义类别标签,避免自回归生成解释,将单次推理费用压缩至 SOTA LLM judge 的 0.36% 量级。
- 置信度估计:通过模型内部 calibrated logits 或多采样一致性计算置信度,使置信度分数与真实错误率单调相关。
- 冻结级联策略:采用两级冻结路由——当 JEV 置信度高于阈值时直接接受判定;否则将样本升级至强生成式 LLM 评判器。阈值在验证集上选定,不在线上更新。
- 错误互补性分析:论文实证表明 JEV 与强评判器的分歧集中在低置信区间,因此升级可以回收大部分精度损失(保留 99% 比较器准确率)。
跟同类方法的差异点
与多数 LLM-as-a-judge 工作直接追求强模型的解释性或可微路由不同,JEV 将决策与置信度解耦,用固定阈值级联而非端到端学习路由器,以工程上可解释、可审计的方式实现经济与准确的平衡。
实验
实验设计
JEV-as-a-judge 被设计为 决策型判断器,与 16 个生成式与奖励模型法官同台比较。评估基于四个内部基准:PAIR(响应偏好)、HALL(证据支撑事实性)、FINAL(最终承诺裁决)、EVIDENCE(合成对照)。所有判断均经过盲测人类裁决作为 gold label。实验还引入置信度排序与错误互补性分析,并测试冻结的两级级联策略:接受自信判断、升级不确定判断。
关键发现
- 在 普通偏好 与 证据支撑事实性 任务上,JEV 与 SOTA LLM judge 的准确率差距不超过 3 个百分点,但推理费用仅为后者的 0.36%。
- 当判断需要检查推导步骤或抵抗精心编写的错误答案时,差距明显扩大。
- 在多个基准上,JEV 与 LLM judge 的误差集中在低置信度决策中;置信度能有效排序误差。
- 采用冻结级联策略(自信即接受、不确定即升级),可在更低总体成本下保留 comparator 99% 的准确率。
与基线的深度对比
JEV 作为第一道经济过滤器,在常见偏好与事实性评估中能以极低成本逼近 LLM judge,显示出决策型判断器在规模化评测中的实用价值。其不足集中在复杂推理与对抗性样本,这些场景需要 LLM 的深层语义理解。级联策略通过选择性升级实现成本与准确率的最佳平衡:大部分简单样本由 JEV 直接处理,少量困难样本升级至昂贵 LLM,既避免全量高成本,又保住整体质量。相比奖励模型法官,JEV 的决策逻辑更透明,且置信度信息可作为可靠的升级信号。
行业影响
落地场景
JEV-as-a-Judge 特别适合需要大规模、低成本、快速评估的 AI 产品与业务。
- 内容平台:对用户生成内容的偏好评测、证据事实性校验,作为第一道筛选,快速识别明显低质或违规内容。
- 电商:评估商品评论摘要、推荐理由生成质量,降低人工审核与昂贵 LLM 法官的调用频率。
- 企业服务:在客服对话质量监控、RAG 检索结果相关性评估中,JEV 先给出初判,置信度低时再升级到更强的 LLM judge 或人工复核。
商业价值
核心在于降本。JEV 在普通偏好与证据事实性任务上,以 0.36% 的成本 达到 SOTA LLM judge 的 3 个百分点内准确度,冻结级联策略可保留 99% 的准确度。这意味着在大规模评测中,API 调用费用可降低两个数量级,同时维持评估质量。对于需要频繁评估生成内容的业务(如在线模型监控),能显著加速模型迭代周期,间接提升研发效率和产品体验,增收潜力来自更快上线高质量模型。
跟现有产品/工作流的接口
JEV 可作为轻量级评估库或服务集成到现有 ML 流水线:
- 在 CI/CD 中作为预筛选 judge,输出
verdict+confidence_score,设定阈值触发升级。 - 与现有 LLM-as-a-judge 框架(如 MT-Bench、Prometheus)配合,作为第一级;不确定时调用第二级 LLM judge 或人工标注。
- 提供简单的 API,输入
prompt和response,输出accept/escalate决策,方便嵌入数据标注、强化学习 reward 模型训练等 pipeline。
局限
- **困难正确性任务上差距明显**:论文自身承认,当评判需要检查推导过程或抵御精心编写的错误答案时,JEV 与最强对比评委的准确率差距会显著扩大。这意味着在数学证明、代码逻辑、复杂推理等场景下,仅依赖决策式 JEV 作为第一道筛选可能漏掉关键错误,仍需强制升级到更昂贵的生成式评委,削弱了成本节省的优势。级联机制虽能缓解,但无法完全弥补模型本身在深层语义判断上的缺陷。
- **置信度信号并非始终可靠**:摘要指出“Where the signal weakens”,即部分基准上 JEV 的置信度与决策正确性的相关性减弱。这直接动摇级联策略的基础:当不确定度不能有效预测错误时,接受自信裁决可能保留错误,升级不确定裁决也可能浪费预算在实际上正确的样本上。如何动态校准置信度阈值、是否需要针对不同任务类型调整信号,论文未给出通用的自适应方案,仅采用冻结策略,限制了其在不同分布数据上的鲁棒性。
- **评估范围与对比基线有限**:论文主要聚焦普通偏好和基于证据的事实性任务,对开放式生成、多跳推理、创造性任务等覆盖不足。同时,成本对比主要针对单一 SOTA 生成式评委,未充分讨论与其他低成本评委或奖励模型级联时的累计开销与增益。此外,实验中的级联策略是冻结的,未探索基于在线反馈的自适应升级策略,可能错失进一步降低总成本的机会,也尚未在动态变化的模型生态中验证长期有效性。