跨阵营指责:丹麦议会的政治对比与责任归因
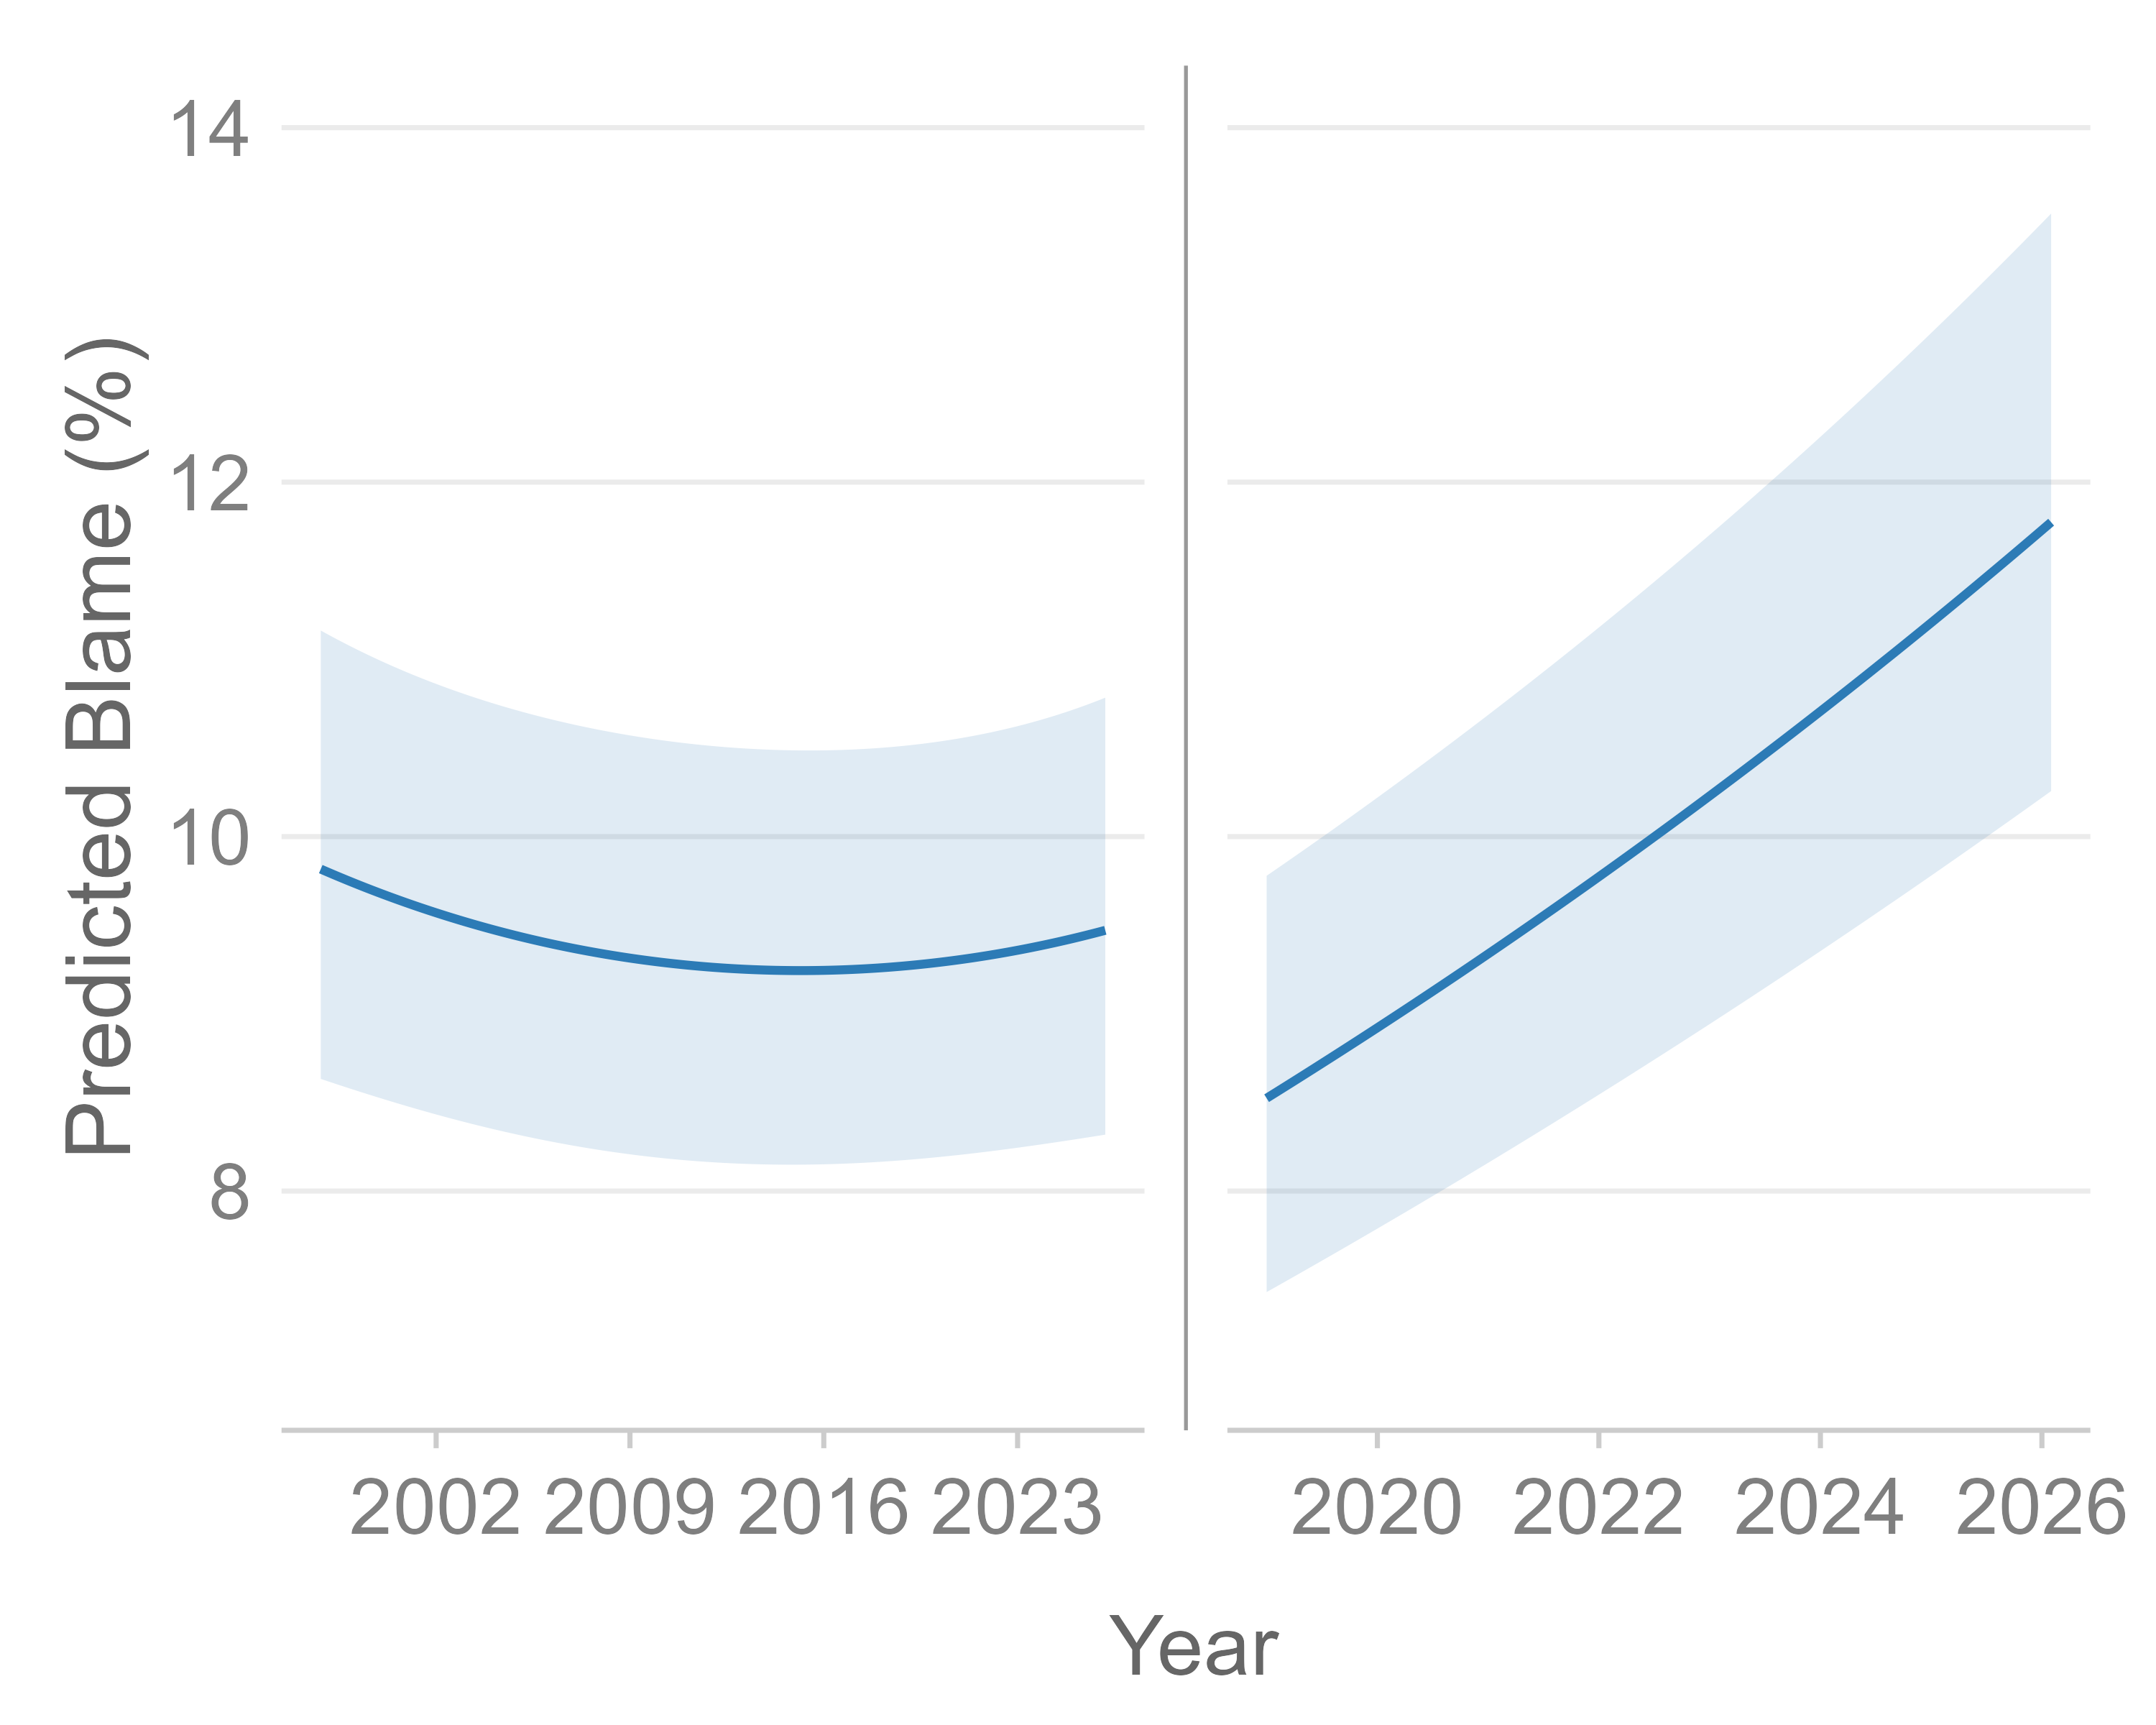
政治话语被普遍认为日益敌对,但稳健证据依然稀缺。本研究考察 1997 至 2026 年 Danish Parliament(丹麦议会)中的责任归因,将自建分类器 BlameBERT(F1:0.80)与多层级统计建模相结合;该分类器通过标注高效流程构建,适用于低至中等资源语言。 结果显示,责任归因呈 香蕉形轨迹:一路下降至 2016 年前后,随后在近年(2019–2026)显著且持续上升。执政地位始终影响责任归因——我们称之为 政治对比(political contrasting)——反对党 的指责显著多于执政党。该效应受意识形态调节:执政的抑制效应在右翼政党中较弱,意识形态极端性在右翼更强地放大了指责。 近年来,政治阵营与意识形态极端性之间的 交互作用 增强,表明指责修辞的意识形态硬化集中在政治光谱右端。总体而言,这些模式显示,人们所感知的激烈政治语言上升并非单纯的普遍修辞漂移,而是政治话语中意识形态不对称的硬化。敏感性分析表明,上述结论在不同分类阈值下保持稳健。
论文精读
TL;DR 用 BlameBERT(F1 0.80)对丹麦议会 1997–2026 语料做 blame 归因,发现责备近年在右翼政党中显著上升且意识形态硬化,证明政治话语敌对化并非普遍漂移而是不对称极化。
问题
问题背景
政治话语的敌意程度普遍被认为在上升,但缺乏稳健的量化证据。NLP 领域的情感分析、立场检测和攻击性语言识别已有较多工作,但针对指责归因(blame attribution)这一特定语用行为的自动检测仍不成熟。
现有方法局限
- 粗粒度情感极性:主流情感分析模型只输出积极/消极或细粒度情绪(愤怒、悲伤等),无法区分“指责”与一般负面情绪。例如“政府未能有效应对危机”是责备,但词典情感打分可能仅标记为负面。
- 标注资源稀缺:监督学习需要大量精确标注,但 blame 标注成本高,且现存数据集多为英语,低中资源语言(如丹麦语)几乎空白。直接迁移英语模型到丹麦语议会文本,领域和语言双重偏移导致性能大幅下降。
- 统计建模忽略政治结构:以往对政治文本敌意的分析常只报告总体时间趋势,未控制执政/在野身份、意识形态位置等协变量,无法分离政治对比效应(在野党比执政党更爱指责)与意识形态极端性效应。
为什么这个问题难/重要
- 技术挑战:blame attribution 需要模型理解句法语义角色(谁责备谁)、话语上下文中的归因关系,以及跨时间的数据分布漂移(三十年语言与议题演变)。低资源语言还面临预训练模型和标注工具不足。
- 实际价值:新闻平台、社交媒体内容审核、政治风险分析都需要自动区分“抱怨”与“指责”以更精准地识别攻击性言论、衡量舆论极化程度。错误分类会误导对政治健康度的判断。
行业类比
类似客服系统中需要区分用户“投诉”(complaint)与“指责”(blame)以触发不同响应流程,但现有情感分类器无法稳定捕捉这种语用差异,导致升级机制误判。
核心洞察
- 面向低资源语言的 annotation-efficient pipeline 构建了 BlameBERT(F1: 0.80),仅用较少的标注成本即可在丹麦语议会数据上实现可靠的 blame attribution 分类。相比依赖大规模人工标注或高资源预训练模型的常见做法,该 pipeline 展示了低资源场景下快速构建任务专用分类器的工程路径,适合迁移至其他小众语言或特定领域语料。
- 将 BlameBERT 的分类输出作为因变量输入多层次统计模型,检测出 blame 话语的‘香蕉形’轨迹与意识形态不对称硬化。区别于仅报告分类器性能或单独做文本趋势分析,这一 mixed-methods 设计使文本分类信号服务于纵向因果推断与群体比较,为计算社会科学中的政治话语研究提供了可复制的分析模板。
方法
输入
- 语料:丹麦议会 1997-2026 年全体辩论发言文本,结合发言者所属政党、执政/反对党状态、政治左右翼定位(ideological wing)、意识形态极端程度(ideological extremity)及时间戳元数据。
关键模块
- BlameBERT 分类器构建
采用标注高效 pipeline,面向低中资源语言。基于 transformer 架构的预训练语言模型(如多语言 BERT 或丹麦语 BERT)微调,通过小规模人工标注种子集结合主动学习或自训练迭代扩充数据,输出每条发言片段的 blame 概率。 - 多层级统计建模
将 blame 概率作为因变量,构建多层级回归模型(随机截距/斜率按政党或发言者分组)。固定效应包括时间趋势(二次项捕捉香蕉形轨迹)、执政状态、政治翼、意识形态极端度及高阶交互项(如 government × wing、extremity × wing × time)。
输出
- 时间序列:blame 水平先降后升,2016 年后显著持续上升。
- 效应估计:政治对照效应(反对党 blame 显著高于执政党);意识形态调节(右翼执政 blame 减弱效应更小,极端度效应右翼更强);近期交互作用增强,指向右翼话语硬化。
跟同类方法的差异点:将 NLP 分类器与多层级统计推断深度结合,并针对低资源议会语料设计标注高效训练流程,而非仅报告模型指标。
实验
实验设计
研究构建了 BlameBERT 分类器(F1: 0.80),用于对 1997–2026 年丹麦议会辩论记录进行 blame attribution(归咎)分类。分类器采用 annotation-efficient 管道,适合中低资源语言场景。随后使用多水平统计模型分析 blame 的时间趋势、政府/反对党差异及意识形态调节效应。
关键发现
- blame 轨迹呈“香蕉形”:2016 年前持续下降,2019–2026 年显著回升。
- 政治对比(political contrasting) 效应显著:反对党 blame 显著多于执政党。
- 意识形态调节显著:右翼政党的执政 blame 抑制作用更弱,且意识形态极端性在右翼更强地放大 blame。
- 近年来,政治翼 × 意识形态极端性 交互增强,blame 修辞集中在右翼,呈现意识形态硬化趋势。
深度解读与局限
论文未报告与通用情感模型或既有 blame 分类器的直接对比,但 BlameBERT 在特定领域与低资源语言上的 F1 0.80 具有工程参考价值。其 annotation-efficient 构建流程降低了标注成本,相比大规模预训练模型微调更适合资源受限场景。多水平模型控制了政党/时间等嵌套效应,结论比简单聚合分析更稳健。敏感性分析(阈值变化)进一步支持结论可靠性。
上述内容基于 arXiv 摘要,正文方法细节未披露,具体训练算力与数据规模待补充。
行业影响
落地场景
BlameBERT 可嵌入内容审核、品牌舆情监测、客服分析等实际业务。例如:
- 社交媒体平台自动检测帖子与评论中的 blame 言辞,辅助社区治理与违规内容拦截。
- 电商平台识别买家评价中对卖家或平台的不当归因,触发自动安抚或人工介入流程。
- 金融客服对话中分析客户对产品/服务的 blame 语句,提升投诉升级效率与坐席路由准确性。
商业价值
- 降本:分类器 F1=0.80,可大幅减少人工审核量;模型轻量,部署资源占用低。
- 增收:向企业提供舆情监测 API 或品牌安全审计服务,形成差异化产品能力,面向广告主提供更安全的投放环境。
- 体验提升:实时干预高 blame 对话,改善社区互动质量;帮助品牌及时响应负面归因,降低公关风险。
与现有产品/工作流接口
BlameBERT 基于 Hugging Face Transformers 发布,可导出 ONNX/TensorRT 部署为微服务。集成方式:
- 在现有 NLP pipeline 中插入 blame 分类器作为预处理或后处理步骤,输出置信度分数。
- 结合论文中的多层统计模型展示时间趋势与意识形态偏置,可作为 BI 仪表板的后端分析组件。
- 支持低资源语言,适合多语言内容平台快速扩展。
具体 use case:某 SaaS 舆情监测产品集成 BlameBERT 后,自动标注客户反馈中的 blame 语句,并在 dashboard 显示 blame 指数趋势,帮助品牌团队量化负面归因变化并调整应对策略。
局限
- **数据与语境局限**:研究仅基于丹麦议会文本,丹麦政治生态(多党制、福利国家共识、左右翼光谱的特定分布)与其他议会制国家存在显著差异,结论的外部效度受限。尤其是“右翼硬化”的发现可能受丹麦特有政治议题(如移民、欧盟)极化影响,不一定反映全球趋势。作者未讨论跨国家、跨语言的可迁移性,后续工作应验证该结论在更多政治体系中的稳健性。
- **分类器性能与标注效率**:BlameBERT 的 F1 为 0.80,虽达到可用水平,但错误分类可能在统计建模中引入噪声,尤其对细微修辞(如讽刺、间接责备)的区分有限。annotation-efficient pipeline 依赖少量标注数据和主动学习,可能偏向标注者的既有认知框架,且未在非议会文本(如社交媒体、新闻报道)上验证泛化能力。工程上若将模型迁移到新领域,需重新评估标注策略和阈值。
- **方法设计局限**:统计分析采用多水平模型处理嵌套结构,但可能未充分控制时间序列自相关、议程周期波动或演讲者个体差异,从而影响对趋势的推断。此外,blame 仅被处理为二分类(有/无),忽略了 blame 的强度、目标(个人/政党/制度)等更细粒度维度,与一些使用多分类或连续情感评分的研究相比,信息损失较大,可能掩盖不同类型 blame 的异质性动态。