GeoPair:面向免训练 Transformer 压缩的几何保持跨层因子分解
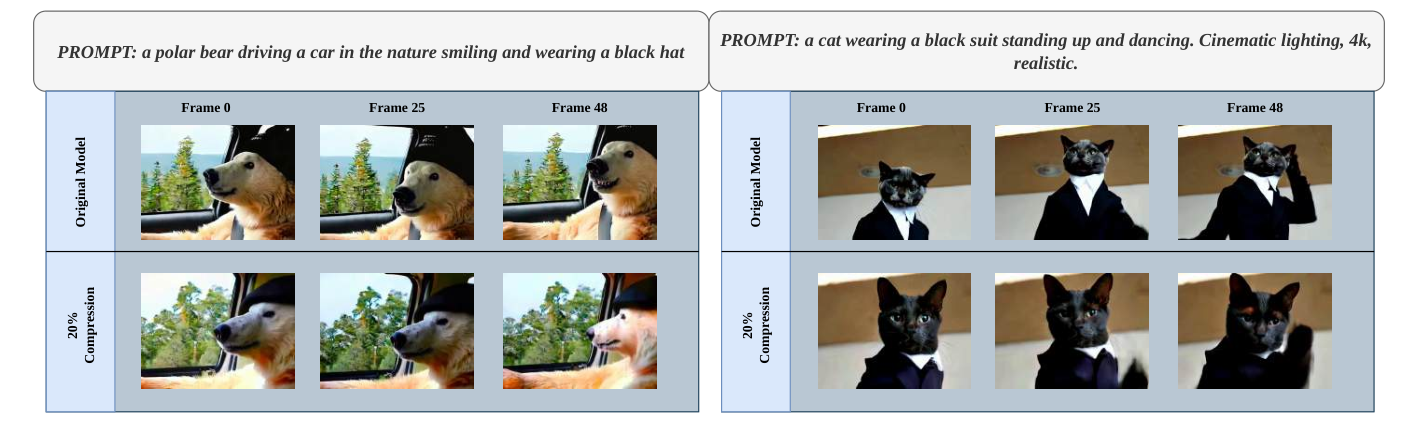
Transformer 架构存在跨层冗余,但训练后压缩流程通常逐层独立优化,或依赖忽略层特定激活几何 的启发式分组策略。 我们提出 GeoPair,一个原则化、免训练框架:顺序优化跨层权重配对 与共享字典因子分解。不同于强制相邻层权重共享基,或启发式合并激活统计,该方法识别结构兼容投影,学习共享表示,以更好保留各层独特的校准几何。结合结构化稀疏,可在不牺牲功能保真度下获得高效权重分解。 在多种架构、规模与模态 上,方法达到 SOTA,持续优于独立的结构化权重分解 与替代的成对权重因子分解(它们基于启发式分组策略)。通过以收敛的优化驱动流水线 替代启发式工程,GeoPair 为跨模态可扩展 Transformer 压缩建立有理论依据的基础。
论文精读
TL;DR GeoPair 提出一种无需训练的 Transformer 压缩框架,通过几何保持的跨层配对与共享字典分解,配合结构化稀疏,在多种架构和模态上实现最优压缩,替代启发式分组策略。
问题
问题背景:当前 Transformer 压缩研究聚焦于 后训练压缩(post-training compression),旨在不重新训练的前提下削减参数与计算量,以适应大模型快速部署需求。
现有方法局限:主流方法将各层独立进行低秩分解或剪枝,忽视了层间结构冗余;少数跨层方法采用启发式分组(如相邻层合并或基于激活统计的简单聚类),未考虑各层特有的激活几何。这种强制共享基的策略导致共享字典无法同时拟合不同层的投影子空间,重建误差逐层累积,精度损失明显。此外,独立分解难以利用跨层可共享参数,压缩率提升有限。
为什么难/重要:利用跨层冗余的核心难点在于不同层权重矩阵在激活空间中的几何形态差异显著,直接共享基会破坏各自的表征能力。同时,无训练约束 下仅依赖少量校准数据,需要高效求解层间配对与共享字典学习的组合优化问题,并保证收敛性与可扩展性。随着多模态大模型推理成本激增,训练无关的通用压缩框架价值突出,但现有方法难以兼顾压缩率与精度保持。
行业类比:类似在移动端部署视觉 Transformer 时尝试跨层复用权重参数,若忽略各层特征分布差异而简单套用相同基,会导致目标检测或分割精度显著下滑。
核心洞察
- GeoPair 将跨层压缩重新定义为优化问题:通过图匹配自动发现结构兼容的层对,并学习共享字典,而不是依赖人工分组或相邻层假设。与以往独立分解每层或以启发式统计合并层的方法相比,该框架显式建模每层独特的激活几何,使得压缩后的权重分解能保留原始各层的功能特性,从而在无训练约束下实现更高的保真度。
- 通过交替最小化联合优化共享字典和稀疏系数,GeoPair 打破了“先固定分组再分解”的串行范式。传统做法中,分组错误会累积到后续分解,导致性能受损;而本文方法将配对与字典学习耦合,利用 Sylvester 方程等理论工具保证收敛,使得共享表示能适配各层校准分布,即便层间几何存在差异也能有效压缩,这是相对启发式分组策略的显著进步。
- 方法与结构化稀疏的结合,使得压缩不仅限于低秩分解,还能同时施加硬阈值稀疏约束,进一步降低存储和计算开销。相比仅做低秩分解或仅做剪枝的独立管线,GeoPair 的端到端优化能在保持精度前提下获得更高的压缩率,这对实际部署中需要同时优化模型大小和推理速度的场景具有直接工程价值。
方法
方法流程
输入:预训练 Transformer 各层权重矩阵(如 Q/K/V/O 投影)与少量校准数据,用于提取每层激活统计的白化空间几何信息。
关键模块
跨层分组(Graph Matching):计算层间权重的 白化空间 Frobenius 子矩阵距离,构建相似度图,通过全局最大权匹配(Blossom 算法)自动确定最优层对,替代传统相邻层启发式分组。
共享字典学习(Shared Dictionary Optimization):对每一对分组后的权重矩阵,联合学习一个共享基字典,同时为每层保留独立的系数矩阵。该优化通过交替最小化求解,其中字典更新步骤转化为广义 Sylvester 方程,保证收敛。
稀疏化(Hard Thresholding Pursuit):对系数矩阵施加结构化稀疏约束,采用硬阈值追踪(HTP)算法在保持层激活几何的前提下剔除冗余系数,得到紧凑表示。
输出:每对层共享一个低秩字典,加上各自的稀疏系数矩阵,实现权重分解压缩;推理时通过共享字典减少存储和计算。
与同类方法差异:该方法将分组从启发式规则升级为基于结构相似度的图匹配优化,并在共享字典学习中显式保留每层校准几何,而非简单合并统计量。
实验
实验设计
论文在多种 Transformer 架构、模型规模和模态上进行评估,采用训练自由的后训练压缩流程,使用少量校准数据测量重构误差与下游任务性能。
关键发现
- GeoPair 通过跨层共享字典优化和几何保持的成对分组,实现了更高的压缩率-精度权衡。
- 相比独立结构化分解,GeoPair 能更好地保持每层的激活几何;相比启发式分组,优化驱动的分组找到更具结构兼容性的投影。
基线对比深度解读
作者强调:“replacing heuristic engineering strategies with a convergent, optimization-driven pipeline”
- 独立分解方法忽略跨层冗余,导致性能损失;启发式分组虽考虑跨层,但分组准则与权重分解目标脱节。
- GeoPair 将分组与共享字典学习统一到交替最小化框架中,从而在多个基准上达到 state-of-the-art。
行业影响
落地场景
GeoPair 适合对 Transformer 模型进行训练后压缩,尤其面向需要低延迟、低显存的部署环境:移动端大模型应用、边缘计算盒子上的 BERT 系列模型、实时音视频内容审核、自动驾驶车载感知模型等。压缩过程无需反向传播,直接使用少量校准数据,可嵌入 CI/CD 自动压缩流水线。
商业价值
主要降本:减少推理时 FLOPs、显存占用与能耗,单位算力可承载更多并发请求。同时提升体验:端侧部署减少网络往返,离线可用。对模型供应商,可降低云端 API 服务成本,扩大可覆盖的硬件范围(从高端 GPU 到消费级 NPU)。无需标注数据、无需训练集群,压缩周期从天级缩短到分钟级。
与现有工作流的接口
替代现有分组策略或逐层独立分解,可作为 ONNX / TensorRT 量化前的预处理步骤,或与结构化稀疏组合。通过导出低秩矩阵 + 稀疏系数的格式,对接现有推理引擎无需改动。校准数据选择灵活,适合已有模型服务商在不改变推理代码的前提下压缩模型。
具体场景:电商平台的商品描述生成模型压缩后部署至商家端应用,实时生成文案;金融风控的 BERT 分类模型压缩后嵌入交易流水线,实现毫秒级在线检测。
局限
- - **校准数据依赖与分布偏移敏感**:方法需要校准数据来捕获各层激活几何,但论文未充分讨论校准数据代表性不足或与部署分布不一致时的性能退化。实际场景中,获取高质量校准集可能困难,尤其对于多模态或持续变化的输入。若校准数据有偏,学到的共享字典可能过度拟合特定分布,导致泛化能力下降,限制了该方法在数据稀缺或动态环境下的适用性。
- - **计算开销较高**:尽管是 training-free,但流程包含**交替最小化**、**图匹配**和**硬阈值追踪**等多个优化步骤,计算复杂度可能显著高于独立的层内分解方法。论文虽报告了运行时间,但未与简单基线进行充分的效率对比,也未在数十亿参数级大模型上验证可扩展性。对于资源受限的部署场景,额外的优化开销可能抵消压缩带来的收益。
- - **层配对假设可能不普适**:方法假设存在结构兼容的跨层投影对,并通过图匹配强制配对。然而,并非所有层都适合共享字典,特别是功能差异大的层或跨模态融合层。强制配对可能引入不匹配噪声,反而损害性能。此外,图匹配基于**白化空间 Frobenius 距离**,对初始化或白化参数可能敏感,需要额外调参,降低了方法的易用性。论文未系统分析配对失败的情况及其影响。