GameHorizon Suite:游戏玩法中的多时间跨度数据与评估
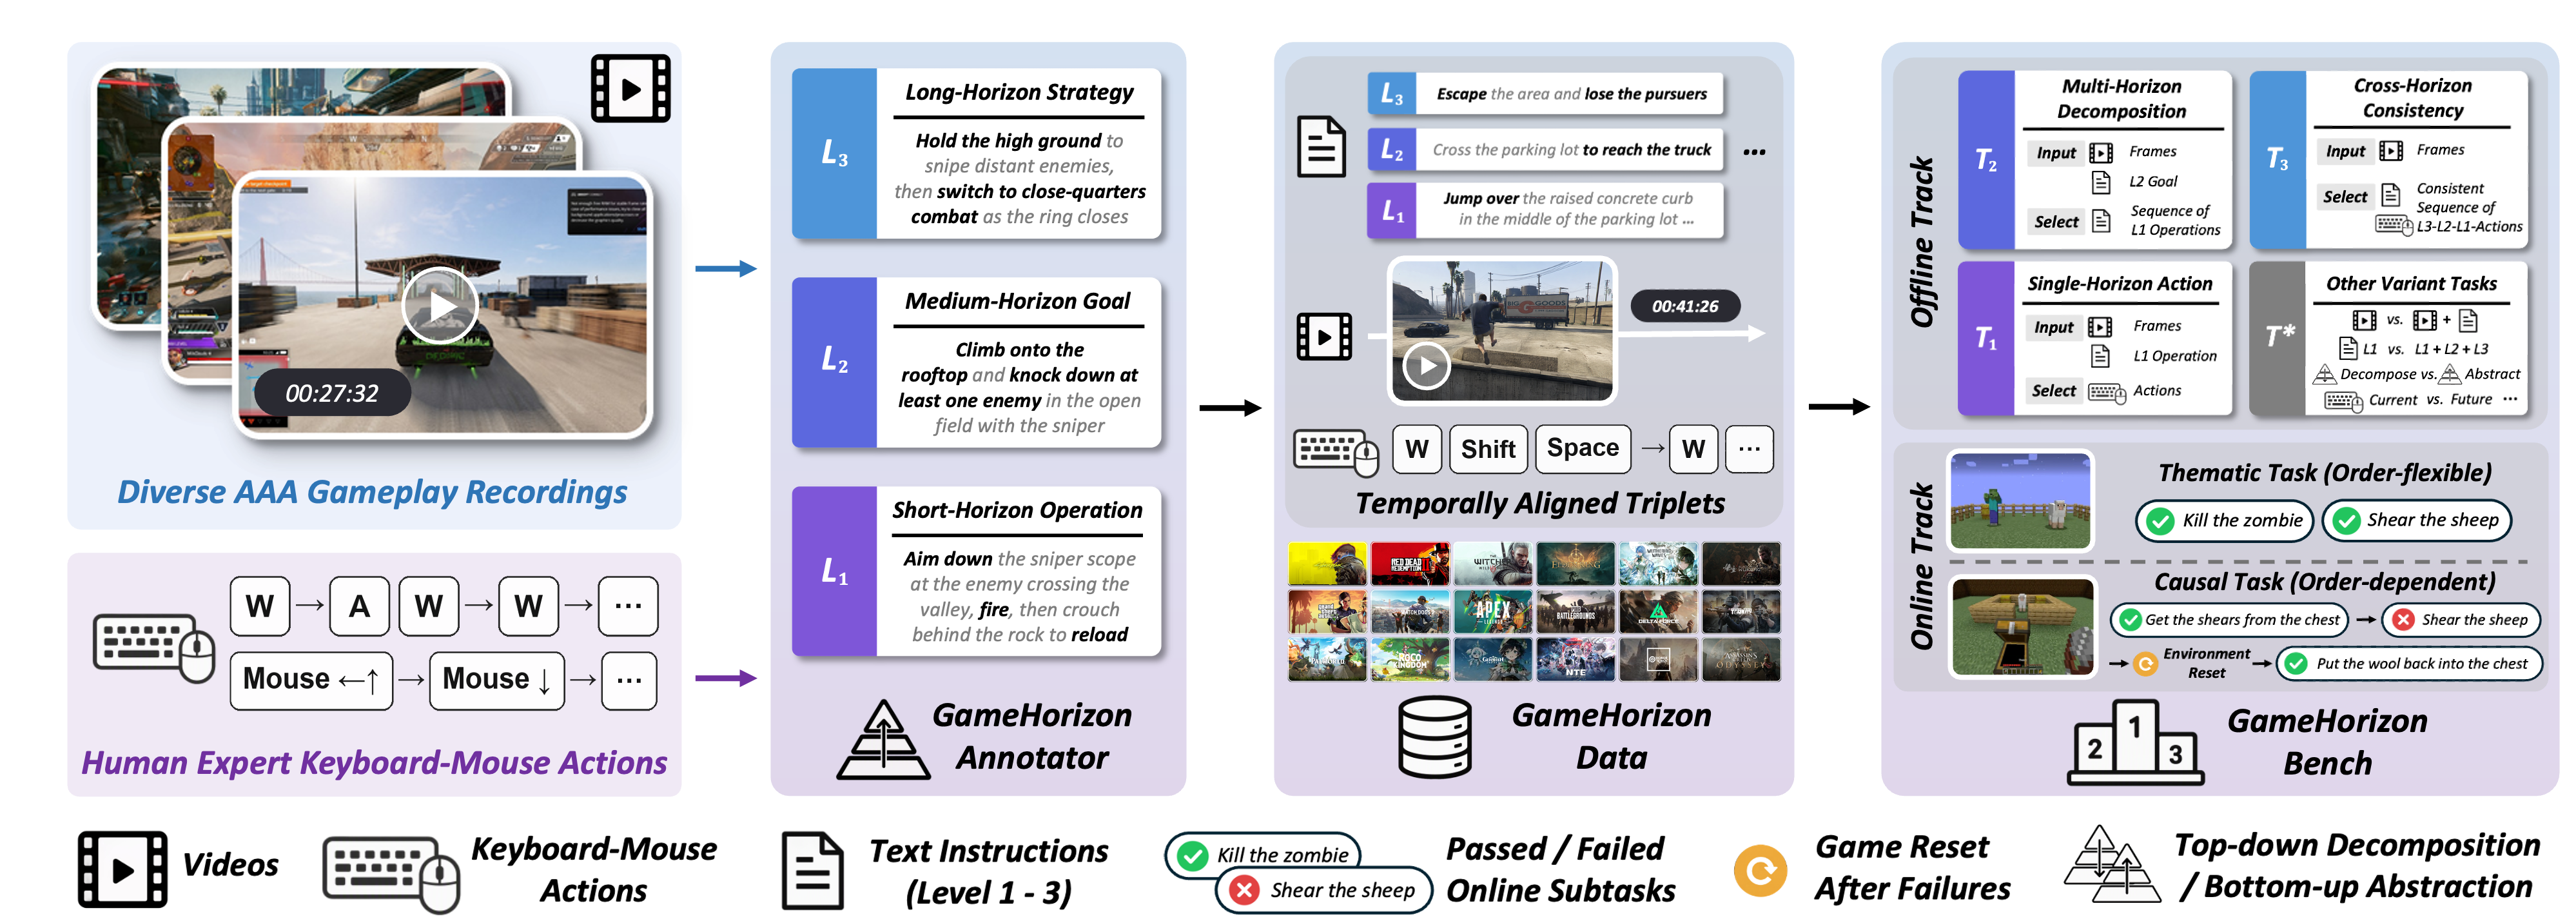
现代电子游戏为 AI 模型提供了可度量的试验台,综合了视觉理解、指令分解、目标规划与跨时间跨度的精确动作控制。但现有数据集与基准或游戏覆盖面窄,或缺少语言指令,或依赖高方差的在线 rollout。为此我们提出 GameHorizon —— 一个统一的数据与评估套件。 GameHorizon Suite 包含三部分: 1. GameHorizon-Annotator:可扩展的自动化多时间跨度指令标注流程; 2. GameHorizon-Data:首个大规模 AAA 游戏数据集,含 21 款游戏、100 位人类专家玩家采集的 5,000 小时录像,视频、玩家动作与多时间跨度指令在时间上对齐; 3. GameHorizon-Bench:离线赛道用数千道标准化问题(三个主任务及一系列诊断变体)实现可复现评估,在线赛道检验离线分数能否反映真实游戏能力,并定位长时程游戏中的失败步骤。 基于 GameHorizon Suite,我们通过逾一百万次模型调用评估了 47 个模型,揭示出任务难度的清晰层级与模型能力的显著差异。该工作可为跨时间跨度、跨模型族的游戏能力评估提供标准化标尺,并将开源数据集、标注器与基准。
论文精读
TL;DR GameHorizon Suite 构建首个含 5000 小时 21 款 AAA 游戏录制、多时间尺度指令的数据集,并提供离线与逐步在线双轨评测,统一衡量模型从视觉理解到长程动作控制的真实游戏能力。
问题
问题背景
当前 AI 研究将视频游戏视为多模态智能体的重要测试场,需要模型同时具备视觉理解、指令分解、目标规划和精确动作控制能力。
现有方法局限
- 已有数据集和基准(如 Atari、Minecraft 相关评测)通常只覆盖 少数游戏类型,缺乏 自然语言指令 与视频/动作的时序对齐,难以训练和评测指令跟随能力。
- 在线评测依赖随机 rollout,结果方差高、难以复现,且无法定位长程任务中具体失败步骤。
为什么这个问题难且重要
现代 AAA 游戏呈现高维视觉输入、复杂动作空间和跨 多时间尺度 的挑战,单一任务或指标无法反映模型真实能力。业界需要一个可复现的离线评测 + 在线诊断框架,既能标准化测试,又能追踪失败原因,从而指导模型迭代。
行业类比
类似机器人操作领域用 CALVIN / RLBench 提供离线语言条件任务评测,游戏 AI 也需要这类统一“标尺”来客观比较不同模型家族。
核心洞察
- **多尺度指令自动标注是评估模型分层规划能力的基础。** 现有视频游戏数据集要么缺失语言指令,要么仅覆盖单一时间粒度,难以同时考察短时动作控制与长期目标分解。GameHorizon-Annotator 利用动作感知视频分段,自动对齐视频、按键和指令,产出**时间对齐的多尺度指令**,覆盖从秒级操作到分钟级任务的多个 horizon。这为指令分解、目标规划与动作控制的联合评测提供了可复现的数据支撑,区别于以往依赖人工标注或高方差在线 rollouts 的范式。
- **离线与在线结合的双轨评测设计解决了在线评测高方差、结果难复现的问题。** GameHorizon-Bench 的离线赛道通过数千个标准化问题提供可重复的分数,覆盖三类主任务和诊断变体;在线赛道则逐步测试真实游戏能力,将长程失败定位到具体步骤,并验证离线分数与在线表现的相关性。这种设计既保留评测的可控性,又连接真实 gameplay,揭示了任务难度层级和模型能力差异,为后续基准研究提供了更可靠的参考。
方法
输入与总体流程
GameHorizon Suite 以原始游戏记录(视频 + 玩家动作 + 多时间尺度指令)为输入,构建统一的数据与评估体系。核心分为三个模块:
- GameHorizon-Annotator 自动标注管线:通过动作感知视频分割和游戏特定键位映射,将长时游戏过程切分为与玩家动作对齐的片段,并自动生成多层级自然语言指令(短时操作、中时目标、长时规划)。
- GameHorizon-Data 数据集构建:利用上述管线处理 21 款 AAA 游戏、100 位专家玩家的 5000 小时录像,产出首个时间对齐的视频-动作-多层级指令大规模数据集。
- GameHorizon-Bench 评估基准:包含离线轨道(数千道标准化问题,按三种主任务和多个诊断变体组织)和逐步在线轨道(可复现的逐步环境交互,用于定位长时任务中的失败步骤)。
输出与评估
输出为可复现的能力测试结果:离线赛道衡量视觉理解、指令分解、目标规划与动作控制的多层级表现;在线赛道检验离线分数与实际游戏能力的一致性,并提供步骤级失败归因。整体方法不依赖高方差在线 rollout,而是通过标准化问题与逐步环境提高可靠性。
与同类工作的差异:相比仅覆盖少数游戏、缺乏语言指令或依赖高方差在线评估的既有基准,GameHorizon 首次在大规模 AAA 游戏数据上实现了多层级指令对齐和可复现的离线/在线联合评测。
实验
实验设计
GameHorizon Suite 的实验围绕离线评测和在线评测两条轨道展开。离线轨道基于 GameHorizon-Bench 的数千道标准化题目,覆盖三个主任务(视觉理解、指令分解、目标规划)与一系列诊断变体,以保证结果可复现。在线轨道则采用 stepwise 方式,在长时间跨度游戏中逐步定位模型失败的具体步骤,检验离线分数是否真实反映实际游玩能力。
关键发现
作者对 47 个模型进行了超过一百万次调用,发现不同任务之间存在清晰的难度层级:较短时间尺度的感知任务相对简单,而需要长期记忆与精确动作控制的长时间跨度任务显著更难。模型间的能力差异非常明显,某些多模态大模型在视觉理解上表现优异,但在需要高频动作决策的环节则大幅落后于专用 Agents。
与基线的对比解读
与以往基准相比,GameHorizon 避免了仅依赖高方差在线 rollout 的缺陷,同时比单一游戏数据集覆盖更广的游戏类型与更丰富的语言指令。其多时间尺度设计揭示了模型能力的不均衡性,例如某些模型在单步决策上接近人类,但在长程任务中因累积误差导致成功率骤降。这表明仅凭短程评测会高估模型的真实可玩性,而 GameHorizon 的 stepwise 在线跟踪能够定位失败环节,为后续改进提供明确方向。
行业影响
落地场景
GameHorizon Suite 可服务于游戏开发、多模态模型训练与自动化测试场景。游戏公司可用其构建游戏内智能助手、自动化 NPC 行为测试,以及内容生成 QA;AI 研究团队则可利用多时间尺度指令数据训练视频-语言-动作联合模型,用于机器人规划、自动驾驶仿真等非游戏领域。
商业价值
该套件通过标准化离线评测显著降低模型迭代中的测试成本,避免高方差在线 rollouts 带来的资源浪费;同时大规模人工标注数据(5000 小时、21 款游戏)可作为高质量监督信号,减少内部采集与清洗开销。对于游戏厂商,将评测结果接入研发流水线可缩短 agent 调试周期,提升 NPC 智能水平,改善玩家体验。
与现有产品/工作流的接口
GameHorizon-Bench 提供离线与 stepwise 在线两支评测通道,适合嵌入现有 CI/CD 或模型训练框架。数据集与标注器可直接对接多模态训练栈,或作为强化学习环境生成额外交互样本。例如:
- 在电商虚拟导购机器人场景,利用多时间尺度指令构造分层任务,以离线 benchmark 快速筛选模型,再通过在线 stepwise 定位决策失败环节。
- 在企业级流程自动化中,将游戏操作指令转化为业务流程操作序列,用统一评测框架对比不同 vision-language-action 模型,辅助选型和调优。
该工作为跨领域多模态 agent 提供了可复现的评测标尺,重点在于将离线分数与实际操控能力对齐,降低从游戏迁移到真实应用的验证成本。
局限
- **数据生态局限**:GameHorizon-Data 覆盖 21 款 AAA 游戏,但动作空间基于键盘/鼠标键位,对手柄、触屏或 VR 等输入设备泛化不足;游戏类型以动作、射击、驾驶为主,缺少策略、模拟经营等需要长程规划的品类。人类专家演示可能引入“高手偏差”,即模型学到的是精英策略而非自然玩家行为。
- **自动标注可靠性**:GameHorizon-Annotator 依赖 VLM 生成多 horizon 指令,虽提升了扩展性,但缺乏人工逐条校验。VLM 的幻觉或指令粒度不一致可能污染训练数据,且指令模板固定,难以覆盖开放式目标或隐含约束。论文未报告标注质量的人工评估,因此指令的真实效用仍有不确定性。
- **评测效度与成本**:离线评测虽可复现,但以选择题和诊断变体为主,与真实游戏中的连续决策存在差距;在线 stepwise 测试虽然定位失败步骤,但仅覆盖有限游戏场景,且每次评估需渲染游戏并部署模型,计算开销大。此外,模型评测以文本指令为输入,未充分利用多模态信息,可能低估视觉理解能力强的模型。