Tactile-JEPA:面向分布式触觉传感器的拓扑感知自监督表示学习
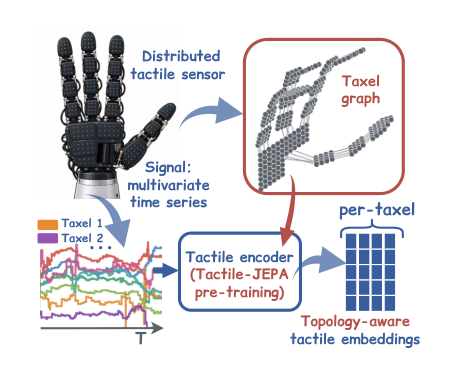
触觉感知是机器人完成接触密集型灵巧操作的关键模态,尤其在视觉被遮挡时不可或缺。尽管预训练图像编码器已成为机器人学习流程中的标配,触觉编码器通常仍要从原始、含噪的信号从零训练,这可能限制其表达能力。现有自监督学习(Self-Supervised Learning, SSL) 方法主要面向视觉型触觉传感器,对分布式电子皮肤鲜有涉及。而这类传感器的感知元件在覆盖表面上呈稀疏且不规则的排布,使得直接复用视觉 SSL 方法效果欠佳。 为此,我们提出 Tactile-JEPA,一种高效的自监督预训练方法,利用触觉传感器的空间排布来学习拓扑感知表示。具体而言,模型被训练为从未被掩码的其余感知元件预测被掩码元件的 embedding,并借助传感器连通图引导空间掩码。我们的分析表明,有效的触觉表示需要同时捕获局部接触细节与触觉表面的全局状态,为此我们采用双尺度掩码来实现。 我们在三个覆盖磁性传感器与压阻式传感器、不同机器人形态以及单/双传感器配置的数据集上进行了验证:Tactile-JEPA 相比此前最优方法将力估计误差降低 6.3%,将手内朝向误差降低 20.8%,并在策略学习等其他下游应用中取得一致提升。 总体而言,结果表明触觉感知带来的收益在很大程度上取决于编码器预训练的质量,而 Tactile-JEPA 正是直接针对这一问题。代码已开源于 https://github.com/E-Kovtun/tactile。
论文精读
TL;DR Tactile-JEPA 利用分布式触觉传感器的连通图进行掩码自监督预训练,让模型学习拓扑感知表示,在力估计和手内姿态估计上分别比前 SOTA 降低误差 6.3% 和 20.8%。
问题
问题背景
机器人接触丰富的灵巧操作中,触觉传感是视觉遮挡下的关键模态,但触觉编码器通常从原始噪声信号从头训练,缺乏高质量预训练表征。
现有方法局限
- 现有自监督学习(SSL)方法主要针对视觉触觉传感器(如 GelSight),将触觉信号视为 2D 图像,可复用图像 SSL(如 MAE、对比学习)。
- 分布式电子皮肤的传感单元稀疏且不规则分布,信号是离散点集而非规则像素,直接套用卷积或 ViT 会忽略传感器间的拓扑关系,导致表征学习次优。
- 许多方法未充分利用传感器连接图(connectivity graph)提供的几何先验,掩码策略随机或基于网格,不能适配任意排布。
为什么这个问题难且重要
- 技术挑战:有效触觉表征需要同时捕获局部接触细节(如单点压力峰值)和全局表面状态(如整体形变趋势),单一尺度掩码难以兼顾;传感器拓扑多样(磁性、压阻、不同机器人形态),要求预训练方法具备拓扑无关的泛化性。
- 业界关注度:触觉预训练质量直接决定下游力估计、姿态估计、策略学习等任务的性能。论文在三个数据集上验证,相比 SOTA 力估计误差降低 6.3%、手中姿态误差降低 20.8%,表明预训练方法对触觉模态的增益显著。
行业类比
类似点云自监督学习中利用点云几何结构进行掩码重建,Tactile-JEPA 将分布式触觉传感器视为图节点,用图拓扑指导掩码,可类比为触觉域的图掩码自编码器。
核心洞察
- Tactile-JEPA 利用传感器拓扑图作为空间掩蔽先验,使自监督学习适应非规则排布的分布式触觉皮肤。现有 SSL 方法大多将触觉数据视为图像或序列,假设规则网格或时序结构,而电子皮肤传感元件稀疏且不规则,直接复用会导致表征退化。Tactile-JEPA 通过图卷积和基于图的掩蔽策略显式编码传感器空间关系,学习对接触位置和形变更敏感的表征,相比视觉触觉 SSL 无需高分辨率图像,计算开销更低且能跨传感器类型泛化。
- 双尺度掩蔽强制模型同时关注局部接触细节和全局触摸表面状态,这是触觉表征质量的关键。单尺度掩蔽(随机或块掩蔽)通常只捕捉局部特征或忽略整体形变上下文,而真实接触任务既需要精细接触力分布,也需要整体形貌信息。Tactile-JEPA 混合不同粒度掩蔽使编码器在预训练阶段平衡两种信息,从而在下游力估计和手内方向估计中分别降低 6.3% 和 20.8% 误差,对多指手操作尤其重要,因为局部接触变化与整体物体姿态强耦合。
方法
输入与预处理
Tactile-JEPA 的输入是分布式触觉传感器的原始读数序列,每个传感元素(taxel)提供一维或多维信号(如压力、磁场变化)。与视觉触觉传感器(如 GelSight)的栅格图像不同,分布式皮肤上的传感元素稀疏且不规则排布,因此方法先将传感器拓扑建模为连通图:节点对应传感元素,边表示空间邻接关系(根据实际布局定义)。
关键模块
- 拓扑感知掩码:基于连通图进行空间掩码,而非随机或栅格掩码。训练时随机选择部分节点(传感元素)及其邻域进行掩蔽,构建被掩蔽集合
M与可见集合V。 - 双尺度掩码策略:为同时捕获局部接触细节和全局表面状态,方法交替使用两种掩码尺度:
- 局部尺度:掩蔽小尺寸邻域,迫使编码器从邻近可见节点推断局部形变;
- 全局尺度:掩蔽较大连通区域,促使编码器利用远端节点信息推理整体接触分布。
- 编码器-预测器架构:
- 编码器
f_θ处理所有未掩蔽节点特征,输出每个节点的上下文表示; - 预测器
g_φ接收掩蔽节点的位置编码(或图结构信息)与可见节点的上下文,预测被掩蔽节点的嵌入。 - 采用 JEPA 风格的目标:预测的不是原始信号,而是编码器输出的嵌入向量,损失基于预测嵌入与真实嵌入(来自完整输入的目标编码器)的余弦相似度,避免低层噪声干扰。
- 编码器
输出与下游应用
预训练后,编码器为每个传感元素输出拓扑感知的表示向量,可被冻结或微调用于下游任务,如力估计、物体姿态回归、策略学习等。
与同类方法的差异
相比视觉触觉 SSL 方法(如 MAE 直接重建图像像素)或仅依赖局部几何先验的分布式触觉学习,Tactile-JEPA 通过图结构显式利用传感器不规则拓扑,并以双尺度掩码显式平衡局部与全局特征学习,而非将分布式信号强制转换为规则网格处理。
实验
实验设计
Tactile-JEPA 在三个数据集上进行评估,覆盖 磁性与压阻式传感器、不同机器人本体以及单/双传感器配置。下游任务包括 力估计、手中物体姿态估计 和 策略学习。基线包含从零训练的触觉编码器、通用视觉 SSL 方法(如 MAE、VICReg)以及针对视觉触觉传感器的 SSL 方法。
关键发现
- 力估计误差相较先前 SOTA 降低 6.3%,手中姿态误差降低 20.8%。
- 双尺度掩码设计同时捕获局部接触细节与全局表面状态,对分布式电子皮肤尤为重要。
- 策略学习任务也获得一致增益,说明表征质量直接提升下游控制性能。
与基线对比解读
视觉 SSL 方法假设输入为规则像素网格,直接用于分布式触觉传感会忽略 传感元件稀疏且不规则排列 的拓扑特性。Tactile-JEPA 通过传感器连接图引导空间掩码,预测被掩码传感元的嵌入,从而学到拓扑感知表征。这一差异在力/姿态回归任务上体现为稳定且显著的误差下降,验证了为触觉模态定制预训练的必要性。
行业影响
落地场景
Tactile-JEPA 针对分布式触觉传感器(电子皮肤、阵列式压阻 / 磁传感器)提供无标注预训练,适合需要精细力反馈的机器人操作。典型产品:仓储物流自动分拣(抓取形状不一、易碎商品)、医疗手术机器人(组织触诊与刚度估计)、假肢与康复设备(触觉感知反馈)。其价值在传感器稀疏、非规则排列的电子皮肤上尤为突出,可减少对视觉遮蔽的依赖。
商业价值
核心收益来自降低触觉数据标注成本 与提升下游任务精度。论文显示力估计误差降低 6.3%,手内姿态误差降低 20.8%,可提高机器人抓取成功率与操作可靠性,减少商品损坏与生产停机。预训练编码器可跨不同传感器构型、机器人本体复用,避免每款硬件重复收集标注数据,加速产品迭代,兼具降本与体验提升。
- 降本:无需大规模触觉标注,预训练一次可迁移多硬件。
- 增收 / 体验:更高抓取成功率、更低损坏率,提升自动化产线良率与终端用户体验。
与现有产品 / 工作流的接口
Tactile-JEPA 可作为即插即用的触觉特征编码器,接入现有机器人学习栈。它以传感器连接图定义掩码,输入原始触觉读数,输出拓扑感知 embedding,可直接替换当前从零训练的触觉编码器。集成路径:
- 将分布式触觉传感器数据封装为图结构,使用官方 GitHub 代码 加载预训练权重。
- 在模仿学习或强化学习策略中,把该编码器作为视觉编码器旁边的新模态分支,冻结或微调。
- 与 ROS / PyTorch 等标准工具链兼容,支持实时推理。
具体 use case:在电商仓储自动分拣中,机器人用电子皮肤感知抓取物体,Tactile-JEPA 提供的力估计与接触状态特征可提升对透明、反光或柔软物体的抓取成功率;在微创手术机器人中,触觉预训练模型可帮助估计组织刚度,避免损伤,提升手术安全性。
局限
- **传感器拓扑依赖**:Tactile-JEPA 使用传感器连接图指导空间掩码,要求预先知道传感器阵列的精确几何布局。对于可变形电子皮肤、动态装配或未知拓扑的传感器网络,该方法无法直接应用,实际中必须额外标定或构建图结构。此外,图构建方式(如 KNN 或固定距离阈值)影响掩码质量和表征效果,论文未系统分析不同图构建策略的敏感性。
- **评估规模和任务多样性有限**:虽然覆盖三个数据集和多个下游任务,但预训练数据规模相对较小,且主要集中于力估计和手内姿态估计。在更复杂的接触丰富操作(如插入、滑动检测、材质识别)或更大规模机器人操作数据集上的表现尚未验证。策略学习实验仅作为探索性验证,未与其他 SSL 方法充分对比,难以全面衡量预训练表征对策略学习的增益。
- **与通用视觉 SSL 方法的直接对比不足**:论文主要比较了针对分布式触觉的 SSL 方法,未充分纳入 MAE、DINO、BYOL 等通用视觉 SSL 方法在相同分布式触觉数据上的表现。分布式触觉数据可转换为稀疏图像或图结构,已有方法在该数据上的表现未充分报告,导致无法判断拓扑感知设计相比简单空间处理的实际增益大小,限制了结论的广泛适用性。