1% 的 token 就够了:论 on-policy distillation 中的梯度估计
稀疏 on-policy distillation(OPD)只把教师监督分配给 student 生成轨迹中的一小部分 token。然而,当梯度由采样得到的下一个 token 进行估计时,即便教师指导本身有用,也可能带来噪声更新。 本文在固定前缀下从信息几何角度研究该估计问题,提出基于信噪比分解的信息效率比(IER),用以刻画在最优标量基线下相对梯度估计误差的大小。主要贡献包括: - 用 候选集近似 实现基于 IER 的 token 选择,并可与现有 usefulness 分数结合; - 在实现上保留采样的 reverse-KL 训练目标; - 为稀疏监督的分配提供「有用性 + 梯度估计可靠性」的双重准则。 在数学与医学推理任务上,加入 IER 在多种设置下改进了现有选择器;在 0.1%–1% 的小 token 预算下,稀疏配置可媲美甚至超过不做 token 选择的完整 OPD。这些结果说明,分配稀疏监督时应同时考虑 usefulness 与梯度估计可靠性。代码见 https://github.com/BruceSheng1202/IER-OPD。
论文精读
TL;DR 论文提出信息效率比(IER),在稀疏在线策略蒸馏中同时考虑 token 有用性与梯度估计可靠性,使 0.1%–1% 极小 token 预算下性能匹配或超过全量 OPD。
问题
问题背景
On-policy distillation (OPD) 通过教师模型对学生自生成轨迹逐 token 提供监督,已成为对齐推理模型的重要途径。为降低计算开销,稀疏 OPD 只对少量 token 施加教师信号,但如何选择 token 仍待解。
现有方法局限
现有 token 选择器主要基于 usefulness 指标(如师生分布差异、熵或 reward),假设有用的 token 就能带来有效梯度。然而,OPD 中教师目标来自采样得到的 next token,其梯度是单样本随机估计,具有高方差。一个 token 即使 usefulness 很高,若该位置梯度噪声过大,更新方向可能被噪声主导,导致稀疏监督失效。此外,这些方法缺少对梯度估计误差的理论刻画,无法在信息量与估计可靠性之间做显式权衡。
难点与重要性
在信息几何中,token 级梯度可分解为信号项与噪声项,但最优 baseline 需估计,且要为每个候选 token 计算信息效率比 (IER),计算成本不能过高。大规模推理模型训练中,教师蒸馏成本高,稀疏监督若能可靠地只用 0.1%–1% token 达到全量 OPD 效果,将显著加速训练。该问题同时涉及估计理论与系统效率,具有实际意义。
行业类比
类似在 RLHF 中挑选高价值样本进行 PPO 更新时,必须同时控制 advantage estimator 的方差,否则高方差梯度会破坏策略学习。
核心洞察
- 稀疏 OPD 的核心瓶颈不仅是选择哪些 token 有用,更在于如何可靠地从采样的下一个 token 估计梯度。现有选择器(如基于 KL 散度、熵或教师概率)只衡量教师-学生分布差异(有用性),但忽略了单个采样样本带来的高方差噪声,导致高有用性 token 也可能产生有害更新。本文在信息几何框架下将梯度估计误差分解为信号与噪声,提出信息效率比 IER,把选择问题从「哪个 token 值得教」升级为「哪个 token 能被可靠地教」,这是对稀疏蒸馏优化目标的根本性补全。
- IER 通过引入最优标量基线并显式建模反 KL 训练目标下梯度估计的方差结构,给出了相对均方误差的闭式度量(IER⁻¹),使 token 选择从启发式走向理论驱动。与以往直接使用教师概率或分布差异作为重要性权重不同,IER 量化了从学生分布采样时梯度信号与噪声的比值,将估计可靠性纳入可计算的打分函数。这一框架不仅适用于蒸馏,也可推广到其他基于策略梯度的在线学习场景,为稀疏监督分配提供了新的通用工具。
- 在 0.1%–1% 的极小 token 预算下,结合 IER 的稀疏选择器能匹配甚至超越全量 OPD,说明稀疏监督的效用并不随预算线性衰减。这一发现挑战了「更多监督必然更好」的直觉:只要优先选择高信息效率的 token,极稀疏的教师反馈就足以维持甚至提升蒸馏质量。对实际部署而言,这意味着可以将教师前向计算压缩到几乎可以忽略的成本,大幅降低推理和通信开销,同时不牺牲模型性能,为资源受限环境中的在线蒸馏提供了一条高效路径。
方法
输入
给定一个学生模型在自生成轨迹上的 token 序列,以及教师模型对学生状态下的下一个 token 分布评分。稀疏 on-policy distillation(OPD)只对其中一小部分 token 施加教师监督,目标是最大化每个监督 token 的梯度信息量。
关键模块
- 信息几何下的梯度分解:在固定前缀处,将 token 级别的反向 KL 梯度估计分解为信号项和噪声项。信号来自教师分布与当前学生分布的差异,噪声源于只采样一个 next token 导致的蒙特卡洛方差。
- 信息效率比(IER):定义 IER 为最优标量基线下,全量梯度估计与稀疏梯度估计的相对均方误差之比。高 IER 意味着该 token 的梯度估计更可靠,监督更“划算”。
- 候选集近似:直接精确计算 IER 需要对整个词表求和,成本过高。作者采用候选集近似,仅对教师分布中 top-k 的 token 计算信号与噪声,从而得到每个 token 的 IER 估计。
- 与有用性分数结合:将 IER 作为乘子或加权项,与现有基于教师-学生概率差异等有用性分数融合,形成最终 token 选择器。被选中的 token 仍使用采样的反向 KL 目标进行训练,不改变训练目标本身。
输出
学生模型根据被选中的稀疏 token 子集更新参数,其余 token 不产生梯度。实验表明,在 0.1%–1% 的 token 预算下,IER 辅助的稀疏 OPD 能达到或超过全量 OPD 的效果。
与同类方法的差异
不同于仅基于教师-学生分布差异或不确定性度量的选择器,IER 直接从梯度估计的统计性质出发,显式建模单样本采样带来的噪声,因此能在极低预算下更有效地筛选出“高信噪比”的监督 token。
实验
实验设计
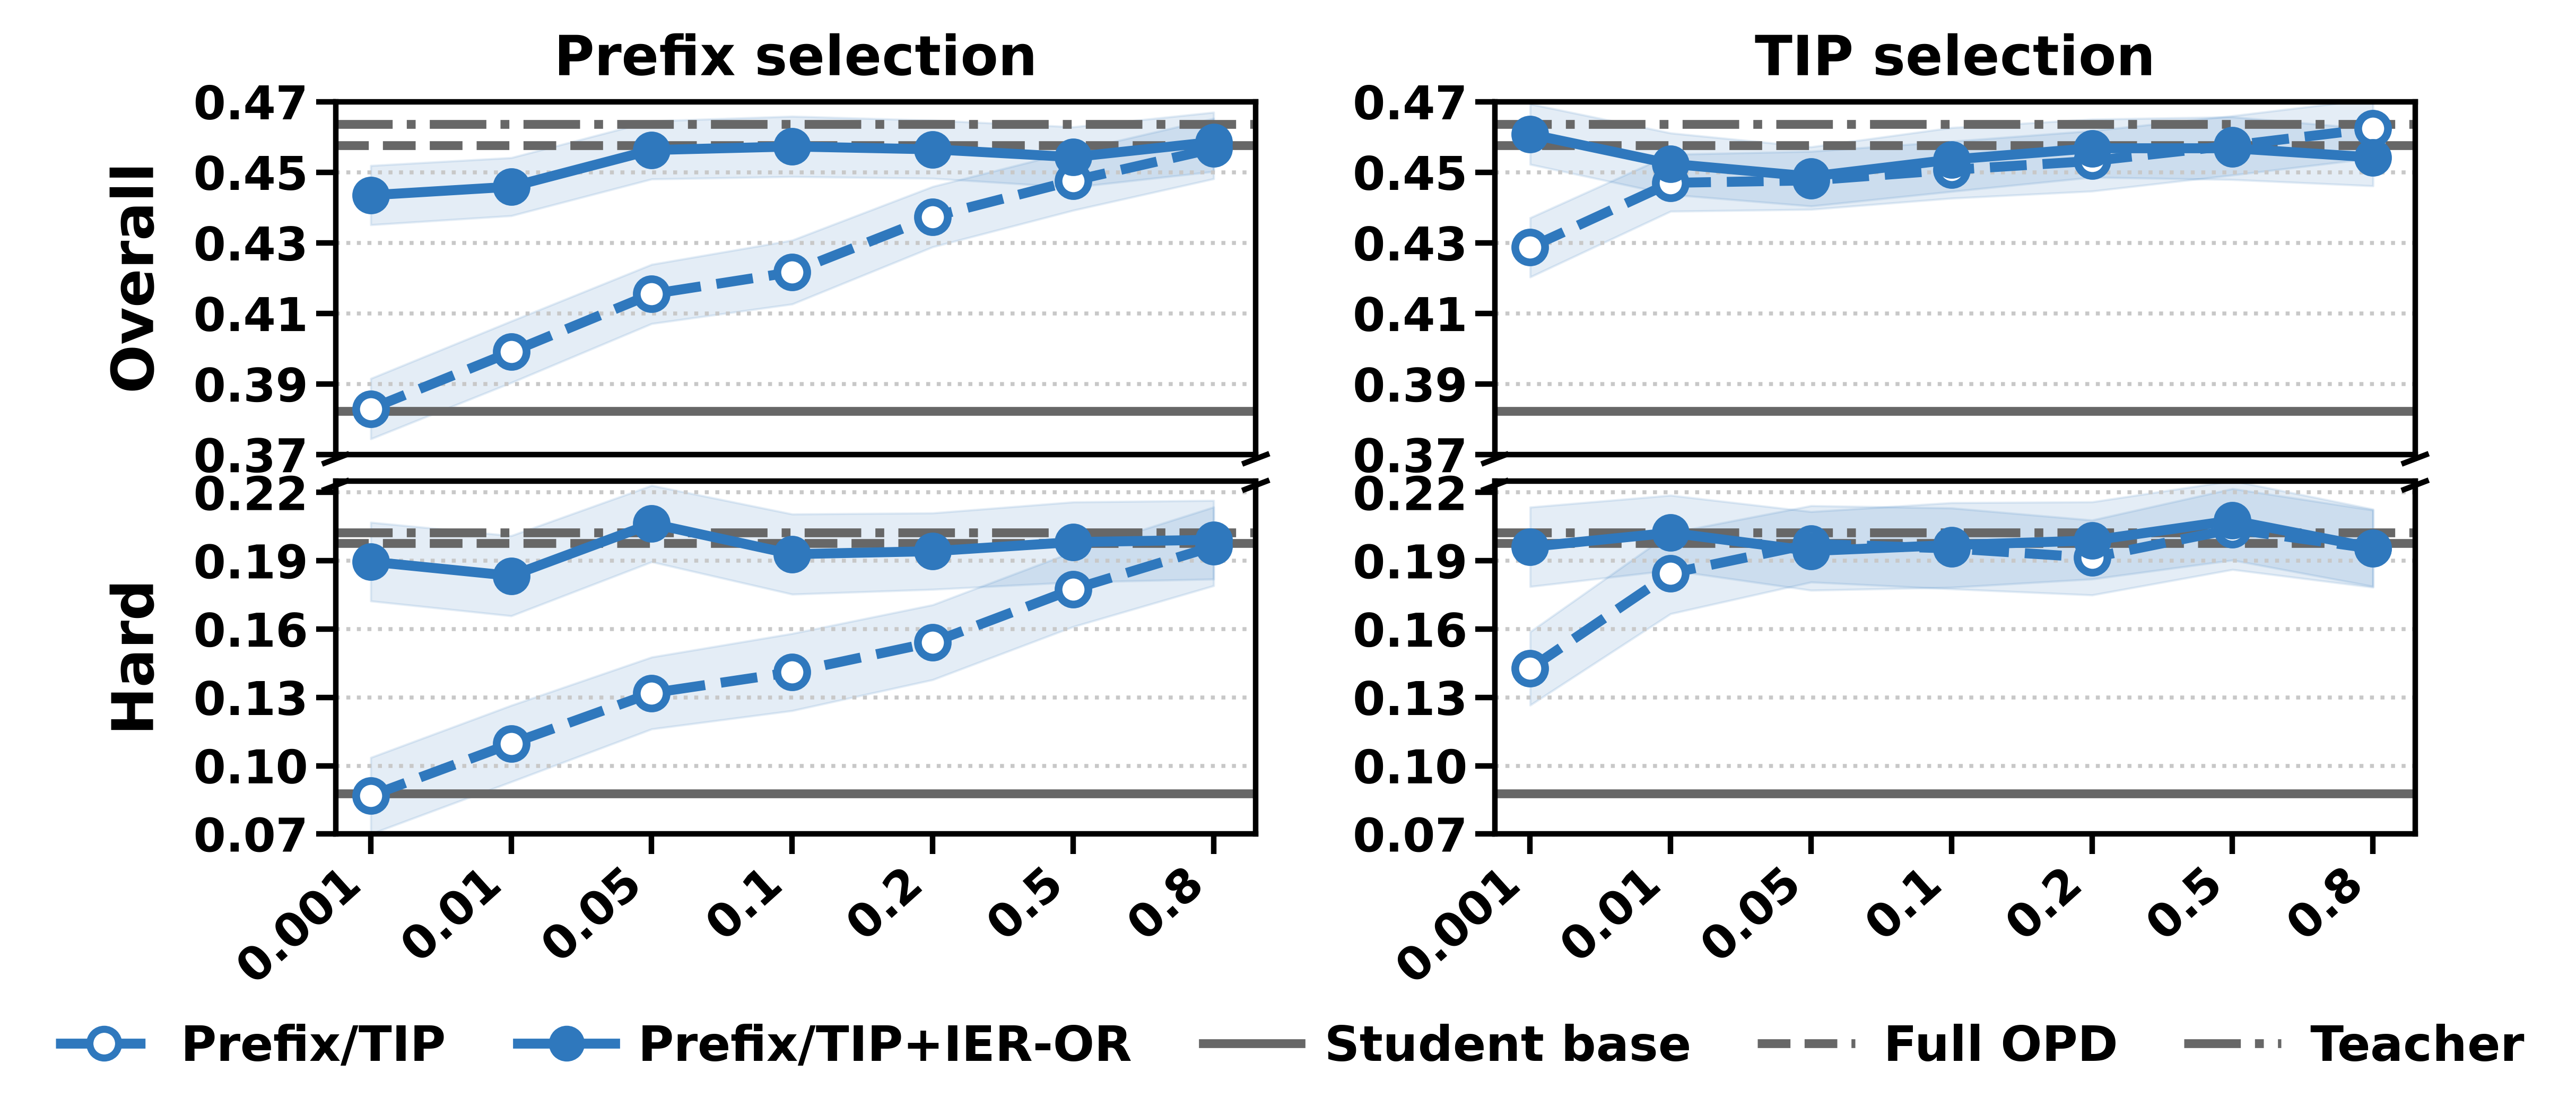
论文在数学推理与医学推理任务上验证 信息效率比 (IER) 对稀疏 on-policy distillation (OPD) 的影响。稀疏 OPD 仅对少部分 token 分配教师监督,现有方法通常依据 usefulness(如 token 重要性)选择,而 IER 从信号-噪声分解角度量化梯度估计的可靠性,并与 usefulness 分数结合。实验设置 token budget 为 0.1%–1%,对比了使用 IER 的 selector 与现有 selector、以及 full OPD(无 token 选择)的性能。
关键发现
- 在 0.1% 的极小 token budget 下,加入 IER 的 selector 能达到或超过 full OPD 的性能,证明极少 token 监督足够。
- 单纯增加 token budget 并不总能提升性能(Higher Token Budget Does Not Always Improve Performance),说明选择哪些 token 比选择多少 token 更重要。
- IER 在 thinking-on 与 thinking-off 两种模式下均有效,表明梯度估计可靠性是通用问题。
与基线对比解读
现有稀疏 OPD 选择器主要关注 token 的 usefulness,忽视梯度估计的方差。当从采样 next token 估计教师梯度时,高 usefulness 的 token 可能噪声很大,导致更新不稳定。IER 通过信息几何中的 信号-噪声分解 和最优标量 baseline 刻画相对估计误差,提供了一种可计算且可组合的筛选准则。实际工程启示:在资源受限的在线蒸馏场景中,应同时评估 token 的信息价值与梯度估计可靠性,选择“值得学且学得准”的 token,而不是盲目增加监督密度或只依赖价值分数。
行业影响
落地场景
- 大模型蒸馏:将大型教师模型的知识蒸馏到轻量学生模型,用于在线服务,如智能客服对话、内容生成、医疗问答等。
- 稀疏监督训练:通过 IER(信息效率比) 选择 0.1%–1% 的 token 进行教师监督,大幅降低教师推理成本,同时保持或提升学生性能。
商业价值
- 降本:教师模型仅对选中的极少数 token 进行前向传播,算力开销减少 99% 以上(以 0.1% 预算为例),总体训练成本显著下降。
- 提效:更快的迭代周期支持频繁更新模型,适应业务变化;轻量学生模型线上部署延迟更低,改善用户体验。
- 质量可控:在数学与医疗推理任务中,稀疏配置匹配或超过全量 OPD,证明可靠性。
与现有工作流集成
- 即插即用:IER 作为 token 选择器,可与现有 usefulness score 融合,无需改变
reverse-KL训练目标。 - 兼容主流框架:基于 PyTorch / Hugging Face 的 on-policy distillation 流水线只需替换选择策略,保留优化器和日志逻辑。
- 低额外开销:候选集近似将 IER 计算成本控制在可接受范围,适合大规模训练。
具体 use case
- 电商智能客服:训练轻量回复生成模型,教师为通用大模型,使用 IER 在 0.5% token 预算下蒸馏。教师算力需求降低 99%,学生模型回复质量持平,线上推理延迟降低,支持大促期间高并发。
- 医疗问答助手:在医疗对话数据上稀疏蒸馏小模型,IER 优先选择梯度信号可靠且对答案有帮助的 token,减少噪声更新,提升事实准确性,同时降低教师服务器负载,便于在隐私受限环境中部署。
局限
- **计算开销与候选集近似误差**:IER 的计算需要教师模型对候选 token 进行额外前向评分,尽管论文用候选集近似来降低开销,但在大模型或长序列场景下仍可能带来不可忽略的推理成本。此外,候选集构造的近似误差没有被严格量化,当候选集规模较小时,可能遗漏真正高信息效率的 token,从而影响选择质量与训练稳定性。
- **适用域与任务覆盖有限**:实验仅在数学和医学推理任务上验证,且模型规模相对较小(论文未给出具体参数量,但从描述看属于中等规模)。对于开放式对话、代码生成、多模态等更复杂领域,IER 的有效性尚未得到验证。同时,方法绑定 reverse-KL 蒸馏目标,不一定适用于前向 KL 或其他 teacher-student 对齐范式,限制了其通用性。
- **理论假设与实际训练存在差距**:IER 的推导基于固定前缀下的局部梯度估计、最优标量基线等理想假设,但实际训练中前缀随采样动态变化,全局训练轨迹下局部最优的 token 选择未必能保证收敛或性能提升。论文也观察到更高 token 预算不一定带来更好性能(5.4 节),暗示 IER 在低预算下优势明显,但其指导价值可能随预算增加而衰减,实际使用需要谨慎调参。