Document Retrieval-Aware Chunking (D-RAC):通过 PDF 归一化与多模态 Markdown 转换实现企业文档的通用检索感知摄取
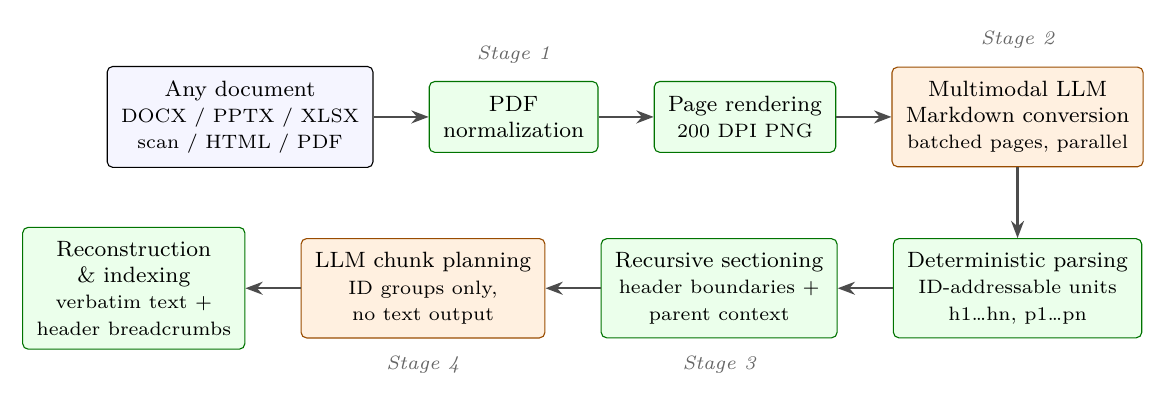
企业知识库上的 Retrieval-Augmented Generation (RAG) 系统必须摄取 PDF、Word、演示文稿、扫描件等异构格式,而其中的内容往往被困在复杂视觉版式、多栏页面与密集表格里。基于规则的抽取和 OCR 会破坏阅读顺序、压平表格、丢失标题层级;直接对抽取文本做全 agentic chunking 则带来高昂的 token 成本与幻觉风险。 D-RAC(Document Retrieval-Aware Chunking)是我们 W-RAC(Web Retrieval-Aware Chunking)框架向任意文档格式的扩展。它先将任意输入文档归一化为 PDF,利用几乎每种格式都存在忠实且确定性的 PDF 渲染这一事实;再由单次 multimodal LLM 处理,把渲染页面转换为面向检索优化的 Markdown,将表格改写为自包含的散文式陈述并保留标题层级。此后分块流程与 W-RAC 完全一致:先确定性解析为可 ID 寻址的单元,再让轻量 LLM 基于 identifier 而非文本进行 chunk planning,分块期间从不重新生成源文本。 实验在 RAG-Multi-Corpus 基准的 PDF 子集(236 篇文档、795 页,覆盖五个企业领域)上进行:D-RAC 以 72 分钟零错误完成全语料转换与分块,产出 1,748 个检索就绪的 chunk。相比使用前沿 LLM 的 agentic chunking,其分块阶段输出 token 减少 95.7%,分块成本降低 77.8%(按 GPT-4.1 定价)至 85.6%(按 Gemini 2.5 Pro 定价),耗时缩短 75%,并可线性扩展至 500 页以上的文档。
论文精读
TL;DR 任意格式文档先归一为 PDF,多模态 LLM 转成保留表格语义与标题层级的 Markdown,后续 chunk 规划仅基于标识符、不重写源文本;在 236 文档/795 页上零错误,省 95% 输出 token,成本降 77-86%,时间减 75%。
问题
问题背景
当前 RAG 系统需要从 PDF、Word、PPT、扫描件等异构企业文档中提取内容,检索质量高度依赖文本抽取的语义保真度。
现有方法局限
- 规则化文本提取 与 OCR 往往破坏视觉顺序、压平表格、丢失标题层级。
- Layout-analysis 流水线 难以处理多栏页面和密集表格,常导致阅读顺序错乱。
- 完全 agentic chunking 直接对提取文本规划,虽能恢复部分语义,但 token 消耗大、存在幻觉风险;且 chunk 过程重新生成文本,成本和可观测性差。
- 视觉引导 chunking 的方法通常依赖页面图像或复杂多阶段处理,难以在保持确定性的同时低成本扩展。
为什么难且重要
企业文档布局复杂,信息被锁在视觉结构中;要同时解决格式归一、结构保留与成本控制。D-RAC 提出先把任何格式归一化为 PDF,再用单次多模态 LLM 转成检索优化 Markdown,后续 chunk 复用 W-RAC 的确定性解析和 ID-based 规划,不重新生成文本。这挑战在于在保持检索性能的同时大幅降低 chunking 阶段 token 和成本,并线性扩展到数百页文档。
行业类比
类似编译器前端将多种高级语言统一为中间表示(IR),让后端优化一次投入、多次受益;D-RAC 将异构文档归一为 Markdown IR,使 chunk 策略可复用且成本可控。
核心洞察
- D-RAC 的核心是将昂贵的语义理解(一次性多模态 PDF 转 Markdown、表格转自包含散文)与廉价的检索单元规划(标识符上的 LLM 决策)解耦。与 agentic chunking 对每个候选块重新生成或重写文本不同,D-RAC 仅在转换阶段付出一次高成本,之后可针对不同检索需求反复调整 chunk 边界而不触碰源文本,因此 chunk 规划阶段输出 token 减少 95.7%,总成本下降 78% 至 86%,同时保持确定性可观测。
- D-RAC 在 chunk 规划时只让 LLM 处理 Markdown 元素的标识符序列(如 heading 层级与表格散文段的 ID),而非原始文本。这一设计避免了从零生成摘要或改写块带来的幻觉与语义漂移,同时继承 W-RAC 的确定性解析与可审计性。相比纯规则 extraction/OCR 丢失阅读顺序、表格结构的问题,D-RAC 通过多模态模型保留了版面语义,又用符号式规划压低了推理规模,实现任意可渲染文档格式的统一低成本高质量摄入。
方法
输入归一化:任意格式 → PDF
D-RAC 接收异构企业文档(DOCX, PPTX, XLSX, 扫描图像, 原生 PDF),利用几乎所有格式都有确定性 PDF 渲染这一特性,将每个输入统一转换为 PDF,再按页渲染为图像。此步骤不依赖 OCR,避免版面信息丢失。
多模态 Markdown 转换(核心)
对渲染页面执行 一次 多模态 LLM 推理,输出检索优化的 Markdown:
- 将表格重写为 行级自包含散文陈述,使单行即可独立回答查询;
- 保留标题层级(H1/H2/H3)作为后续分块的上下文线索;
- 维持阅读顺序,不展平多列布局。
转换后的 Markdown 成为后续所有分块操作的唯一真值源,源文本此后不再重新生成。
确定性解析与 ID 寻址
将 Markdown 解析为 ID 可寻址的原子单元(标题、段落、表格行等),建立层级索引。解析完全确定性,无 LLM 参与。
轻量 LLM 分块规划
调用轻量 LLM 在 标识符列表 (而非全文) 上进行分块规划,输出单元 ID 的分组方案。根据分组结果,从原始 Markdown 中直接抽取对应 ID 的文本片段拼接成块,文本内容零重写。这显著降低 token 开销、消除幻觉,并保证可观察性与可复现性。
输出:一组检索就绪块,每个块由单元 ID 引用组成,内容来自一次转换的 Markdown,保留表格散文与标题语义。
差异点:不同于在提取文本上完全代理式分块(需要反复读取全文并重写内容),D-RAC 将格式转换与分块规划解耦,分块阶段仅操作 ID 且不生成文本,实现了成本、确定性和可观察性的统一。
实验
实验设计
在 RAG-Multi-Corpus 基准的 236 文档 / 795 页 PDF 子集上评估,覆盖五个企业领域。流程:先将各类文档归一化为 PDF,再用单次多模态 LLM 转换为检索优化的 Markdown,然后执行确定性解析与轻量 LLM 分块规划。与 agentic chunking 基线对比,记录转换吞吐、分块规划效率、检索性能与成本。
关键发现
- 全语料转换+分块在 72 分钟 内完成,零错误,产出
1,748个检索就绪 chunk。 - 相较于使用 frontier LLM 的 agentic chunking,分块阶段输出 token 减少 95.7%。
- 成本降低 77.8%(按
GPT-4.1定价)至 85.6%(按Gemini 2.5 Pro定价),分块时间减少 75%。 - 方法线性扩展到 500+ 页文档。
与基线对比的深度解读
传统 rule-based / OCR 管线破坏阅读顺序、压平表格、丢失标题层级;agentic chunking 虽恢复部分语义一致性,但 token 成本高且存在幻觉风险。D-RAC 的 PDF 归一化 + 多模态 Markdown 转换,在源文本层面重建表格为自包含 prose 语句并保留层级,后续分块只在 identifier 上规划,不重新生成源文本,因此同时获得低成本、确定性和可观测性。对比 agentic chunking,D-RAC 将昂贵的前沿 LLM 推理限制在一次转换阶段,后续分块只是轻量规划,这是 token 和成本大幅下降的根本原因。
行业影响
落地场景
- 企业知识库 RAG:统一处理 PDF、Word、PPT、扫描件等多格式文档,支撑内部搜索、客服问答与合规审计。
- 金融与研究机构:财报、招股书等长文档中表格密集,D-RAC 将表格转为自包含 prose 语句,保留语义完整性。
- 电商与内容平台:商品手册、多语言说明书转为结构化 Markdown,提升商品属性查询准确率。
商业价值
- 显著降本:相对 agentic chunking,输出 token 减少 95.7%,成本降低 77.8%–85.6%(按 GPT-4.1 与 Gemini 2.5 Pro 定价),处理 236 文档/795 页仅需 72 分钟,适合大规模语料冷启动。
- 质量与可观测性:确定性解析 + ID 寻址使每个 chunk 可回溯,杜绝源文本重生成,降低幻觉风险,提升生产环境稳定性。
与现有产品/工作流集成
- 作为 ingestion 层替换组件:在 LangChain、LlamaIndex 等 RAG 框架中,用 D-RAC 替换基于规则或 OCR 的解析器,输出 Markdown 与 chunk manifest 直接对接 embedding 与向量库。
- 增量更新成本低:文档修改后仅需重渲染 PDF 并重新规划 chunk,无需全量重跑。
具体 use case
- 金融投研助手:将 500+ 页招股书、研报统一转为检索优化 Markdown,表格数据变成可检索的事实陈述,支持分析师快速定位财务指标与风险条款。
- 企业客服知识库:接入产品手册、培训 PPT,使客服机器人能准确回答包含参数表格的复杂问题,减少人工转接率。
局限
- 该方法高度依赖 **多模态 LLM** 的页面理解质量,复杂版面、低分辨率扫描件、数学公式或图表密集的文档可能产生转换错误;此外,将任意格式先转为 PDF 的归一化步骤可能丢失原始结构信息(如嵌入对象、可交互元素或公式语义),论文未提供错误类型的定量分析,「零错误」结论仅基于当前评测集,泛化性存疑。
- 评测仅使用了 **RAG-Multi-Corpus** 的 PDF 子集(236 文档、795 页),覆盖五个企业领域,规模有限,且未与专业文档解析工具(如 **Marker**、**Nougat**)或更多检索管道进行充分对比,检索性能部分的系统与协议细节披露不足,可能无法反映真实企业知识库的多样性。
- 该方法引入前置的 PDF 归一化与多模态转换,对于高频更新的文档会产生额外延迟与成本;表格改写为自包含 prose 虽然利于语义检索,但可能损害精确数值查询或结构化过滤场景;且核心 chunking 逻辑完全沿用 **W-RAC**,创新主要集中在输入格式扩展,方法论层面增加有限。