HappyWorld-Bench:评估世界模型可靠性的综合基准
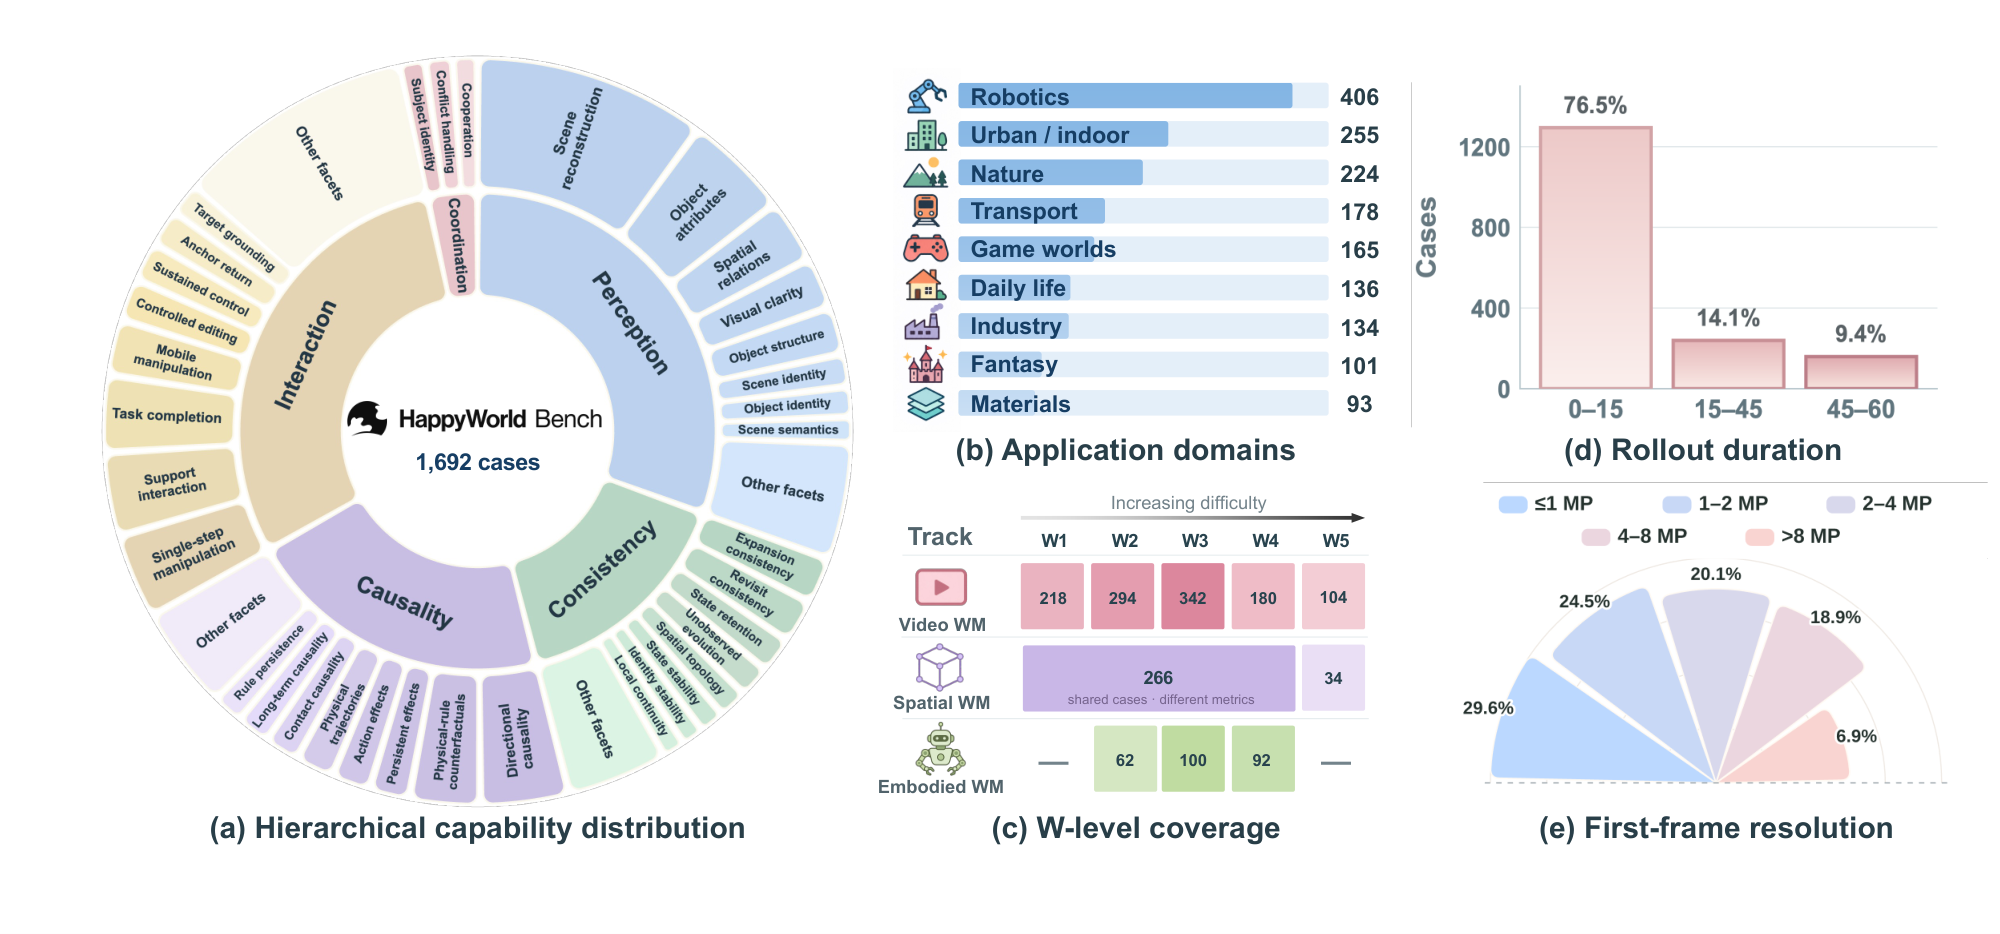
评估 world models 既要衡量其所生成世界的质量,也要考察其在探索、交互与修改下的一致性与响应性。为此,研究提出 HappyWorld-Bench,一个用于判断生成世界在 agent 交互时是否保持可靠的综合基准。 其设计基于六项世界能力(W1–W6) 的分层能力框架,从生成式构建延伸到统一世界建模,并落地为三条独立评测赛道:video world models、spatial world models 与 embodied world models。基准包含 1,138 条 video prompt、300 个 spatial scene 与 254 个 embodied 测试用例。 三条赛道均构建并运行 HappyWorld-Arena,组织人类 A/B 对比以得出模型级 Elo 评分,并与刻画行为正确性的新自动化指标互为补充。共评测 14 个 video world model、9 个 spatial 系统与 8 个 embodied 候选模型。 结果揭示三条赛道均存在可靠性缺口:video 模型在长时 rollout 与重访中一致性下降;spatial 模型最好仅达 70.14% 放置准确率与 73.33% 编辑执行率;embodied 模型难以在多步动作中保持状态,也无法精确响应被改变的动作条件与物理规则。这些发现表明,评估 world models 不能只看视觉质量,还须关注状态一致性及其对动作与干预响应的正确性。
论文精读
TL;DR HappyWorld-Bench 构建了覆盖视频、空间、具身三类世界模型的统一评测基准,通过人类竞技场与自动化指标量化模型在交互中的一致性与可控性,揭示现有模型在长时间 rollout、状态保持和规则修改上的可靠性缺口。
问题
问题背景
世界模型(world models)正从生成逼真视频 / 场景走向支持智能体交互、干预与长期 rollout。当前评估主流仍以视觉质量为主,例如 FVD、LPIPS 等。
现有方法局限
- 视频世界模型基准多关注单次生成质量,缺乏对 状态持久性、反事实响应、长期一致性 的系统度量。
- 空间世界模型评估常局限于单场景几何或图像指标,未覆盖 可导航性、物体级持久性、可控编辑 与 可扩展共享世界。
- 具身世界模型则缺少跨任务、多步动作下的 状态保持 与 规则编辑 统一测试。
- 三者彼此割裂,没有统一能力框架,且自动指标难以捕捉“行为正确性”,人工 A/B 成本高。
为什么难 / 重要
世界模型本质要求“可交互的物理一致性”,而非纯渲染。评估需同时验证:生成质量、状态留存、因果响应、可控干预,这跨越多种模态与能力层级。业界关注点已从“能生成”转向“能用、能改、能探索”,因为下游智能体训练与推理高度依赖世界模型的状态正确性。设计跨视频、空间、具身的统一基准面临数据收集、统一评价与人工评分校准三大挑战。
行业类比
类似自动驾驶仿真器:只渲染真实道路不够,必须验证车辆在罕见物理规则或传感器扰动下的精确响应。
核心洞察
- HappyWorld-Bench 的核心创新在于将世界模型评估从“生成质量”拓展到“交互一致性”与“干预响应正确性”。不同于以往仅关注视频生成视觉质量或静态场景几何的基准,该工作构建了覆盖视频/空间/具身三类世界模型的统一层次能力框架(W1-W6),并通过 HappyWorld-Arena 引入人类 A/B 比较与 Elo 评级,结合自动化行为指标,专门探测模型在动作执行、状态保持和规则修改下的可靠性。
- 基准揭示了当前世界模型普遍存在的“可靠性缺口”——视觉质量与状态一致性、因果干预能力脱节。实验显示视频模型在长时 rollout 和场景重访时一致性显著下降,空间模型最佳放置准确率仅 70.14%,编辑执行率 73.33%,具身模型难以在多步动作后保持状态,且对修改的动作条件/物理规则响应不精确。这一发现与仅报告生成 FID/PSNR 的同类基准形成鲜明对比,将评估重点转向模型在交互场景下的行为正确性,为后续研究提供了明确改进方向。
方法
评估框架设计
HappyWorld-Bench 采取能力导向的基准构建方式,而非直接比较模型输出质量。输入为待评估的世界模型(视频、空间、具身三类),以及按六维能力框架 W1-W6 设计的任务集:生成构造(W1)、交互模拟(W2)、状态持久化(W3)、可编程动力学(W4)、可扩展共享世界(W5)、统一世界建模(W6)。
- 数据构建:视频轨道使用 1,138 个提示,空间轨道 300 个场景,具身轨道 254 个用例。每个用例由能力标签驱动,经人工审核与质量控制。
- 评估模块:
- 自动指标:针对各能力设计行为正确性度量,如空间轨道的放置准确率(
place_recall)、编辑执行率(edit execution)、场景级与对象级持久化分数(place_hpsv3_f1、obj_sam_*),具身轨道的感知、一致性、因果性、可控性分数。 - HappyWorld-Arena:组织人类 A/B 对比,计算模型级 Elo 评级,与自动指标互补。
- 自动指标:针对各能力设计行为正确性度量,如空间轨道的放置准确率(
- 输出:每个模型在各能力维度上的分数与排名,以及跨轨道的可靠性差距报告。
与同类基准(如仅评估视频生成视觉质量或单步交互)相比,HappyWorld-Bench 强调多步交互中状态一致性与干预响应正确性,覆盖视频、空间、具身三类世界模型的统一评估。
实验
实验设计
构建 HappyWorld-Bench 基准,覆盖三大 track:视频世界模型(1138 prompts)、空间世界模型(300 scenes)、具身世界模型(254 test cases)。搭建 HappyWorld-Arena 进行人工 A/B 对比,得到模型级 Elo 评分;同时设计自动化指标衡量行为正确性,与人类偏好互补。评估范围包括 14 个视频模型、9 个空间系统、8 个具身候选。
关键发现
- 视频模型:扩展 rollout 与重复访问(revisits)下一致性明显下降。
- 空间模型:最佳 placement accuracy 为 70.14%,edit execution 为 73.33%,仍存在失效情况。
- 具身模型:多步动作下状态保持困难,对变化动作条件与物理规则的响应不精确。
这表明当前世界模型在生成质量之外的状态一致性与动作/干预响应正确性上仍有显著差距。
与基线对比解读
该基准不设单一基线,而是在每个 track 内统一评测多个系统。结果表明所有候选模型在可靠性维度均未达标,自动指标与人类 Elo 排序共同暴露了“看起来合理但交互不可靠”的问题。后续工作应优先优化状态持久性与因果干预响应,而非仅提升视觉逼真度。
行业影响
落地场景
HappyWorld-Bench 为多类世界模型提供了统一可靠性评估,直接支撑以下场景:
- 视频世界模型:用于内容平台的长视频生成、交互式叙事,以及自动驾驶的 rare-event 仿真。基准重点考察延长 rollout 与 revisit 时的一致性,可避免生成内容出现状态漂移。
- 空间世界模型:服务于电商 3D 商品展示、虚拟展厅、游戏关卡自动构建等,需要稳定的物体放置与编辑执行能力。
- 具身世界模型:用于机器人仿真训练、智能家居模拟等,强调多步动作下的状态持久化与规则变更后的响应正确性。
商业价值
该基准直接降低模型选型与迭代成本:
- 降本:通过自动化指标替代部分人工评估,减少招聘标注团队与构建内部评测集的投入。HappyWorld-Arena 的 Elo 评级可快速横向对比模型,避免盲目试错。
- 增收:可靠的生成式世界模型能加速虚拟内容生产,例如电商平台可快速生成海量可交互商品场景,提高用户停留与转化率。
- 体验提升:在游戏、教育等场景中,状态一致性(如 W3 状态持久化、W4 可编程动力学)直接影响沉浸感与可用性,避免因模型不可靠导致用户流失。
跟现有产品/工作流的接口
HappyWorld-Bench 可作为模型评估层嵌入 ML pipeline:
- CI/CD 集成:将
happyworld-bench的自动化指标作为回归测试的一部分,每次模型更新后自动运行,确保不引入一致性退化。 - A/B 测试平台对接:借鉴 HappyWorld-Arena 的人类对比流程,将其评分结果接入公司内部的实验平台,用于模型版本间的量化决策。
- 模型卡与合规:将基准得分(如空间模型 placement accuracy、具身模型规则编辑成功率)写入模型卡片,供下游团队评估部署风险。
具体落地 Use Case
- 电商虚拟试穿/试摆:某电商平台使用空间世界模型生成客厅场景,用户可自由摆放沙发、更换地板材质。集成 HappyWorld-Bench 后,可筛选出
place_recall与edit execution均达标的模型,避免商品穿模或编辑后场景错乱。 - 自动驾驶仿真数据增强:车厂利用视频世界模型生成极端天气或罕见交通事件,用于训练感知模型。通过基准的
consistency指标(如延长 rollout 分数)选择模型,确保生成视频中车辆轨迹与物理规则长期吻合,减少误训练。
局限
- **数据集规模与覆盖范围有限**:视频 track 仅 1,138 个 prompt,空间 track 300 个场景,具身 track 254 个测试用例,相对于真实世界中模型可能遇到的海量场景和任务,样本量偏小,可能无法充分暴露模型在长尾分布上的可靠性问题。此外,三个 track 的能力映射虽统一于 W1-W6 框架,但各 track 的任务设计和评估粒度存在差异,跨 track 的可比性仍有提升空间,例如空间模型的对象级持久性与具身模型的状态保持并非完全对齐。
- **自动化指标与人类判断的一致性未充分验证**:虽然引入了 **HappyWorld-Arena** 进行人类 A/B 比较并计算 **Elo 评分**,但文中并未报告自动化指标(如 `place_recall`、`hpsv3_f1` 等)与人类偏好之间的相关性系数。如果自动化指标不能很好地预测人类对“可靠性”的感知,那么这些指标作为代理可能产生误导。尤其对于**因果关系**和**反事实干预**这类高层能力,自动化评估的效度需要更严格的心理学或行为学验证。
- **评估模型集合的时效性与代表性不足**:评估的 14 个视频世界模型、9 个空间系统、8 个具身候选均来自特定时间点,且多数为专有系统,缺乏对开源社区最新进展的及时覆盖。基准发布后,新的世界模型(如基于扩散 Transformer 的更强生成器)可能迅速超过当前测试结果,导致论文结论的时效性有限。同时,评估流程依赖各模型特定的推理协议(如 `Genie 3 via Project Genie` 等),协议差异可能引入混杂变量,影响模型间比较的公平性。