Neural Spectral Capacity:仅凭网络规格即可测量与设计架构
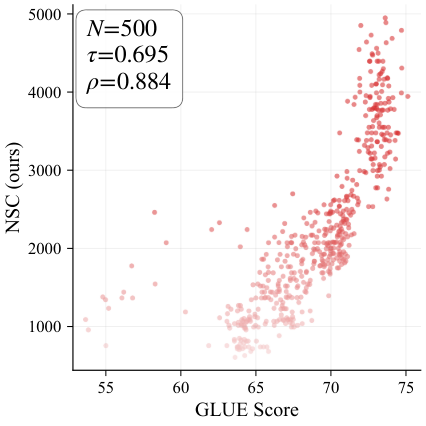
现代 Transformer 的设计与压缩,都可归结为在预算下分配容量。但常用标量 Params 与 FLOPs 只刻画规模与算力,不含架构结构:参数预算相同、但 depth-width、head 或 FFN 分配不同的两个架构得分相同,行为却不同。 为此我们提出 Neural Spectral Capacity (NSC),一个基于各权重矩阵奇异值谱的闭式标量。在标准随机初始化下,Marchenko-Pastur 定律使 NSC 仅凭架构规格即可算出,无需实例化模型、数据或梯度。其逐层可加结构导出 NSC-DP:一个精确动态规划求解器,能在 CPU 上数秒内给出资源约束下全局最大化 NSC 的架构,这是对现有免训练代理做黑箱搜索无法提供的保证。 实验上,NSC 在七类 Transformer 与 CNN 家族的排序中优于 Params、FLOPs 与代表性免训练代理(FlexiBERT 上,在 Params 相差不到 10% 的架构对中 τ=0.505,而 Params 仅 0.082);NSC-DP 在 WikiText-103 上 2 秒内发现超越人工设计基线的 Transformer-XL 架构;并在无任何校准数据下把 LLaMA-7B 剪枝为八个常识推理任务上最优的 5.7B 模型,比最强免训练代理基线快约 5900 倍。
论文精读
TL;DR 提出 Neural Spectral Capacity (NSC),一个仅凭架构规格即可闭式计算的谱容量标量,比参数/FLOPs 更准地衡量架构质量,支持秒级精确架构搜索与 LLaMA-7B 剪枝。
问题
问题背景
现代 Transformer 设计与压缩本质是在资源预算下分配容量:深度、宽度、注意力头数、FFN 维度等结构选择直接决定模型质量。训练免费代理(training-free proxies)被广泛用于快速评估架构,以避免昂贵训练。
现有方法局限
主流标量 #Params 与 #FLOPs 仅捕捉参数量与计算量,完全忽略架构结构差异。两个参数量相同但深度-宽度分配不同的网络会获得相同分数,而实际性能可能显著不同。现有训练免费代理(如 Synflow、GradNorm、Snip 等)要么需要实例化模型、使用数据或梯度,要么依赖黑盒搜索寻找优秀架构,无法保证全局最优且计算成本较高。更关键的是,它们缺乏从纯网络规格(specification)直接计算的可加性指标,使得在超大搜索空间中的精确优化不可行。
为什么这个问题难/重要
仅从架构规格预测训练后性能,要求一个闭式标量能捕捉权重矩阵的谱结构,并能在随机初始化下解析计算。Marchenko-Pastur 律提供了理论桥梁,但需将矩阵谱映射为容量度量,并保证层间可加性以支持动态规划全局优化。业界对高效架构搜索与大模型结构化剪枝有强烈需求:传统方法需数 GPU 小时,而全局最优解可望在 CPU 上秒级获得。
行业类比
这类似于芯片设计中使用静态时序分析(无需仿真)预测电路性能,或编译器优化中使用抽象解释得出程序性质——用理论保证的解析指标替代昂贵实验。
核心洞察
- NSC 是一个从随机矩阵理论推导出的训练无关标量,仅由架构规格即可计算,衡量权重矩阵奇异值谱的信息容量。它不同于 #Params 和 #FLOPs 等忽略结构的标量,在等参数预算下仍能区分不同深度、宽度、头数或 FFN 分配。实验显示在 FlexiBERT 上对参数差小于 10% 的架构对,NSC 的 Kendall τ 达到 0.505,而 #Params 仅为 0.082,证明谱容量捕捉到了参数计数完全丢失的结构性质量差异。
- NSC 的层可加性使其可以嵌入动态规划,精确求解资源约束下全局最大化 NSC 的架构,无需黑盒搜索或采样。这一特性带来两个工程优势:一是搜索结果有最优性保证,而现有训练无关代理通常只能启发式搜索;二是速度极快,NSC-DP 在 CPU 上 2 秒内发现 Transformer-XL 架构并超越人工设计,对 LLaMA-7B 剪枝到 5.7B 仅需 2 秒且无需校准数据,比最强训练无关代理快约 5900 倍,使大规模架构设计与压缩从分钟级缩短到秒级。
方法
方法概述
Neural Spectral Capacity(NSC) 将网络架构规范直接映射为标量容量分数,无需实例化模型或训练。
输入:架构配置,包括各层类型(注意力 / FFN / 卷积)、维度、深度、头数等。
关键模块:
- 谱容量计算:对每个权重矩阵,在标准随机初始化下,其奇异值谱服从 Marchenko-Pastur 定律,因此可推导出仅依赖矩阵形状(行数 / 列数)的封闭形式容量值。该容量衡量矩阵在随机初始化下可传递的信息量(基于互信息视角),与参数计数不同,能区分相同参数量但不同宽高比的矩阵。
- 层到网络聚合:每层容量由其中所有矩阵容量通过加性或瓶颈规则聚合;网络总容量为各层容量之和(服从可加性),因此总 NSC 可逐层计算并相加。
- NSC-DP 动态规划:利用逐层可加性,将架构搜索建模为资源约束下的最优化问题。通过动态规划在离散搜索空间内(如不同宽度 / 深度 / FFN 大小组合)精确求解全局最大 NSC 的架构,时间复杂度与层数和候选宽度呈多项式关系,CPU 上秒级完成。
输出:在给定参数 / 计算预算下全局 NSC 最优的架构规范,或剪枝后的子网结构。
与同类训练无关代理(如 SNIP、GraSP 等)不同,NSC-DP 提供全局最优保证,且计算开销极低,无需任何前向 / 反向传播或校准数据。
实验
实验设计
论文在三个场景验证 NSC:1) 架构排名:在 FlexiBERT 等七个 Transformer/CNN 家族上,比较 NSC 与 #Params、#FLOPs 及代表性训练免费代理的 Kendall τ 排名相关性;2) 架构搜索:用 NSC-DP 动态规划在 WikiText-103 上搜索最优 Transformer-XL 架构;3) 结构化剪枝:对 LLaMA-7B 应用 NSC-DP 在给定参数预算下剪枝,评估八个常识推理任务。所有 NSC 值仅由架构规范计算,无需训练数据或梯度。
关键发现
- 在 FlexiBERT 上,NSC 的 τ 达到 0.505,而 #Params 在参数差异小于 10% 的配对中只有 0.082,表明 NSC 能捕捉参数量无法反映的架构结构差异(深度/宽度/头数/FFN 分配)。
- NSC-DP 在 2 秒内搜索出优于人工设计的 Transformer-XL 架构,验证了其作为全局最优解的实用价值。
- 在 LLaMA-7B 剪枝中,NSC-DP 选出最佳 5.7B 子网络,在八个常识推理任务上表现最优,无需校准数据,且比最强训练免费代理快约 5900 倍。
基线对比
#Params 和 #FLOPs 只度量规模,无法区分相同预算下的结构差异,NSC 通过奇异值谱捕捉容量信息,因此在细粒度排名中显著优于它们。现有训练免费代理通常需要实例化模型或依赖梯度近似,搜索空间大时不可扩展;NSC-DP 利用可加性和闭式解,用动态规划在 CPU 上秒级得到全局最优,而黑盒搜索无法保证最优性。这使得 NSC 成为无需训练即可评估和设计架构的新工具,尤其适合大模型剪枝等资源敏感场景。
行业影响
落地场景
NSC 与 NSC-DP 可直接用于模型架构搜索 (NAS) 和大模型结构化剪枝。在电商推荐系统中,CTR/CVR 模型需要根据流量场景调整深度、宽度和注意力头数;借助 NSC 可在不训练的情况下,几秒内从架构规范计算容量分数并全局优化。内容平台对 LLM 部署前剪枝,NSC-DP 可按参数预算生成最优子架构,无需校准数据;论文中剪枝 LLaMA-7B 至 5.7B 仍保持常识推理性能。
商业价值
核心收益在于降本:训练前架构筛选省去大量无效训练,剪枝流程比最强训练无关代理快约 5900 倍,大幅节省 GPU 算力与时间。体验提升 体现在相同参数/FLOPs 预算下获得更优架构,直接改善线上模型效果(如推荐点击率、生成质量)。增收 潜力来自更轻量且高性能的模型可部署到边缘设备或高并发场景,扩大服务覆盖。
与现有工作流集成
NSC 计算仅依赖架构规范,可作为训练前评分器 嵌入 AutoML 平台或模型训练 pipeline。推荐流程:先用 NSC-DP 生成满足资源约束的候选集合(帕累托前沿),再交给更昂贵的训练代理精评。提供 Python 库接口,输入 YAML/JSON 架构配置,输出 NSC 分数或优化配置,与 PyTorch、Hugging Face Transformers 生态无缝衔接。
局限
- **依赖随机初始化假设**:NSC 的核心推导建立在权重矩阵遵循标准随机初始化(如高斯分布)且满足 Marchenko–Pastur 定律的前提上。论文虽展示了对常见初始化方案的鲁棒性,但实际训练后的权重谱会发生显著偏移,尤其在预训练模型剪枝或使用非标准初始化(如正交初始化、缩放初始化)时,NSC 的预测精度可能下降。与 **Zen-NAS** 等基于表达能力的代理相比,NSC 的闭式解虽然高效,但牺牲了对训练动态和实际收敛行为的建模能力,因此在某些需要精确排序的场景中可能不如基于梯度或扰动的代理(如 **SNIP**、**GraSP**)。
- **仅考虑权重矩阵谱,忽略非线性与归一化组件**:NSC 只对线性层权重矩阵的奇异值谱建模,未纳入激活函数、LayerNorm、残差连接、注意力 softmax 等对模型容量和表达力有重要影响的组件。在 Transformer 中,NSC 通常仅应用于投影层,无法刻画自注意力模块内部的 token 交互复杂度;在 CNN 中,对特殊卷积(如深度可分离卷积、动态卷积)的抽象可能过于简化。因此 NSC 的排序优势在包含复杂非线性结构的架构家族(如 MobileNetV3、EfficientNet)上可能减弱,泛化性有限。
- **NSC-DP 的约束与搜索空间限制**:NSC-DP 的全局最优性依赖于 NSC 的层可加性和资源约束的线性可加性。实际系统约束(如内存带宽、延迟、芯片利用率)往往是非加性的,无法直接纳入 DP;同时,DP 的状态空间随层数和每层可选宽度/深度的组合呈多项式增长,扩展到细粒度剪枝(如每通道连续剪枝比例)或超大规模模型时,可能面临维度爆炸。与 **Once-for-All**、**BigNAS** 等超网方法相比,NSC-DP 不能直接生成可部署的子网权重,仍需后续训练或微调,因此在实际部署流程中增加了额外步骤。