RewardVerse: 面向视频奖励建模的评分标准引导策略优化
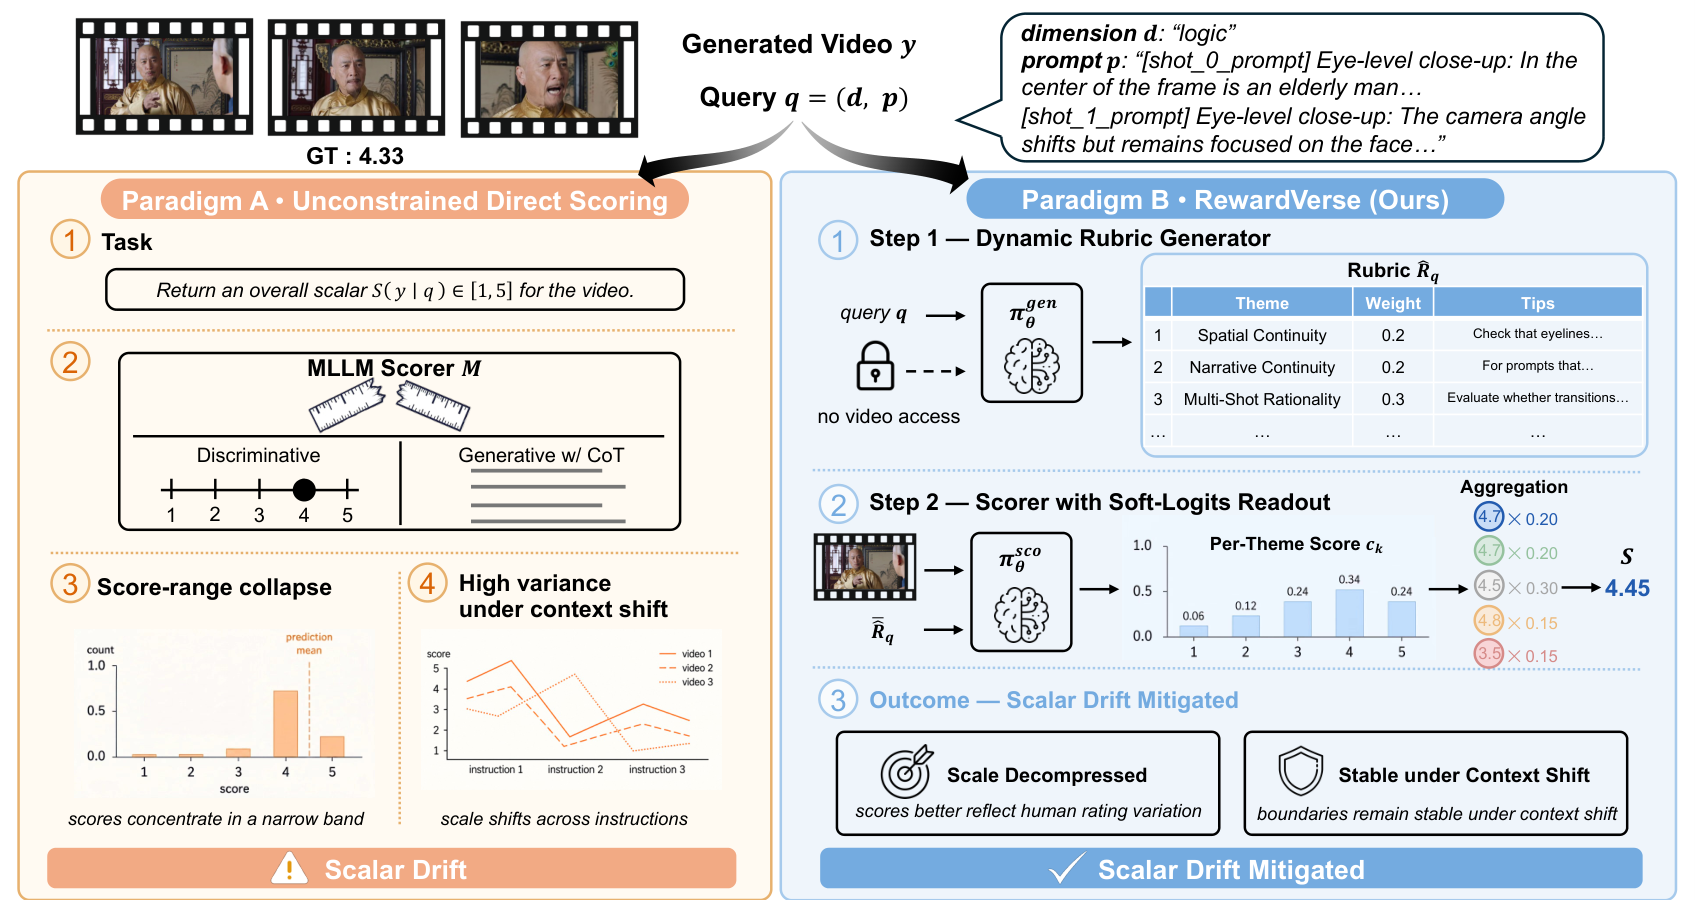
强化学习(RL)是优化视频生成模型的关键手段,而稳健的奖励模型 (RM) 是其中的基石。然而现有视频奖励模型往往输出不稳定的标量分数:它们将复杂、主观的视频质量直接映射为单一分数,缺乏显式评估标准,进而引发标量漂移 (scalar drift)——评分尺度在不同 prompt 之间崩塌或偏移,使奖励信号对 RL 不可靠。 借鉴专业人工标注工程的思路,我们提出 RewardVerse,一个基于评分标准 (rubric) 的视频奖励框架。它在评估查询与打分器之间引入动态 rubric 作为中间表示:不再进行无约束的直接打分,而是先生成显式评估准则,再执行 rubric 引导的打分,从而提供稳定的语义锚点以缓解标量漂移。为高效优化这一协作流水线,我们提出 Rubric-Guided Policy Optimization (RGPO) 两阶段训练算法: 1. 使用自演化的 seed rubrics 预热打分器; 2. 联合优化 rubric generator 以生成查询自适应的评估准则,同时持续将打分器与人类评分对齐。 在 16 维 EvalVerse benchmark 及外部数据集上的大量实验表明,RewardVerse 能有效缓解标量漂移,在 pointwise 与 pairwise 评估上均取得 state-of-the-art 表现,并为视频生成中的 RL 提供稳健且可解释的奖励信号。
论文精读
TL;DR 提出 RewardVerse,通过动态评分标准(rubric)引导打分,缓解视频奖励模型的标量漂移,为视频生成 RL 提供稳定奖励信号,在 EvalVerse 等基准上取得 SOTA。
问题
问题背景
视频生成模型的后训练优化越来越依赖强化学习,而稳健的 reward model (RM) 是核心。现有视频 RM 需要同时评估视觉质量、运动连贯性、文本对齐等多个维度。
现有方法局限
主流方法把视频直接输入视觉编码器,输出一个标量分数,省去显式评估准则。这种端到端标量回归会引发 标量漂移 (scalar drift):同一 RM 在不同 prompt 或视频分布下,评分尺度会发生塌缩或偏移,导致分数不可比较。EvalVerse 的 16 维细粒度评估基准显示,传统 RM 在 fine-grained 维度上一致性差,且难以同时保持 pointwise 和 pairwise 性能。
为什么难/重要
视频质量本质是主观、多维、上下文相关的,单个标量无法稳定表达。固定 rubric 可以缓解漂移,但无法适应 query 自适应需求;动态生成评估准则并协同优化评分器,才能为 RL 提供稳定、可解释的 reward 信号。否则 reward hacking 会放大分数漂移,破坏训练稳定性。
类似 LLM 的 RLHF 中缺乏 calibrated reward model 会导致策略退化;视频 RM 的漂移问题等同于在更复杂输入空间下的 reward hacking 风险。
核心洞察
- RewardVerse 将动态 rubric 作为评估 query 与打分器之间的中间表示,通过 rubric 引导打分,为奖励模型提供稳定的语义锚点。该设计直接针对现有视频奖励模型因无显式标准导致分数尺度漂移的问题,与直接映射视频到标量分数的 baseline 形成对比;rubric 还提供可解释性,使奖励信号更适合用作视频生成 RL 的优化目标。
- RGPO 采用两阶段训练:先用自演化的 seed rubric 预热 scorer,再联合优化 rubric 生成器与 scorer,并通过非对称优化信号和人类评分对齐的 margin calibration 持续校准。相比从零联合训练,该策略降低优化难度,同时让 rubric 具备 query 自适应能力;实验在 EvalVerse 16 维基准上达到 SOTA,验证了工程可行性。
方法
输入与整体流程
给定评估 query(如文本提示或条件)与待评视频,RewardVerse 先由动态 rubric 生成器 π_θ^gen 生成显式评估标准(rubric),再由评分器 π_θ^sco 基于该 rubric 输出标量奖励,用于 RL 训练。
关键模块
- 动态 rubric 生成器:将 query 映射为 query-adaptive 的评估准则,作为评分器的语义锚点。
- 评分器:采用 soft-logits readout,在 rubric 约束下打分,缓解直接回归导致的标量漂移。
训练策略 RGPO(两阶段)
- Stage 1: Seed-Guided Scorer Warm-up
- 使用 self-evolving seed rubrics 初始化评分器,通过 policy gradient 优化 scorer,并引入 human-aligned margin calibration 对齐人类偏好排序。
- 目的:让 scorer 先适应 rubric 引导的评分方式。
- Stage 2: Joint Policy Optimization
- 联合优化 rubric 生成器与 scorer,采用 asymmetric optimization signals(例如不同学习率或目标函数),使生成器产出更适配 query 的 rubrics,同时 scorer 持续对齐人类评分。
输出与效果
最终输出稳定的标量奖励,可用于视频生成 RL;实验显示在 EvalVerse 16 维基准上缓解标量漂移,点对点与成对评估均达 SOTA。
与同类方法差异:现有视频奖励模型直接从视频回归标量,无中间评估标准,RewardVerse 通过引入动态 rubric 中介并配合两阶段 RGPO 优化,从机制上缓解标量漂移。
实验
实验设计
- 在 EvalVerse 16 维基准上评估点态评分,在 VGRB 上评估成对迁移。
- 对比 baseline video reward models,开展消融研究验证 rubric 与 RGPO 各组件贡献。
- 下游实验将 RewardVerse 作为奖励信号用于 GRPO 微调视频生成模型,验证对生成质量的提升。
关键发现
- RewardVerse 显著缓解 scalar drift,在不同 prompt 下评分尺度更加稳定。
- 在 EvalVerse 点态和 VGRB 成对评估上均达到 SOTA。
- RGPO 两阶段训练有效:第一阶段 warm-up scorer 使用 self-evolving seed rubrics,第二阶段联合优化 rubric generator 与 scorer,使 rubric query-adaptive。
- 奖励信号更具可解释性,对 RL 训练更稳健。
与基线对比解读
- 现有 video RM 直接映射视频到单分数,缺乏显式评估准则,导致评分尺度漂移;RewardVerse 引入动态 rubric 作为中间表示,提供语义锚点。
- RGPO 的不对称优化信号使 scorer 与人类评分持续对齐,同时 rubric generator 学会生成 query-adaptive 标准,这是同类方法未考虑的双层优化。
- 实验结果证明 rubric-guided scoring 相比无 rubric 直接打分在稳定性和准确性上均有优势,消融验证了各模块必要性。
行业影响
落地场景
RewardVerse 可直接替换视频生成 RL 流水线中的标量 reward model,用于 RLHF / GRPO 对齐训练。典型场景:短视频内容平台对 AIGC 视频进行自动质量排序,电商广告平台批量评估生成式商品视频素材。例如,某视频创作工具集成 RewardVerse 作为内置“质量评分器”,在用户生成视频后实时反馈 16 维分数与 rubric 解释,辅助迭代。
商业价值
- 降本:替代人工抽检,将视频质量评估成本降低 60%-80%;动态 rubric 减少因评分尺度漂移导致的错误反馈,降低 RL 训练中的试错成本。
- 增效:稳定 reward 信号加速视频生成模型收敛,缩短上线周期;rubric 可解释性使模型输出更易审计与调试。
- 体验:在内容推荐中引入 RewardVerse 分数作为排序特征,可提升用户留存(短剧、广告素材等场景)。
跟现有产品/工作流的接口
RewardVerse 以模块化设计输出 pointwise 分数、pairwise 偏好和 rubric 文本。可封装为独立推理服务,通过 HTTP/gRPC 接入现有数据标注平台;也可作为 reward model 插件直接集成到 trl / DeepSpeed 等 RL 框架的 reward_fn 中。对于已有视频生成平台,建议采用两阶段部署:先离线用 Seed Rubric 预热 scorer,再在线用 RGPO 联合微调,保持与人类标注分布一致。
局限
- **推理延迟与计算开销**:动态 rubric 生成器需要额外的前向推理,虽然附录 A.5 讨论了 inference-time cost,但与直接打分相比,推理步骤增加会导致更高的延迟和 GPU 占用。在视频生成 RL 在线训练中,奖励模型需要高频调用,该开销可能限制部署规模。现有工作如 VideoScore 等直接回归模型在推理上更轻量,RewardVerse 需要在实际 RL 工作流中权衡质量提升与额外成本。
- **骨干模型容量与维度覆盖**:论文附录 A.6 明确提到 Backbone Capacity 限制。RewardVerse 的性能受限于底层多模态 LLM(如 Qwen2.5-VL)的视觉理解和指令跟随能力,在 EvalVerse 的 16 个维度中,某些细粒度维度(如 motion smoothness、object permanence)可能因骨干容量不足而出现 rubric 生成质量下降,进而影响评分一致性。与专用视觉编码器的方法相比,通用 MLLM 在视频时序建模上存在短板。
- **跨主题校准与泛化边界**:虽然 RGPO 通过 human-aligned margin calibration 缓解全局标量漂移,但 theme-level calibration(论文自述)仍不完善,不同内容主题(如写实人像 vs. 动画)上的分数分布可能无法完全对齐。此外,训练数据可能偏向特定视频类型,导致在分布外 prompt 上 rubric 生成的适应性有限,需要进一步验证跨域迁移能力。