将 VLM 的智能迁移到机器人控制
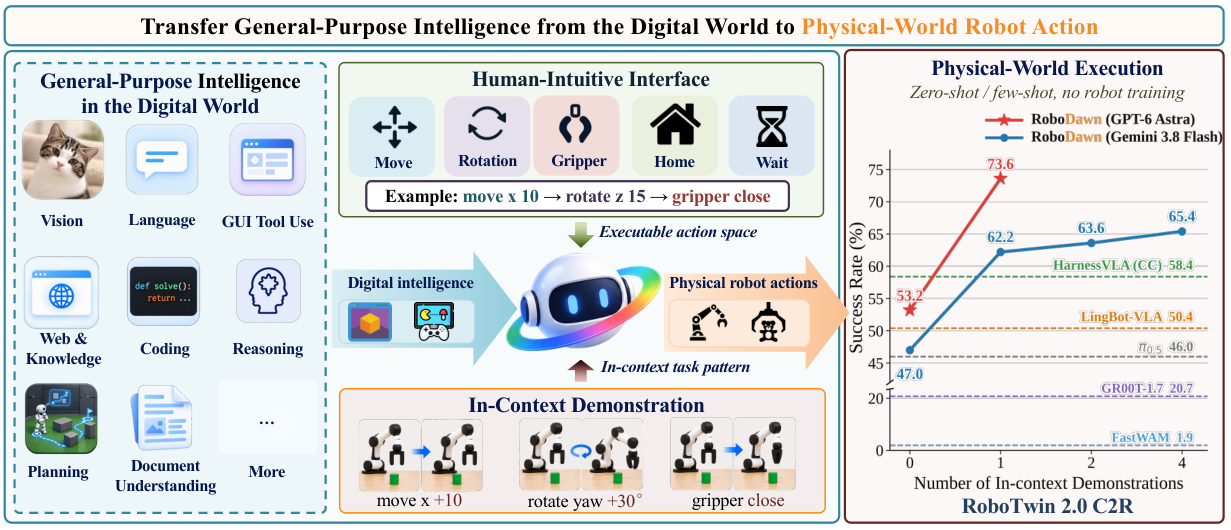
人类能无缝适应物理世界与数字世界,这暗示尽管具身、环境与任务上存在数字到现实的鸿沟,人类智能本身仍可跨越鸿沟迁移。由此引出一个根本问题:视觉语言模型(VLM)的智能能否同样从数字世界泛化到物理世界,用于机器人控制? 我们通过 RoboDawn 研究该问题。这一符合人类直觉的接口,用一组紧凑的离散平移、旋转与夹爪命令,把机器人控制暴露给具备智能体能力的 VLM。VLM 借此以闭环方式控制机器人:观察当前视觉状态、推理下一步动作、执行动作,并依据结果状态调整后续决策。我们还提出上下文学习(ICL)方案,用少量示范让 VLM 同时掌握接口用法与任务求解策略。 在 RoboTwin 2.0 C2R 与 RoboDojo 上的实验表明,RoboDawn 无需任务特定的机器人训练即可取得强劲性能:零样本设置下超过多个基于基准专用机器人数据训练的强策略,仅一个上下文示范便进一步提升性能并达到 SOTA。在 RoboTwin 2.0 C2R 上,成功率从零样本的 53.2% 升至单样本的 73.6%,超过稳健基线 π0.5(46.0%);RoboDojo 上则从 35.67% 升至 47.17%。同一框架也可迁移到真实机器人,在 Franka 上完成方块入篮与积木堆叠任务。
论文精读
TL;DR RoboDawn 通过离散平移/旋转/夹爪命令接口将 VLM 闭环用于机器人控制,并结合 in-context learning,实现零样本超越多个基准专用策略、one-shot 达 SOTA,无需任务特定训练。
问题
问题背景:机器人控制正从任务特定模型转向利用预训练视觉语言模型(VLM)的通用智能,期望以零样本或少样本方式完成操作任务。
现有方法局限:主流端到端策略依赖大规模机器人演示数据,泛化到新任务需要重新采集或微调,成本高;基于 VLM 的高层规划方法通常需要手工设计动作接口或底层控制器,且 VLM 输出连续动作易受噪声影响,零样本性能有限;直接使用自然语言或自由形式运动指令难以映射到精确关节控制,造成 sim-to-real 或零样本迁移困难。
为什么难/重要:数字到物理存在 embodiment、环境和任务差异,VLM 的语义理解与物理动作之间需要紧凑、可解释的离散接口;闭环控制要求 VLM 实时观察状态并推理下一步,对延迟和错误累积敏感;提供少样本示范能快速适应新任务,是降低数据门槛的关键。业界对无需任务特定训练的通用机器人策略高度关注,该工作通过 RoboDawn 接口和 上下文学习(ICL)验证了 VLM 智能跨域迁移的可行性,并在 RoboTwin 2.0 等基准上超越训练专用策略,显示重要应用潜力。
行业类比:类似通用 VLM 在零样本图像理解或代码生成中的表现,但其知识迁移到物理操作时还需解决动作离散化和闭环反馈,难度更高。
核心洞察
- RoboDawn 的核心创新是将 VLM 的通用智能通过一个离散、人类直觉的语义动作接口迁移到机器人控制,而不是训练或微调机器人的端到端策略。与 π0.5 等依赖大量 benchmark 数据进行模仿学习的策略不同,RoboDawn 只需要 VLM 输出离散的 translation、rotation、gripper 指令,在闭环中观察当前视觉状态并推理下一步动作,从而避免学习从视觉像素到连续关节力矩的复杂分布。这个接口设计让 zero-shot 设置下的 RoboDawn 就能超过若干训练过的专用策略,证明 VLM 中已编码的物理操作知识可以通过合适的解耦层直接释放。
- 用 in-context learning 注入极少量的完整演示,可以同时解决接口用法和任务策略两个 grounding 问题。传统 few-shot 机器人策略通常需要数百条轨迹进行微调,而 RoboDawn 的 ICL 只用一个 demonstration 即可让 VLM 学会相应的离散动作序列和任务规划,在 RoboTwin 2.0 C2R 上成功率从 53.2% 提升至 73.6%,超过 π0.5 的 46.0%。这说明 VLM 的 few-shot 抽象能力在物理操作任务上具有极高样本效率,并且 ICL 设计为接口兼容的完整演示,具备直接迁移到新任务的工程可复用性。
方法
输入与闭环流程
- 输入:任务指令(自然语言)、当前视觉观测(相机图像)、可选的少量演示轨迹(用于上下文学习)。
- 闭环控制:VLM 作为智能体,每一步接收视觉状态,推理并输出离散动作命令,执行后观察新状态,循环迭代直至任务完成。
关键模块
- Human-Intuitive Interface:将机器人控制抽象为紧凑的离散动作集,包括平移、旋转和夹爪开合。VLM 输出语义命令(如
move_forward、rotate_left、grasp),接口负责将命令映射为物理运动,避免 VLM 直接预测连续关节量。 - Agentic VLM:利用预训练视觉语言模型进行多模态推理,输入视觉观察和任务描述,输出下一离散动作。
- In-Context Learning (ICL):提供少量接口兼容的演示轨迹,使 VLM 在上下文中学到接口用法和任务解决策略。演示同时覆盖动作格式与高层规划,让 VLM 无需微调即可适配机器人控制。
输出
- 每个时间步输出一个离散动作命令,由接口执行;整个任务通过连续闭环决策完成。
与端到端机器人策略(如 π0.5)不同,RoboDawn 不依赖任务特定机器人数据训练,而是通过离散接口与 ICL 复用 VLM 的通用智能,在零样本和单样本设置下实现控制。
实验
实验设计
在 RoboTwin 2.0 C2R 和 RoboDojo 两个模拟基准上评估 RoboDawn。使用 agentic VLM 通过离散平移/旋转/夹爪指令接口进行闭环控制,对比 zero-shot 与 in-context learning(ICL)设置,并与强基线 π0.5 等对比。真实 Franka 机器人上验证 block-in-basket 和 block stacking 任务迁移。
关键发现
zero-shot 下,RoboDawn 在 RoboTwin 2.0 C2R 上成功率 53.2%,已超过任务特定训练的 π0.5 的 46.0%;单次 in-context 示范后提升至 73.6% (+20.4 pts),达到 SOTA。RoboDojo 上同样从 35.67% 提升至 47.17%。表明 VLM 智能可迁移到物理控制,且无需任何微调。
基线对比解读
与在基准数据上专门训练的端到端策略相比,RoboDawn 的 zero-shot 性能更具泛化性,说明 VLM 语义知识能有效弥补数字-物理差距。离散指令接口显著降低动作空间复杂度,使 VLM 闭环推理更稳定;ICL 示范进一步对齐接口使用与任务策略,带来显著增益,且仅需一个示范即可超越多数基线。
行业影响
落地场景
RoboDawn 提供了一种将 视觉语言模型 (VLM) 智能直接迁移到机器人控制的轻量接口,适用于仓储物流分拣、柔性制造装配、服务机器人等场景。例如,在电商订单履约中心,机械臂需要处理大量不同 SKU 的抓取放置任务,传统方法需为每种商品采集数千条机器人演示数据并训练专属策略。借助 RoboDawn,工程师可以仅定义离散语义动作接口(平移、旋转、夹爪),让现成的 VLM(如 GPT-4V、Claude)零样本控制机械臂,通过 1 条演示即可大幅提升成功率,无需重新训练。另一个典型场景是实验室自动化:移液、样本分拣等操作指令变化频繁,RoboDawn 的 in-context learning 允许操作员用极少量演示快速教会 VLM 新任务,减少重复编程成本。
商业价值
核心收益来自降本与加速部署。传统机器人策略依赖大量任务特定数据采集与训练,一个 SKU 的抓取模型可能需要数周甚至数月的数据管线。RoboDawn 在 RoboTwin 2.0 C2R 上零样本成功率 53.2%,1-shot 提升至 73.6%(超过基线 π0.5 的 46.0%),意味着无需机器人数据训练即可达到实用水平,大幅压缩数据标注、仿真到真机迁移的工程开销。同时,由于控制接口是语义离散命令,VLM 的推理成本低于连续动作生成,适合云端或边缘部署;且对 VLM 的升级敏感,模型能力提升可直接带来操控性能提升,形成持续增收的复利效应。
与现有产品/工作流的接口
RoboDawn 可以封装为高层决策插件,接入现有机器人软件栈:
- 语义动作接口与 ROS 2 的 action server 对接,将 VLM 输出的离散命令映射为底层运动规划;
- ICL 演示以 few-shot prompt 形式注入 VLM 上下文,可与 LangChain / LlamaIndex 等 agent 框架集成;
- 对已有 VLM API 产品,只需新增一个薄适配层,将视觉观测编码为图像 token,输出命令 token,即可让通用大模型获得机器人操控能力。
这种低耦合设计允许工程团队在保留现有运动控制、安全模块的基础上,快速验证 VLM 驱动的闭环策略。例如,在医疗辅助机器人产品中,可以先以 RoboDawn 作为遥操作辅助,由 VLM 提出动作建议,操作员确认执行,逐步过渡到更高自主性。
局限
- **离散动作接口限制**:RoboDawn 使用离散的平移、旋转和夹爪命令,虽然降低了 VLM 的控制难度,但也限制了动作的精细度和连续性。对于需要精确力控、高速动态响应或连续轨迹优化的任务,离散命令可能无法满足要求。真实世界实验仅展示了 block-in-basket 和 block stacking 等简单操作,尚未验证复杂接触丰富任务中的表现。此外,闭合环路中的 VLM 推理速度可能影响控制频率,难以部署到实时性要求高的场景。
- **依赖 VLM 先验知识**:方法的核心假设是 VLM 已具备足够的视觉理解和常识推理能力,从而在零样本或少量示例下完成机器人任务。然而,当任务涉及 VLM 训练分布之外的动作或环境时,可能出现错误推理或幻觉,导致机器人执行错误动作。虽然 ICL 能缓解部分问题,但收集演示数据仍需人工成本,且对于长周期、多步骤任务,单一演示可能不足以覆盖所有状态变化,泛化性有限。
- **与端到端策略对比的潜在上限**:RoboDawn 在零样本和 one-shot 场景下超越了若干 benchmark 特定训练的端到端策略(如 π0.5),但这些端到端模型经过大规模机器人数据微调后可能达到更高成功率,且能够输出连续动作,更适合精细操控。RoboDawn 的性能可能受限于 VLM 本身的推理能力和离散动作空间的表达力,在需要高频闭环或复杂接触动力学的任务中,可能难以匹敌专门设计的端到端策略。