One to More, More to One:面向软件工程智能体的类别感知迭代专家训练
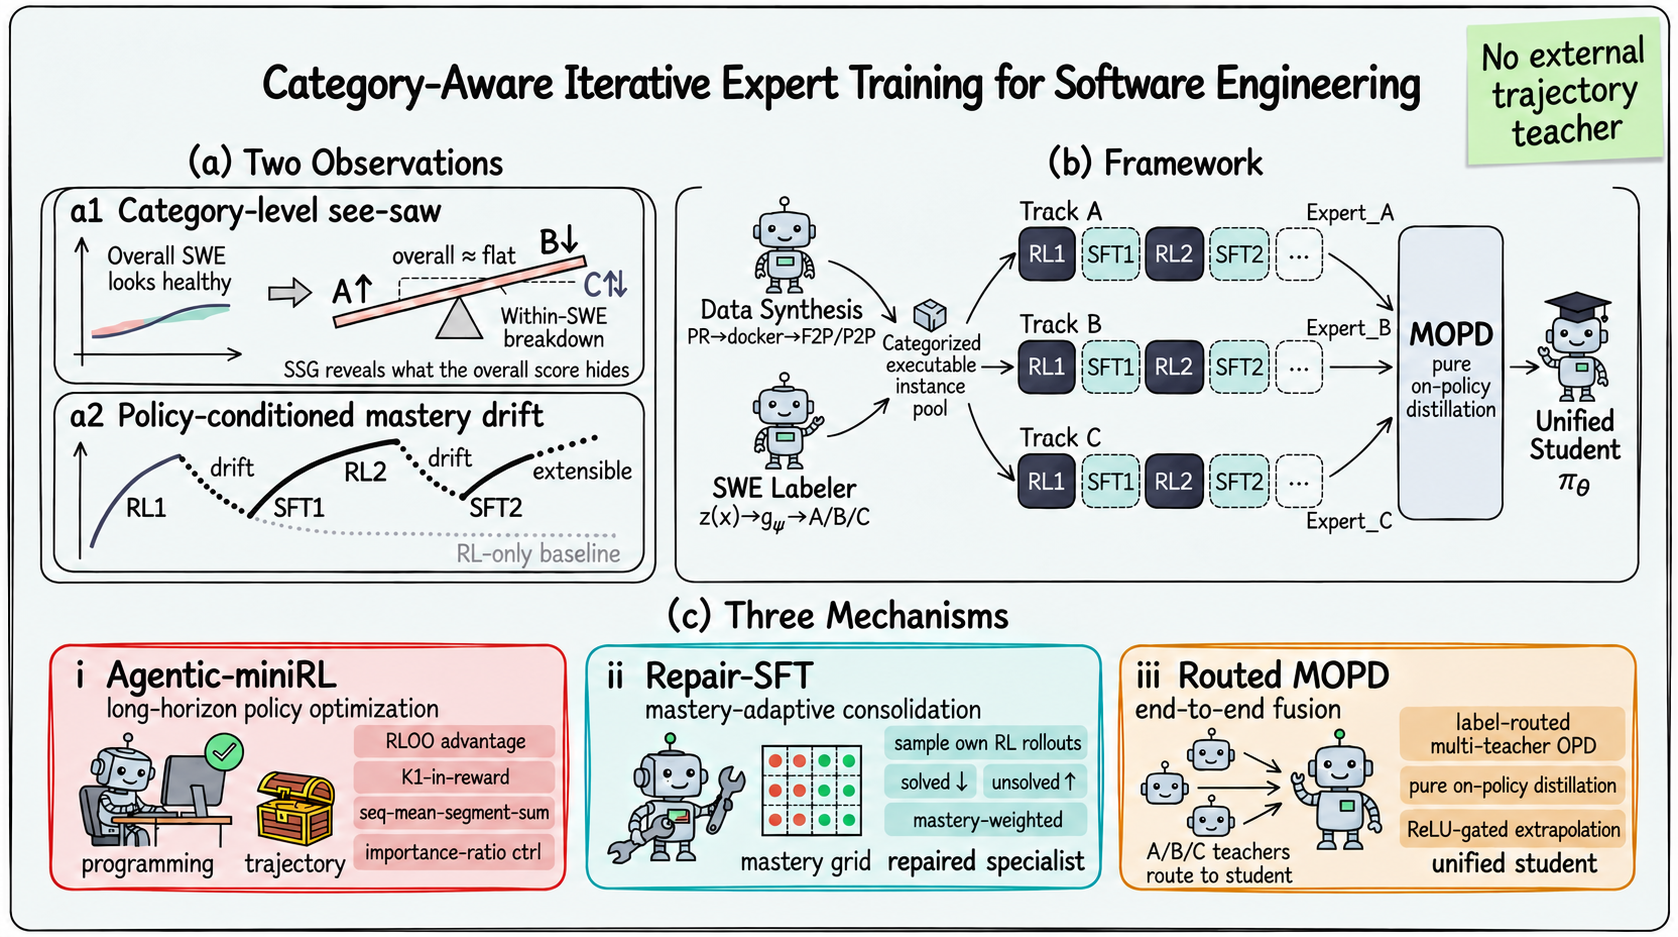
仓库级软件工程(SWE)包含异构的任务类别,而它们在池化智能体强化学习 (pooled agentic RL) 下的进展可能并不均衡:某些类别的提升往往伴随其他类别的回退,而聚合解决率掩盖了这些变化。受这种类别跷跷板 (category see-saw) 现象驱动,我们提出了一套类别感知的专家训练与策略整合框架。 在方法上,可执行任务构建与 SWE Labeler(一个基于证据的多轴标注系统)负责组织训练池。初始的类别专属 RL 提升了平均训练成功率,但实例级进展仍不均衡,这促使我们显式整合成功行为并进行策略自适应任务选择。同源类别专家交替执行长程 Agentic-miniRL 与 Refresh-Repair-Expand (RRE):更新后的策略刷新实例掌握度,复用自身已验证的成功轨迹进行 Repair SFT,并重选任务用于后续 RL。Label-routed multi-teacher on-policy distillation (MOPD) 将各专家整合为单一可部署学生模型,并通过 ReLU-gated reward extrapolation 只保留每个教师相对参考的改进方向。专家训练与策略整合均不需要外部模型提供解题轨迹或动作目标。 实验上,我们通过聚合与逐类别分辨率、相对每个联合 RL 基线的最小类别提升,以及专家增益恢复率,评估 Pooled RL 与 Balanced RL、专家开发过程与单模型整合。最终 MOPD 策略在 Pro-618 上取得 58.04% 的平均解决率,在 SWE-bench Multilingual 上取得 59.00%,分别较基座模型提升 5.39 与 2.78 个百分点。
论文精读
TL;DR 针对仓库级软件工程智能体的类别跷跷板问题,提出类别感知专家迭代训练与多教师蒸馏整合框架,在 Pro-618 与 SWE-bench Multilingual 上分别提升 5.39 和 2.78 个百分点。
问题
问题背景
近年来,软件工程 (SWE) 智能体 在仓库级任务上的研究聚焦于通过强化学习 (RL) 提升长时程、工具使用策略的端到端能力。从 SWE-bench 到更大规模的 Pro-618 等基准,业界希望单一模型能稳定处理多种任务类别,如缺陷修复、特性添加、重构等。
现有方法局限
主流的 联合 RL 将异构任务池混合训练(Pooled RL),采用统一奖励信号。但论文指出,这种聚合式训练存在 类别跷跷板效应:某些类别上的成功率提升同时伴随其他类别的退化,而全局平均 resolve rate 掩盖了类别级变化。此外,现有方法缺乏对任务类别的细粒度标注与证据支撑,难以诊断和修正不均衡进展;专家拆分与融合也多依赖外部模型提供动作轨迹或目标,限制了可扩展性。
为什么这个问题难/重要
仓库级 SWE 任务的长时程特性使 RL 梯度信号稀疏,且不同任务类别对探索、验证和修复的要求差异大。要同时保证类别间的最小增益(minimum category lift)和整体性能,需要对训练数据构造、奖励塑形、专家策略整合进行系统性设计。业界对可靠、可部署的 SWE 智能体需求迫切,但训练不稳定和类别退化会直接导致生产环境中的意外回归,因而该问题具有高工业价值。
行业类比
这类似于多语言模型训练中,提升某些低资源语言性能却导致高资源语言退化,需要用类别感知的专家训练与集成来平衡 帕累托前沿。
核心洞察
- 联合 agentic RL 中的类别跷跷板现象揭示了 pooled training 的隐藏代价,类别感知的专家训练是解决该问题的有效途径。与过去将 SWE 任务混合训练、只关注总体分辨率不同,本文用证据驱动的标签系统细分任务类别,发现某些类别的提升伴随其他类别的退化,而平均指标掩盖了这种此消彼长。通过独立训练类别专家,避免了跨类别的负迁移,实验结果中最低类别增益显著优于 pooled RL 基线,为长时程工具使用策略的训练提供了新的分解思路。
- Refresh-Repair-Expand (RRE) 循环利用智能体自身验证过的成功轨迹进行修复 SFT 并重新选择任务,不依赖外部模型生成解决方案或动作目标。与常见的外部模型蒸馏或人工构造专家轨迹不同,RRE 在 RL 与 SFT 之间交替:更新后的策略刷新实例掌握状态,复用自身成功轨迹进行 Repair SFT 巩固行为,再重新开放当前学习前沿任务继续 RL。这种自举式训练使专家在长时程任务中稳定进步,有效恢复并保留增益,避免实例级回归。
- Label-routed multi-teacher on-policy distillation (MOPD) 通过 ReLU-gated reward extrapolation 整合多个类别专家,只保留每个教师相对于参考策略的改进方向。与简单的模型合并或平均不同,MOPD 根据任务标签路由到相应教师进行在线蒸馏,并利用奖励外推的 ReLU 门控过滤掉教师的退化方向,确保学生仅学习正向增益。该方法让单一部署模型有效恢复专家能力,在 Pro-618 与 SWE-bench Multilingual 上分别取得 58.04% 和 59.00% 的分辨率,较基模型提升 5.39 和 2.78 个百分点。
方法
方法概述
输入为仓库级软件工程任务的可执行实例集合。首先通过 SWE Labeler——一个基于证据的多轴标注系统——为每个任务分配类别标签,形成可路由的类别训练池。
关键模块
类别专家训练:对每个任务类别独立训练专家策略。采用 Agentic-miniRL 进行长时程强化学习,其目标包含奖励中心化、近端行为修正与回合感知归约,以适应多步工具调用场景。训练过程交替执行 Refresh–Repair–Expand (RRE) 循环:
- Refresh:用当前策略重新评估实例掌握状态,同步掌握图谱。
- Repair:将策略自身生成的、经验证的成功轨迹用于监督微调,巩固正确行为。
- Expand:根据掌握状态重新选择任务,扩展当前学习前沿。
策略集成:使用 Label-routed Multi-teacher On-policy Distillation (MOPD) 将多个类别专家蒸馏为单一学生策略。蒸馏按任务标签路由到对应教师,并通过 ReLU 门控奖励外推 只保留每个教师相对参考策略的正向改进方向,避免跨类别负迁移。
输出
最终得到一个可部署的单一策略,在 Pro-618 与 SWE-bench Multilingual 上分别达到 58.04% 和 59.00% 的解决率,较基础模型提升 5.39 和 2.78 个百分点。
与同类方法的关键差异:整个专家训练与策略集成过程不依赖外部模型提供解决方案轨迹或动作目标,完全基于自身交互与验证信号,且显式解决类别间跷跷板问题。
实验
实验设计
- 基线设置:Pooled RL(混合训练)与 Balanced RL(类别平衡采样)。
- 专家训练:按类别使用 Agentic-miniRL 与 Refresh-Repair-Expand (RRE) 迭代框架。
- 集成:Label-routed Multi-teacher On-policy Distillation (MOPD) 将专家合并为单一策略。
- 评估:在 Pro-618 和 SWE-bench Multilingual 上考察聚合与逐类别 resolution,以及最少类别提升。
关键发现
- 联合 RL 存在 类别跷跷板:部分类别提升伴随其他类别回退。
- 类别特定 RL 提升平均成功率,但实例级进展不均;RRE 通过自我轨迹修复与任务重选缓解该问题。
- MOPD 集成后:Pro-618 达到 58.04%,SWE-bench Multilingual 达到 59.00%。
与基线对比
- 相对 base model:Pro-618 提升 5.39 个百分点,SWE-bench Multilingual 提升 2.78 个百分点。
- 相对 joint-RL 基线:通过最少类别提升指标反映更均衡的跨类别增益。
行业影响
落地场景
该框架可落地于 代码智能体平台、IDE 插件 与 企业级 DevOps 流水线。针对仓库级软件工程任务,如 bug 修复、重构、测试补全,按任务类别训练专家策略再融合为单一部署模型。典型场景:电商后端服务 的代码仓库中,自动修复并发缺陷并补全回归测试;SaaS 平台 的 issue 自动分诊与修复建议生成。无需外部模型提供轨迹或动作目标,降低落地门槛。
商业价值
- 降本:减少人工代码审查与修复时间,降低缺陷逃逸率。
- 增收:加速特性交付,提升开发者吞吐量,让团队聚焦高价值架构工作。
- 体验提升:在 CI/CD 中提供实时、类别感知的修复建议,缩短反馈循环。
框架在 Pro-618 与 SWE-bench Multilingual 上分别提升 5.39 和 2.78 个百分点,证明其在真实仓库任务上的泛化收益。
与现有产品/工作流的接口
框架输出单一可部署策略,可通过 REST API 或 本地推理服务 集成到现有 agent 框架(如 LangChain、AutoGen)。其 Label-routed multi-teacher on-policy distillation (MOPD) 整合专家,保留每个老师的改善方向,适合在线更新。企业可将该策略作为代码评审机器人挂载到 GitHub/GitLab 的 webhook,或嵌入 CI 流水线作为质量门禁。
典型集成路径:
- 使用
SWE Labeler对企业内部代码库进行类别标注; - 按类别训练专家策略并运行 RRE 迭代;
- 通过 MOPD 蒸馏为单一模型;
- 部署为代码助手插件或自动修复 bot。
局限
- **标签系统依赖与成本**:SWE Labeler 的证据驱动多轴标注虽避免了外部模型生成轨迹,但其依赖任务与轨迹证据的质量和覆盖率。若证据稀疏或存在偏差(如特定仓库风格、issue 描述习惯),可能错误划分类别,进而误导专家训练。论文未讨论标注成本与跨领域可扩展性,在实际复杂多语言仓库中可能需大量人工审计。
- **训练流程复杂与算力开销**:框架包含 Agentic-miniRL、RRE 循环、MOPD 蒸馏等多个阶段,针对每个类别训练独立专家并刷新、修复、扩展,再集成为单模型。这带来显著的计算与工程开销,不利于快速迭代或资源受限环境。论文仅在两个基准(Pro-618、SWE-bench Multilingual)上验证,且未对比更轻量的多任务学习或参数高效融合方案,泛化性存疑。
- **评估局限与可解释性**:实验主要依赖解析率指标,对专家增益的恢复和类别提升做了分析,但缺少对策略内部行为变化的深入诊断(如类别混淆模式、失败案例归因)。与同类工作相比,未充分展示与其他多专家集成方法(如模型合并、加权蒸馏)在相同资源下的直接比较,因此框架的增益是否来自特定组件还缺乏消融中细粒度隔离。