Designer-RSI:面向智能体平面设计,从用户流量中演化程序性记忆
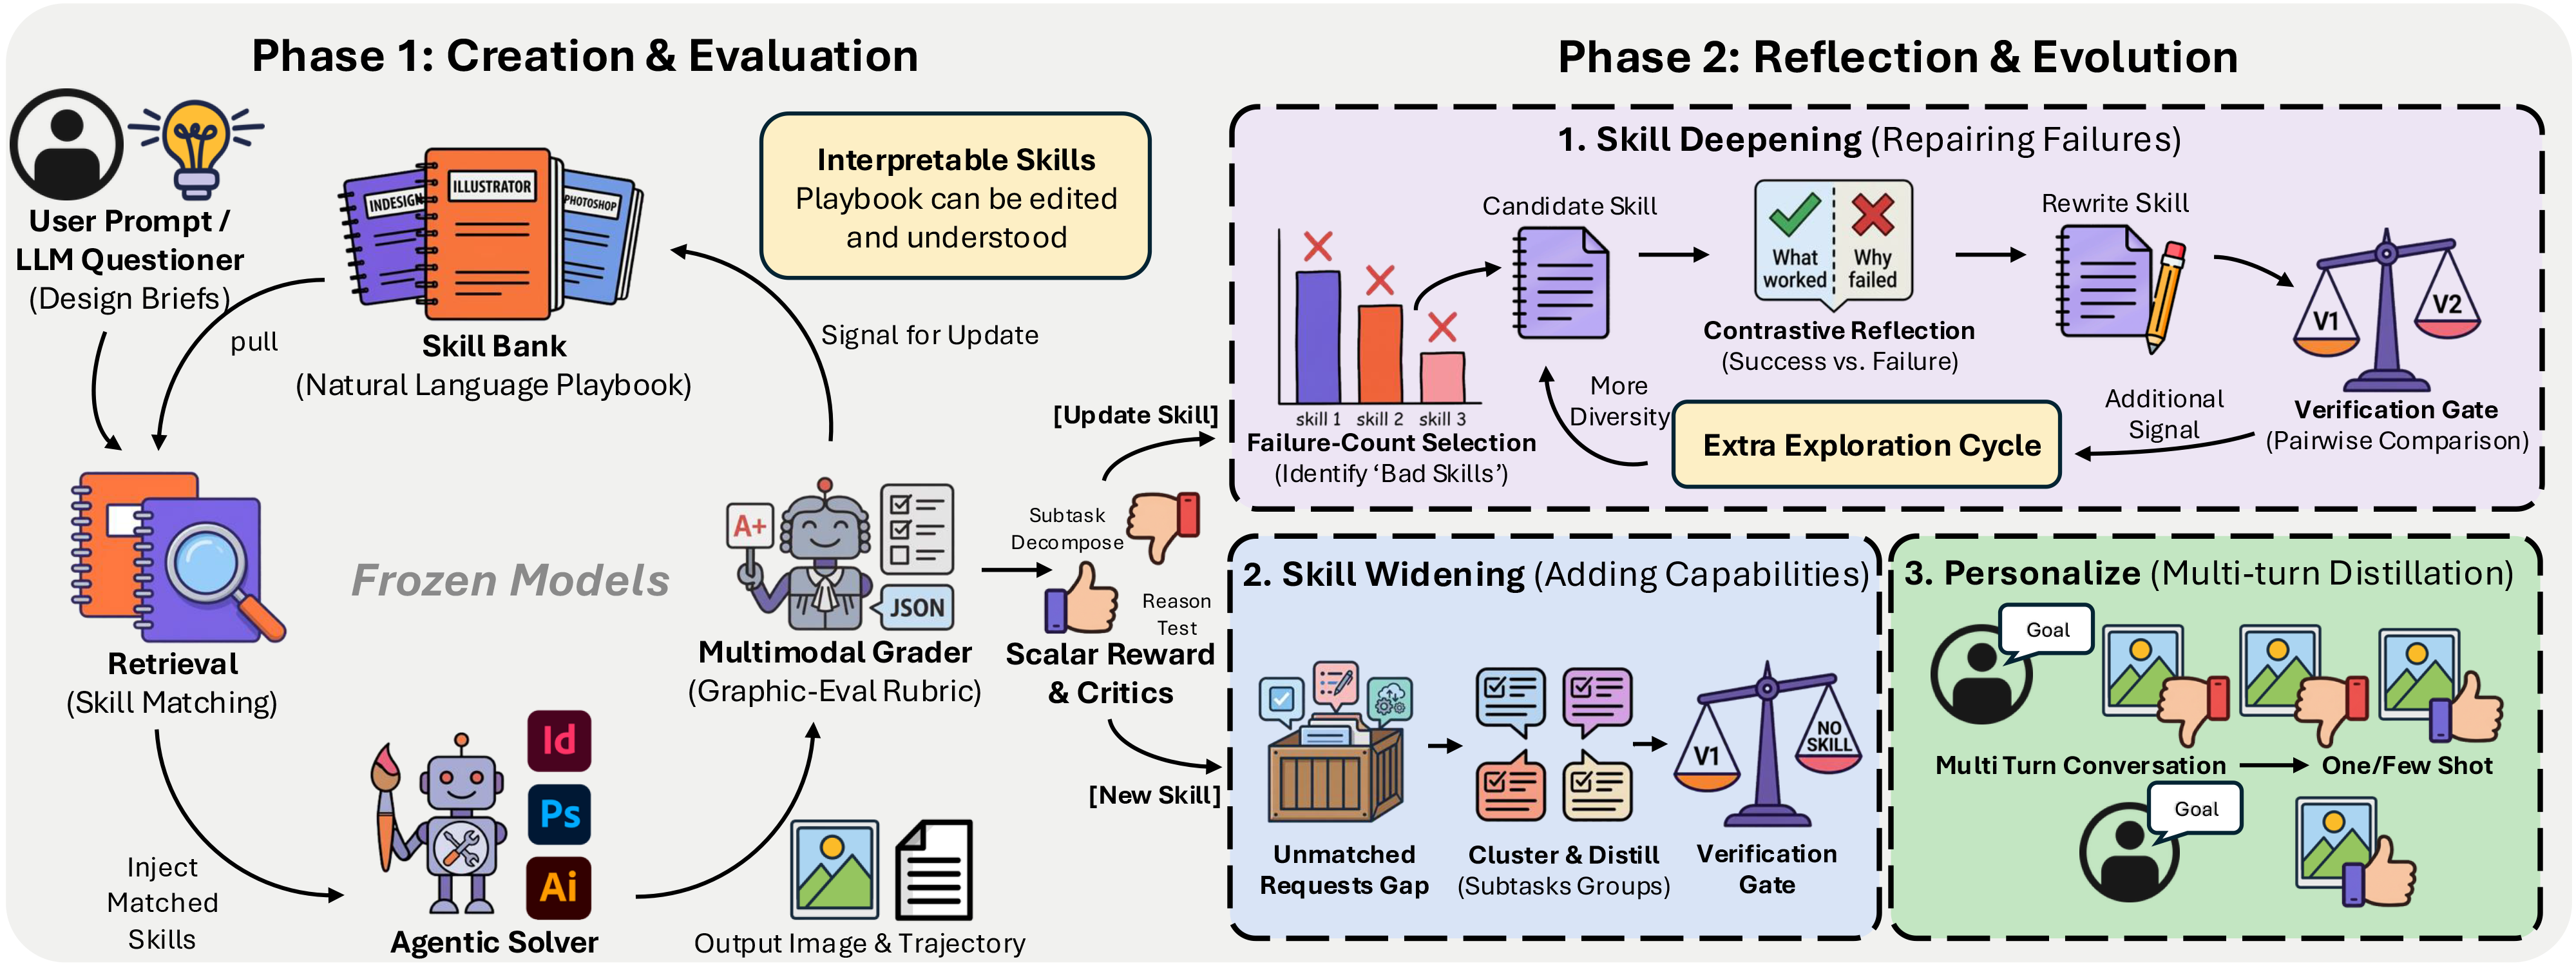
专业平面设计是长时程智能体任务:结构化、可编辑的产物源于大量相互依赖的动作,而结果缺乏可靠的程序化评判标准。 我们提出持续适应框架 :冻结的前沿模型通过 230+ 工具 操作专业设计软件,外部程序性记忆 以自然语言技能形式积累并精炼可复用的设计流程。扩展指为反复出现的未覆盖子任务获取新流程,深化指依据流程自身的成功与失败执行进行修订,匹配重放门控仅接纳能修复失败且不损害既有成功的改动。 在 1,406 条真实用户简报与 1,869 条自动评分轨迹上迭代五轮(无权重更新、无人工标注),技能库由 76 条文档衍生技能增至 139 条,GenEval2 执行成功率在 Claude-Sonnet-4 上从 72.7% 升至 99.3%(生成质量 +11.99 分),并在四个专业设计基准上对无技能智能体取得 61.8%/67.6% 胜率(Claude-Sonnet-4 / Claude-Opus-4.6)。 两种机制组合更为有效:在 200 条用户流量留出简报上,单独扩展或深化的胜率为 49.4%/48.6%,结合后达 58.5%(p = 0.025)。程序性记忆 为噪声、不可验证反馈下的智能体持续适应提供了实用路径。
论文精读
TL;DR 面向专业图形设计长程智能体,Designer-RSI 通过外部程序性记忆从用户流量中持续演化技能,冻结模型、无人工标注,将 Claude-Sonnet-4 执行成功率从72.7%提至99.3%,并显著优于无技能基线。
问题
问题背景:长时程 agentic 任务中,专业图形设计需在 230+ 工具 空间内完成数十步依赖操作,输出是结构化、可编辑 artifact,但无可靠程序化 oracle 验证质量。
现有方法局限:
- 依赖权重微调或 RL 的方法在 frozen frontier model 场景不可用,且每次迭代需大量 GPU / 标签。
- 常见记忆机制仅缓存原始轨迹或做 embedding 检索,缺少将经验提炼为可复用、可验证的 程序化技能(natural-language procedure)的能力。
- 自动反馈噪声大且不可验证,直接基于成败信号修改技能容易 灾难性遗忘 或回归已有成功用例。
- 图形设计质量主观,无法用程序判定 reward,传统 self-play / verifier 方法失效。
为什么难/重要:
- 工具面大(230+)、动作依赖长、反馈滞后且不可靠,agent 必须同时拓宽新子任务技能、深化已有技能,并确保改动不能破坏旧行为。
- 真实用户流量是无标签、带噪声的数据流,是模型部署后最廉价且持续的改进来源;能否利用它决定 agent 系统的长期竞争力。
- 该问题横跨记忆、持续学习、工具调用,是生产级 agent 的关键瓶颈。
行业类比:类似客服 agent 用真实对话日志自动扩充 FAQ 和 SOP,但需要 replay 机制保证新规则不推翻旧的成功案例。
核心洞察
- 将 agent 持续改进从模型权重更新转移至外部程序性记忆:冻结的 frontier 模型通过从真实用户流量中挖掘可复用自然语言技能(技能库从 76 扩至 139),无需任何权重更新或人工标注。与依赖可验证奖励的 RLHF 或 self-play 不同,该方法在无可靠 programmatic oracle 的开放设计任务中有效,GenEval2 执行成功率从 72.7% 提升至 99.3%,证明记忆演化是嘈杂、不可验证反馈下的实用路线。
- 提出 widening(新增技能)与 deepening(修订现有技能)双机制,并用匹配重放门控(Replay Gate)筛选更新:仅接受能修复失败且不降低既有成功案例的变更,防止技能记忆的灾难性遗忘。消融显示,单独 widening 或 deepening 在 held-out 集上相对无技能 agent 的胜率分别为 49.4% 和 48.6%,而组合达到 58.5%(p=0.025),说明两者互补且必须配合重放验证,为 noise 下的持续学习提供了可落地的安全更新范式。
方法
输入
用户 brief(自然语言描述的设计任务)与 agent 在专业设计软件中执行产生的轨迹(工具调用序列、中间结果及自动评分)。初始技能库由文档派生,共 76 条自然语言技能。
关键模块
- 冻结的前沿模型:如 Claude-Sonnet-4,权重固定,仅作为策略执行器,通过 >230 个工具 操作设计软件。
- 外部程序性记忆:以自然语言技能形式存储可复用设计流程。每个技能包含触发条件、步骤说明和工具绑定。
- Widening(扩展):从重复出现的未覆盖子任务中铸造新技能。通过轨迹聚类发现高频失败或缺失步骤,归纳为通用流程,加入记忆。
- Deepening(深化):对已有技能根据其成功/失败执行进行修订。利用对比分析,调整步骤顺序、参数范围或错误处理逻辑。
- Matched Replay Gate(匹配重放门):将修订版本与原版本在历史成功/失败样本上重放对比,仅接纳同时满足“修复失败”且“不回归成功”的更改。
输出
更新后的技能库(从 76 增至 139 条),使执行成功率在 GenEval2 上从 72.7% 提升至 99.3%,并在多个设计基准上取得显著 win rate。
差异点
与依赖参数更新或人工反馈的自改进方法不同,本框架通过外部记忆与匹配重放门实现无权重更新、无人工标签的持续适应。
行业影响
落地场景
Designer-RSI 面向专业设计软件中的自动化助手场景,适合需要可编辑结构化产出且反馈噪声高的图形设计任务。例如:
- 电商平台:批量生成商品主图、促销 banner、社交媒体素材,保持品牌一致性并快速迭代。
- 内容平台:为创作者提供个性化模板自动适配,降低设计门槛。
- 企业服务:自动生成符合品牌规范的营销材料、演示文稿。
该框架通过外部程序性记忆累积可复用设计流程,无需更新模型权重,可适应不同用户流量中不断出现的新需求。
商业价值
- 降本:减少人工设计师在重复性排版、素材调整上的时间,提高内容产出吞吐量。
- 增收:加速内容产出周期,支持高频营销活动,提升转化机会。
- 体验提升:记忆随时间演化,
GenEval2执行成功率从 72.7% 提升至 99.3%,用户会感受到助手更“懂”自己的设计习惯。
与现有产品 / 工作流集成
- 以外部技能库(
load_skill注入)形式与现有图像生成或设计 API 集成,无需重训模型。 - 通过用户流量日志自动生成训练反馈,与 CI/CD 流水线结合,实现持续部署。
- 可对接 A/B 测试框架,用
Replay Gate保证技能更新不回归已有成功案例。
具体落地案例
- 电商场景:将 Designer-RSI 接入商品图自动生成服务,用户上传产品图后,agent 根据历史成功技能自动完成抠图、排版、色彩搭配,输出可编辑文件,设计师仅做微调,有望显著降低单图制作成本。
- 内容平台:为创作者提供“一键套用模板”功能,agent 根据用户历史行为调整模板细节,生成更符合个人风格的封面图或插画。
局限
- - **自动评测与基线强度**:论文采用 **Graphic-Eval** 自动评分,涵盖渲染、完整性、美学和批评四轴,但美学 1–10 锚定由模型评判,缺少大规模人工偏好对齐;胜率以无技能 agent 为基线,该基线可能过弱,因此 61.8% / 67.6% 的 win rate 不一定代表真实用户满意度提升。同时全程无 human labels,失败信号本身带有噪声,replay gate 只依据自动判定,可能引入系统性偏置,且未报告误接受率对最终 skill bank 的影响。
- - **依赖用户流量与冷启动**:记忆扩展(re-widening)依赖用户 briefs 中反复出现未覆盖子任务;在长尾任务多或流量稀疏的设计场景中,新技能铸币可能低效甚至产生大量低复用过程。冷启动需要 76 个 documentation-derived skills,若文档质量不足,初始 bank 覆盖率低,五轮演化虽然增至 139,但未量化新增技能的实际调用频率与边际收益。检索采用 token overlap 而非 embeddings,可能漏掉语义相似但用词不同的 skill。
- - **模型冻结与迁移边界**:框架保持 frontier model 权重完全冻结,只能通过外部 procedural memory 改变上下文,无法纠正模型内在的视觉生成或推理缺陷;例如个性化方法中感知和精度限制的部分失败,技能路径本身无法解决。实验只在 **Claude-Sonnet-4** 和 **Claude-Opus-4.6** 上验证,且限定于 >230 工具的专业设计软件,跨模型、跨工具域或跨任务的泛化未做评估;memory 存放自然语言过程,若更换底层模型能力分布变化,既有 skill bank 可能需要重新适配。