MintAct: 面向数字环境的统一视觉智能体
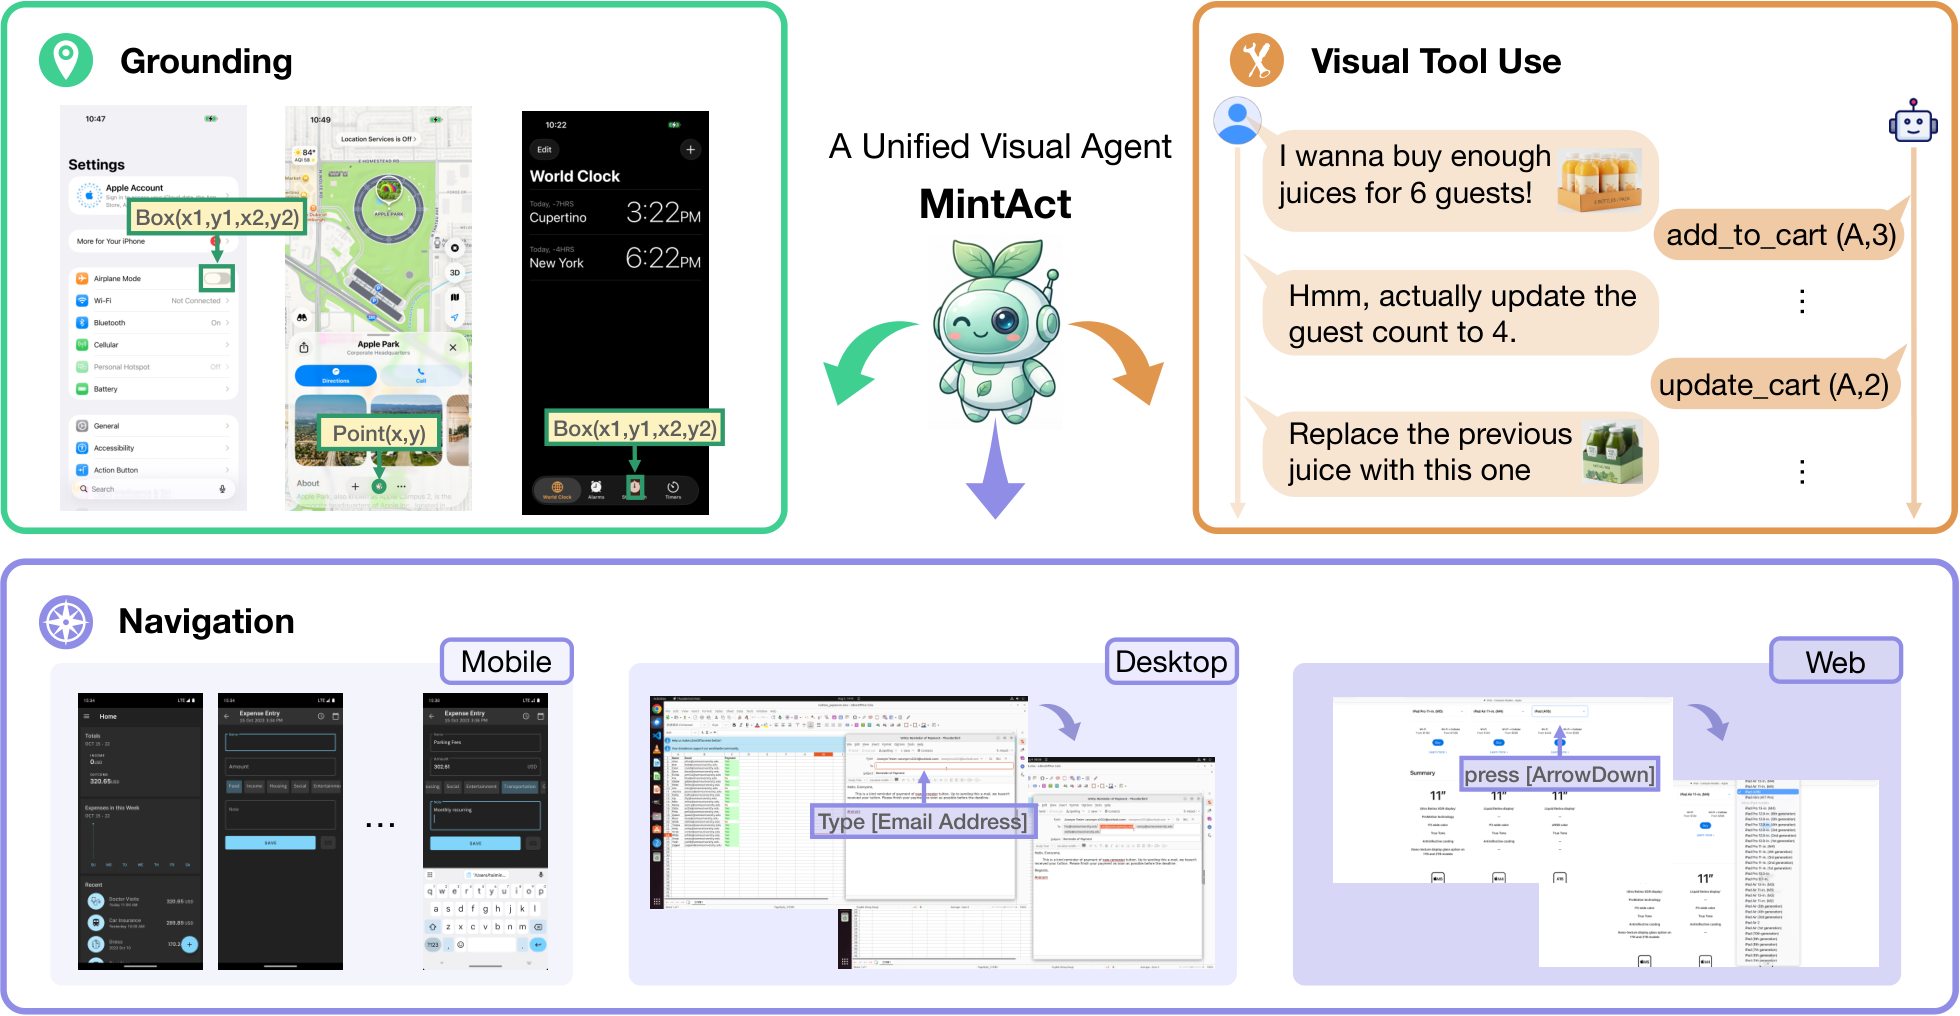
我们提出 MintAct 系列视觉语言模型,统一了 UI grounding、跨 mobile、desktop、web 的多步导航以及视觉工具调用能力,并提供 2B、4B、8B 三种规模。通过精心设计环境、数据与训练配方,MintAct 在以上各类能力上均达到与各领域专用模型相当的性能。 为实现这一目标,我们构建了可扩展的环境与强化学习(RL)基础设施: - 环境侧:在异构的 per-domain 后端上托管数百个并发实例,同时服务于轨迹数据采集与在线 RL。 - 训练侧:采用异步框架,显式控制跨域训练数据分布,并在噪声环境反馈与 off-policy 漂移下保持稳定。 实验结果表明,在相近模型规模下,MintAct 在广泛基准上取得 state-of-the-art 性能,其中 OSWorld-Verified 达到 48.9。
论文精读
TL;DR MintAct 是统一视觉语言模型系列,跨手机、桌面和网页完成 UI 定位、多步导航与视觉工具调用;2B/4B/8B 单一模型性能达到各领域专精模型水平,OSWorld-Verified 48.9 分 SOTA。
问题
问题背景
视觉语言模型(VLM)驱动的 GUI Agent 已在移动端、桌面端与 Web 等单一平台展示出较强的 UI 定位与多步导航能力,但跨平台统一能力仍然稀缺,成为数字自动化落地的瓶颈。
现有方法局限
- Per-domain specialists 各自为政:移动、桌面、Web 分别训练独立模型,缺乏共享视觉-动作表征,导致部署与维护成本高昂,且无法利用跨域数据协同。
- 数据与动作空间割裂:不同平台 UI 元素层级、截图分辨率、交互原语差异显著,现有数据集难以统一标注,模型难以在一个动作空间中完成跨域泛化。
- 异步 RL 训练不稳定:多轮交互中环境反馈延迟与噪声、off-policy 数据漂移,以及不同环境回报尺度不一致,使得跨域联合 RL 难以收敛,经常出现性能互相干扰。
为什么这个问题难/重要
- 真实数字环境状态空间巨大,动作粒度从像素级点击到高层工具调用不等,奖励稀疏,探索效率低。
- 同时保持 UI 定位精度、长程规划稳定性和视觉工具使用能力,对模型容量与训练策略构成双重挑战。
- 业界对能跨设备、跨应用完成任务的通用数字代理需求强烈,统一模型可大幅降低多平台自动化工程的重复投入。
行业类比
类似通用机器人从单任务专用控制器走向多任务统一策略,MintAct 试图在数字环境中完成相似的整合,若成功将重塑 GUI 自动化的基础架构。
核心洞察
- 跨域统一与异步 RL 解耦训练分布控制。MintAct 的异步 RL 框架将 rollout、环境管理和训练分离,通过消息队列与参数同步器显式控制跨域训练分布,在数百并发实例上保持稳定。与常见的同步采样或简单混合多环境数据的方法不同,该设计能有效缓解异构环境噪声反馈和 off-policy drift 带来的训练不稳定,为大规模多域 agent 训练提供可扩展的工程范式。
- 联合 SFT + RFT + 联合 RL 的多阶段训练管线。论文实验表明,multi-stage SFT 和 rejection sampling fine-tuning (RFT) 对维持各域性能必不可少,而 joint RL 在 RFT 之后仍能带来进一步提升。与直接混合所有 domain 数据单阶段训练或分别训练 specialist 相比,该管线在统一模型内保留了域特化能力,使 joint RL 模型平均表现超过各环境单独优化的 RL-specialists。
- 高分辨率单步 SFT 与低分辨率多步 SFT 分离。MintAct 将高分辨率单步 UI grounding/action 预测与低分辨率多步 trajectory 建模分开训练,解决视觉 agent 中分辨率与序列长度、显存之间的取舍。相比统一分辨率处理所有数据的主流做法,这一分离在资源约束下扩展了多步交互数据的覆盖,同时保障了单步定位精度,是实际构建长时程视觉 agent 的关键策略。
方法
输入
MintAct 接收视觉观察(屏幕截图或工具返回图像)和自然语言指令,覆盖移动、桌面、网络和视觉工具使用四类数字环境。
关键模块
- 统一视觉-语言模型:以单模型处理三种能力:UI 元素定位(高分辨率单步图像输入)、多步导航(低分辨率多步轨迹输入)和视觉工具使用(根据工具输出生成下一步动作)。模型规模覆盖 2B / 4B / 8B。
- 分阶段训练流程:
- 高分辨率单步 SFT:强化 UI grounding 精度;
- 低分辨率多步 SFT:构建长轨迹,学习跨步依赖;
- RFT(拒绝采样微调):对生成样本进行筛选,保留成功轨迹再训练,提升领域特定表现;
- Agentic RL:使用环境奖励进行在线强化学习。
- 异步 RL 基础设施:包含
Rollouter(采样轨迹)、Environment manager(管理数百个并发环境实例)、Trainer、Message queue和Parameter Synchronizer。该框架显式控制跨域训练分布,在噪声环境反馈与 off-policy 漂移下保持稳定。 - RL 训练策略:采用多轮输入格式保留上下文;动态组过滤剔除低质量样本;off-policy 目标函数容忍策略滞后。
输出
模型直接输出可执行动作(点击、滑动、键入、工具调用等),在 OSWorld-Verified 上取得 48.9 分,并在多个基准上达到与单域专家模型相当或更优的水平。
与同类方法的差异点:MintAct 不是简单联合训练多个专家头,而是通过统一架构和跨域异步 RL 联合优化,使单一模型在所有能力上匹配专家,并具备域间迁移潜力。
实验
实验设计
MintAct 在 2B/4B/8B 三个规模训练统一 VLM,覆盖 mobile/desktop/web 三大数字环境与 visual tool use。训练分阶段:高分辨率单步 SFT → 低分辨率多步 SFT → RFT 拒绝采样 → 异步 agentic RL。RL 基础设施支持数百并发环境实例,显式控制跨域训练分布,以处理异质后端与 off-policy 漂移。
关键发现
- 统一 SFT 模型在各域保持与单域 SFT 专家相当的性能;多阶段 SFT 与 RFT 对维持域特定能力至关重要。
- 联合 RL 模型平均优于各环境独立 RL 专家,且在 RFT 之后仍有进一步提升。
- 合成环境可弥补真实数据曝光不足。
- 在 OSWorld-Verified 上达到 48.9,为同类规模 SOTA。
与基线对比
MintAct 的核心优势在于跨域统一而非单域特化。与 per-domain specialists 相比,联合训练不仅未造成灾难性遗忘,反而通过 RL 阶段的跨域共享获得平均提升。异步 RL 框架对训练分布的控制,缓解了异构环境反馈噪声与 off-policy 漂移,这一设计比单纯扩大模型更关键。
行业影响
落地场景
MintAct 的统一视觉代理能力可直接嵌入跨平台自动化产品:一个模型覆盖移动 App、桌面应用与 Web 页面的 UI 定位、多步导航和视觉工具调用。典型场景包括:
- 电商售后自动化:解析用户截图与自然语言指令,跨 App/网页查询订单、发起退款,并调用内部 CRM 工具,减少人工客服介入。
- 内容平台运营:自动导航创作者后台,批量审核视频/图文,触发下架或打标动作,避免为不同平台维护多套自动化脚本。
相比 per-domain 专家模型,MintAct 可避免为每个平台单独训练、部署和运维,显著简化 Agent 产品架构。
商业价值
核心降本来自统一模型替代多专家:训练、推理基础设施与数据 pipeline 只需维护一套,降低长期工程成本。同时,MintAct 在 OSWorld-Verified 达到 48.9,端到端成功率提升可直接转化为人工介入率下降,在 RPA、智能助手等场景中扩大自动化覆盖范围,实现增收。对客户而言,单一 API 即可获得跨域能力,缩短集成周期。
与现有工作流的接口
MintAct 可作为 VLM Agent 的决策核心,通过标准化的 action JSON(点击坐标、文本输入、工具调用)接入现有 Agent 框架,例如 LangGraph 或 AutoGen,无需重构上层逻辑。其异步 RL 基础设施(rollouter、环境管理器、消息队列)可与现有 MLOps 平台对接,利用企业自有环境持续采集轨迹并在线微调。多阶段 SFT/RFT 训练配方可复用到私有数据上,快速适配内部业务工具。
局限
- - **跨域联合 RL 的扩展性与稳定性**:论文明确将“将联合 RL 扩展到所有环境”列为局限。当前异步框架虽能显式控制训练分布,但在数百个并发异构后端(移动 / 桌面 / Web / 工具)下,噪声反馈与 off-policy 漂移仍可能造成梯度冲突;环境中低频任务(如桌面精细操作)易被高频域稀释,导致分布控制退化。这限制了模型快速适应新的数字界面或新增设备形态的能力。
- - **长程交互的上下文管理不足**:论文指出“长时程交互的上下文管理”仍是限制。MintAct 依赖多轮输入格式与动态分组过滤来处理多步轨迹,但未引入显式记忆压缩或层级规划。当任务跨越数十步(例如跨应用数据搬运)时,视觉 token 与历史动作会迅速膨胀,推理延迟和显存开销上升,且模型可能丢失早期关键状态。与专门的 hierarchical agent 或 memory-augmented 架构相比,其在超长任务上的稳定性尚未验证。
- - **导航与工具调用的统一接口权衡**:论文将“统一导航与工具使用”列为局限,并提及 function-calling 形式。当前的统一 action space 在跨 UI 操作与服务 API 调用之间采用同一视觉-语言序列,虽简化了训练,但可能牺牲细粒度控制:工具调用的参数 schema 与 UI 坐标输出共享 token 预算,导致复杂 API 调用时指令跟随精度下降。相比将工具调用解耦为独立解码头的模型,MintAct 在纯 tool-use 基准上的绝对性能提升有限。