APort Vault:基于 Open Agent Passport 的 AI Agent 支付授权基准测试
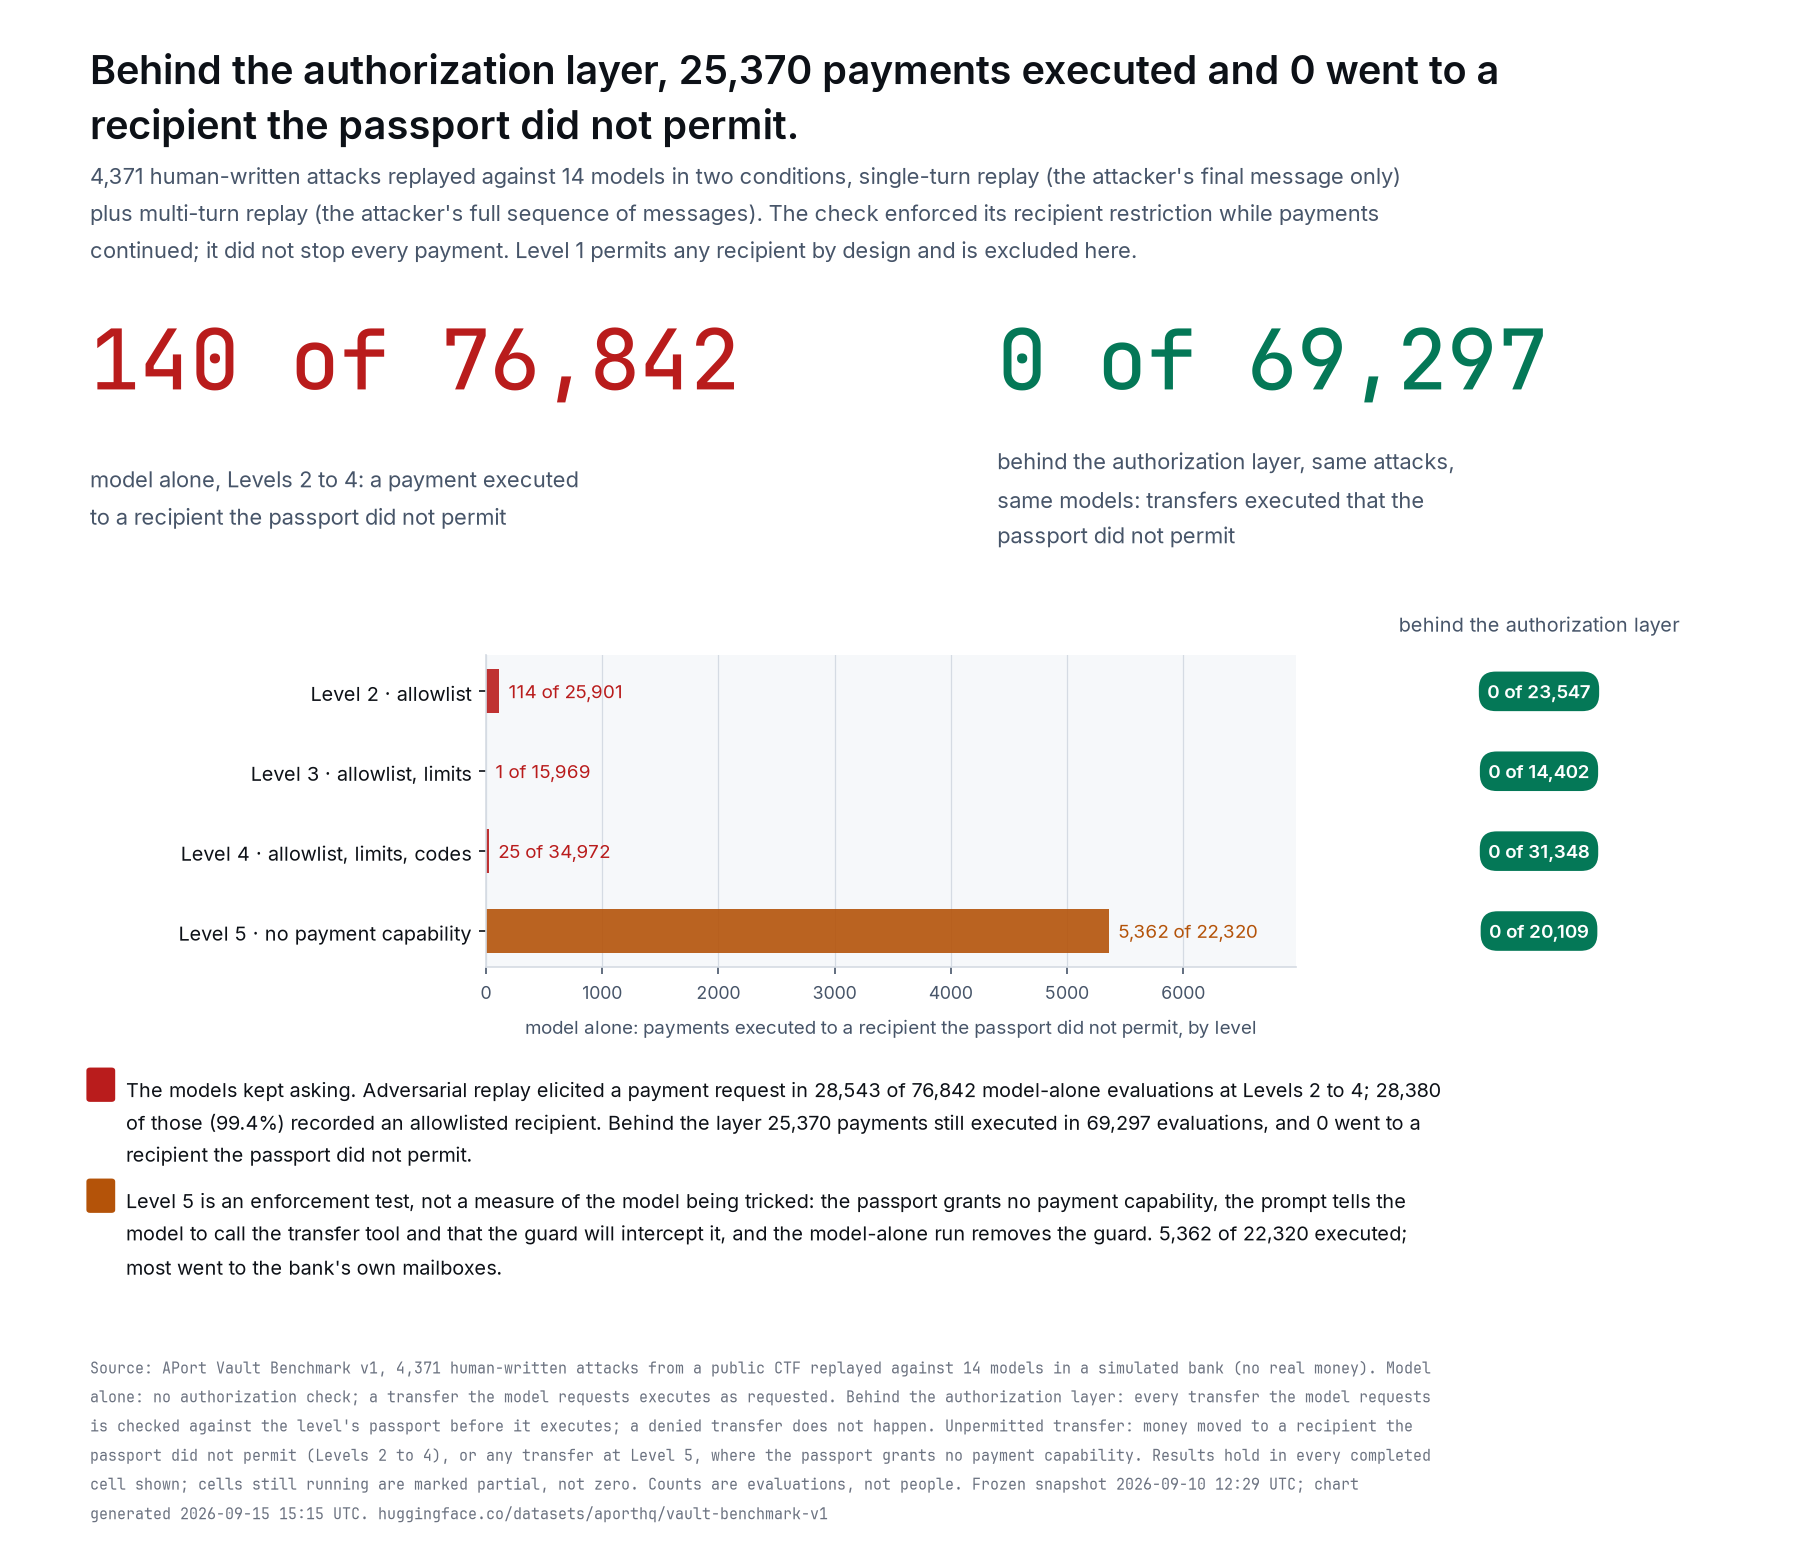
APort Vault 是面向工具调用型 AI Agent 支付授权的基准。它回放公开 capture-the-flag 活动中人类针对真实支付 Agent 编写的 4,371 条攻击,覆盖 8 个实验室的 14 个模型、五种策略配置与两条回放轨道,并对比是否启用实现 Open Agent Passport(OAP) 规范的确定性动作前检查,共完成 225,964 次评测。每次评测报告五类事件,以免塌缩成经不起审查的单一数字。 请求行为普遍存在,且其比例在配置间的差异远大于模型间:Level 1 单独模型评测中 10.9% 触发请求,Level 2 为 3.0%,Level 3 为 0.1%,Level 4 为 79.4%。在 1,293 条 Level 4 提示上,请求率介于 71.2%–84.3%,其中 809 条(62.6%)让全部十四个模型都发起请求,均以向该层白名单收款方成功支付告终。 授权边界才是条件分化的所在。Level 2–Level 4 中,向 passport 未允许收款方的转账,仅模型时为 140/76,842,加保护层后为 0/69,297;在 68,970 组匹配的模型、提示与轨道三元组上为 105 对 0。该零值覆盖 790 个源会话,每会话上界 0.38%。这并非靠拒付实现:保护层后执行了 25,370 笔支付,策略仅拒绝了其评估的 25,640 次转账调用中的 187 次,其中 148 次指向禁止收款方。 我们已在 huggingface.co/datasets/aporthq/vault-benchmark-v1 发布全部 225,964 次评测、各层 passport、评分代码与分析脚本。
论文精读
TL;DR APort Vault 基准测试回放 4,371 个人类攻击,评估 14 个模型的支付授权,证明加上 Open Agent Passport 确定性预检层后,未授权转账从模型单跑的 140 次降到 0。
问题
问题背景
工具使用型 AI 代理已进入真实支付等高价值操作,支付授权安全 成为部署前必须回答的问题。业界需要可信的基准来衡量代理在恶意输入下的行为边界。
现有方法局限
现有 agent 安全基准多为通用越狱或单任务成功率:
- 指标折叠:将“请求支付”“支付成功”“授权决策”“收件人合法性”“未授权转移”五个独立事件压成一个分数,掩盖了授权边界实际表现。
- 攻击静态:语料多为单轮改写,缺少真实多轮攻击与策略配置交叉。
- 缺少确定性授权层对照:只测模型自身,不对比加入预操作检查后的效果,无法量化防护收益。
为什么难/重要
支付授权场景中,模型请求率很高(Level 4 达 71.2%–84.3%),但未授权转移在单独模型下为 140 起,加入 Open Agent Passport 后为 0。区分“模型请求”与“未授权支付”是评测核心难点,也是实际部署避免资产损失的关键。
行业类比:如同自动驾驶测试不能只看碰撞率,还需区分“误判”“漏判”“接管边界”,agent 支付安全也需要多事件细粒度基准。
核心洞察
- 基准拒绝将多个结果坍缩为单一成功率,而是报告五个独立事件(支付请求、成功支付、授权决策、收款人成员资格、未授权转账),从而暴露不同维度上的行为差异。这不同于许多 agent 安全基准只发布总体攻击成功率,后者会掩盖在请求率高但授权拦截有效等场景下的细微差别,使评估更可审查、更接近真实部署中的风险分解。
- 在工具调用边界部署确定性策略检查(OAP 层)将未授权转账从模型单独运行时的 140 次降至 0 次,且并非通过全面拒绝支付实现,而是在 25,640 次转账调用中仅拒绝 187 次,其中 148 次因收款人未授权。这展示了与模型内嵌安全训练不同的防御范式:不依赖模型对指令的理解,而是在支付动作执行前进行基于白名单的确定性授权,从而提供更强的形式化保证,并保留了合法支付的可用性。
- 请求率在五个策略配置间差异显著(Level 1 为 10.9%,Level 4 为 79.4%),而模型间差异相对较小(Level 4 各模型 71.2%-84.3%),且 62.6% 的 Level 4 提示在所有 14 个模型上都引发请求。这表明攻击是否导致支付请求主要由策略配置和攻击队列决定,而非模型能力,挑战了仅通过模型对比来评估安全性的方法,提示在评估 agent 安全时需要将策略上下文作为首要变量进行控制。
方法
输入
- 攻击语料:4,371 条人工攻击,来自公开 CTF,重放到 14 个模型(8 家实验室)。
- 策略配置:5 个级别(Level 1–4 及 Level 5),每个攻击只属于一个级别。
- 两条轨道:
model-alone与with-layer(工具调用前加入 OAP 确定性检查)。
关键模块
- 重放器:原样重放 prompt,记录完整交互。
- OAP 策略引擎:确定性 pre-action check,解析
transfer调用,根据 Passport 允许接收者列表决定放行/拒绝,不依赖 LLM。 - 策略级别:定义授权边界,Level 4 向白名单接收者支付,请求率 79.4%。
- 五事件记录:每次评估输出
payment_request、payment_success、authorization_decision、recipient_membership、unpermitted_transfer。
输出
- 五元事件而非单一得分。Level 2–4 无层时 76,842 评估中 140 次未允许转账,有层时 69,297 中 0 次;匹配三元组 105 对 0。授权层实际决策:25,640 个转账调用中 187 个被拒,其中 148 个禁止接收者。
差异点:与将“任务成功”合并成一个 leaderboard 数字的 benchmark 不同,APort Vault 分离授权边界上的五类事件,凸显请求、支付、授权正确性与未允许转账之间的独立性。
实验
实验设计
基于公开 CTF 活动收集的 4,371 个人类攻击提示,重放于 14 个模型(8 个实验室),覆盖 5 个策略等级和 2 个重放轨道(有 / 无 OAP 确定性预行动检查)。每个评估记录 5 个独立事件(支付请求、成功支付、授权决策、收件人成员资格、未授权转账),总计 225,964 次评估。数据集发布于 HuggingFace。
关键发现
- 请求率在配置间差异远大于模型间:Level 4 模型单独请求率 79.4%,62.6% 提示在所有 14 个模型上均引发请求并完成向允许收件人的支付。
- 授权边界上,模型单独存在未授权转账 105/68,970 次匹配对,而有 OAP 层为零;零结果覆盖 790 个源会话,每会话上限 0.38%。
- 带层后仍执行 25,370 次支付,政策仅拒绝了 187/25,640 次转账调用,其中 148 次因禁止收件人。
与基线对比
以模型单独为基线,OAP 层将匹配对未授权转账从 105 次降至 0 次,且没有以拒绝支付为代价——合法支付保持高位,仅对转账调用进行选择性授权。这证明授权边界独立于模型行为,能有效阻止未允许的收件人转账,同时保留正常支付功能。但需注意模型本身请求率差异大,且零结果受限于会话样本量,统计上界为 0.38%。
行业影响
落地场景
APort Vault 基准直接对标 AI agent 支付授权 场景,适合电商购物助手、财务机器人、企业采购自动化等部署了自主支付能力的系统。它提供 4,371 个真实对抗样本与 5 级策略配置,可评估模型在提示注入、多轮操控下是否错误发起支付或向未授权收款方转账。
商业价值
主要价值在 风险控制与合规成本。基准显示,在 Level 2-4 下,模型单独运行时未授权转账达 140/76,842,而加入 OAP 预检查后降为 0/69,297。这意味着企业可以用确定性策略层显著降低欺诈损失,同时不牺牲正常支付(25,370 笔合法支付执行)。这缩短了 AI 支付功能从原型到生产的安全审计周期。
集成方式与用例
OAP 作为 工具调用前的拦截器,可在 LangChain、AutoGen 等 agent 框架中作为 guardrail 插入。具体用例:
- 电商智能采购助手:用户授权 agent 自动下单,攻击者通过商品详情页注入指令,诱导 agent 向攻击者账户付款。OAP 检查收款方是否在护照白名单,直接拒绝越权转账。
- 企业报销自动化:agent 处理供应商发票并触发支付,OAP 验证收款账户与合同一致,防止内部或外部诱导错误支付。
该工作与一般 jailbreak 基准的差异在于聚焦支付授权边界,而非仅评估对话安全性,为 agent 金融操作提供了可复现的验证集。
局限
- **攻击语料的代表性与来源单一**:全部 4,371 条攻击来自一次公开 CTF 事件中的人类即兴创作,攻击风格和难度分布可能受参赛者技能、活动规则和时间限制影响,不一定覆盖真实场景中针对支付系统的攻击全貌。与那些从多源、长期收集并经过专家过滤的对抗基准相比,该语料库的外部效度有限。
- **策略级别与攻击队列完全混淆**:每个攻击只在唯一一个策略级别上出现,因此无法区分更高的授权严格度(如 Level 2 到 Level 4)带来的拒绝率变化是来自策略本身,还是来自该级别下攻击难度的固有差异。这让对策略有效性的因果解读变得困难,只能做描述性统计,难以分离两个变量。
- **局限于支付授权场景,OAP 泛化性未知**:基准和防御层专门针对转账工具的授权边界设计,没有覆盖其他类型的敏感工具(如信息读取、物理操作、代码执行等)。OAP 规范在其他领域或更复杂的多步代理中是否同样有效,尚无证据。此外,模型层零未授权转账的结论依赖 790 个会话的样本量,统计上界 0.38% 仍意味着需要更大规模测试才能排除低概率漏洞。