Gricea: 面向对话式 AI 研究的开放科学平台
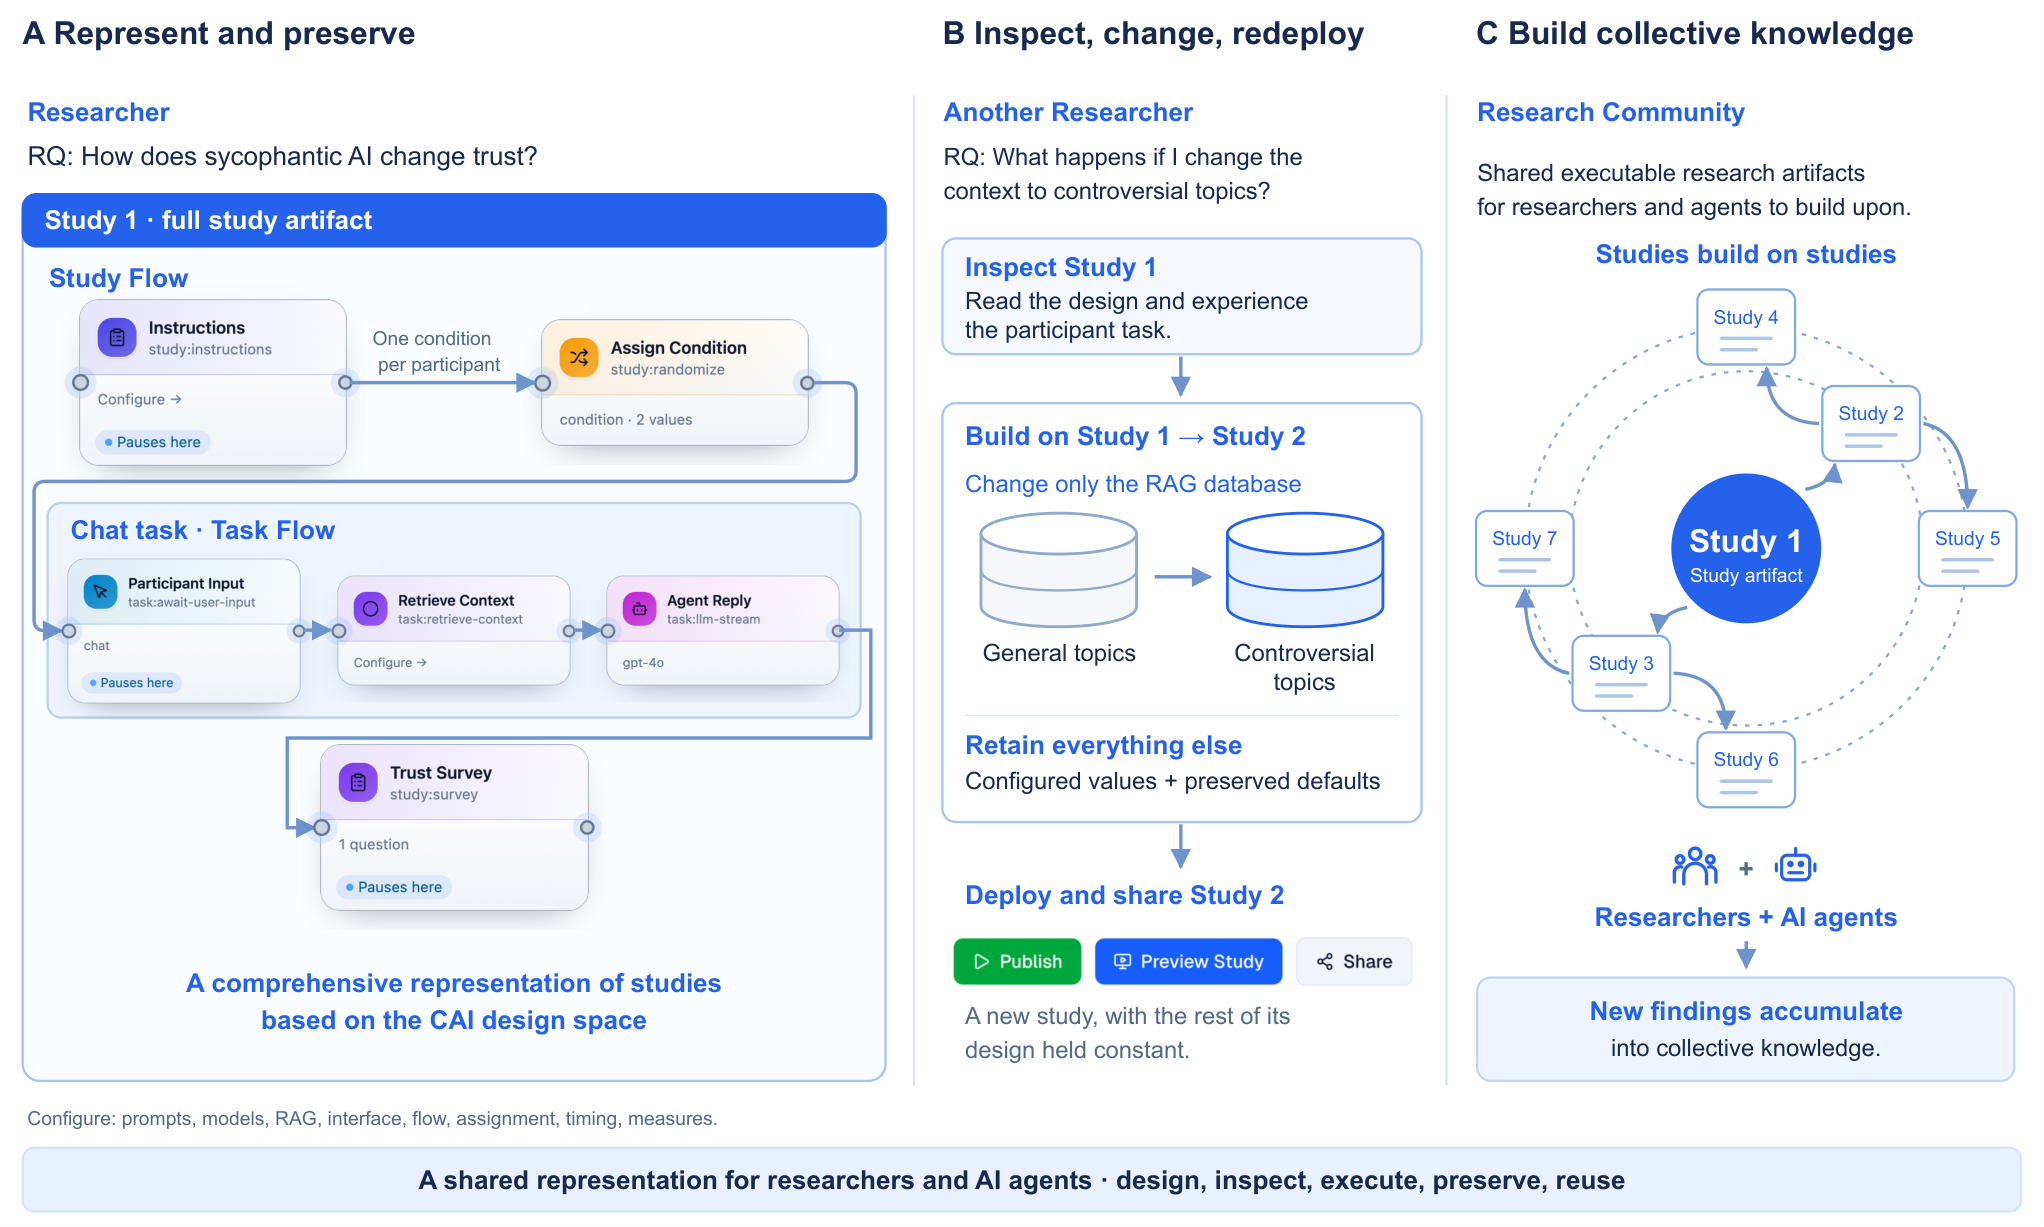
我们亟需大规模的对话式 AI (CAI) 研究,以理解人类行为并指导 CAI 设计。然而,系统与研究配置的碎片化报告阻碍了复现、扩展与知识积累。 我们提出 Gricea,一个开放科学平台,将研究表示为可配置、可部署的研究工件,研究人员可以运行、审查、共享和复用。基于对既有 CAI 研究的形成性分析,Gricea 将研究流程、面向参与者的系统与对话任务行为耦合在同一载体中。 - 在复现研究中,我们使用 Gricea 复现了 93% 符合条件的 CUI 2026 论文配置,同时在 96% 的论文中标记出阻碍忠实复现的缺失信息。 - 在用户研究中,来自不同背景的研究人员与从业者成功构建了可运行的研究,回应各类开放式研究问题。 这些发现共同表明,Gricea 通过共享研究工件支持 CAI 研究的构建、复现与扩展,以开放科学推动累积性知识构建。
论文精读
TL;DR Gricea 是一个开放科学平台,将对话 AI 研究表示为可配置、可部署的研究工件,支持复制与复用;在复制 CUI 2026 论文时成功复现 93% 的配置,同时发现 96% 论文存在关键信息缺失,凸显可重现性瓶颈。
问题
对话式 AI(Conversational AI, CAI)研究正从单次小规模实验转向大规模、可复现的系统性研究,以理解人类与对话系统交互行为并指导设计。但当前缺乏统一平台支持跨研究比较。
以往 CAI 研究报告对系统配置、研究流程和对话任务行为的描述高度碎片化,研究者难以准确重建实验。论文作者的复现研究显示:在符合条件的 CUI 2026 论文中,93% 的配置可被部分复现,但 96% 的论文缺少关键信息(如系统架构、对话状态机、参与者指令) 导致无法忠实复现原始行为;即使有代码发布,也因缺少统一的研究工件表示而难以跨研究复用或扩展,形成大量“一次性”实验代码。
CAI 研究本质上是多维配置空间的操控实验,涉及对话策略、交互模态、实验流程和参与者行为等高度耦合变量。同时,研究流程往往包含随机分支、实时干预或条件提示,传统问卷式在线实验平台或通用众包平台难以表达此类动态逻辑,而从头开发定制系统成本高昂且易产生不可复现的“一次性”代码。开放科学趋势下,AI 领域对可复现性的要求日益提高,CAI 社区需要一种既能降低技术门槛、又能保证设计-实现保真度的基础设施。
这类似于 MLOps 中的实验追踪与模型版本管理——没有统一的配置与工件记录,模型训练结果就难以可靠复现;CAI 研究同样需要“研究流程即代码”的标准化工件来支撑累积科学。
核心洞察
- 将对话 AI 研究视为可配置的研究工件:Gricea 通过 **Study Flow** 和 **Task Flow** 抽象,把研究程序、参与者界面与对话任务行为统一建模为可执行配置。与传统仅共享代码或数据不同,它共享的是完整研究配置,使实验的每个环节可检查、可复制、可扩展。对于工程实践,这提示 AI 系统评估应采用可执行规范而非自然语言报告,从源头减少信息丢失。
- 实证揭示对话 AI 研究的报告鸿沟:复制 **CUI 2026** 论文时,96% 的论文缺失关键信息导致无法完全复制,即便使用 Gricea 也只能复制 93% 的配置。这一发现将开放科学问题从理念落到具体环节,说明当前研究知识积累受阻的关键在于缺乏结构化报告标准。Gricea 通过强制配置和部署流程,倒逼研究者提供完整信息,为降低复制成本提供了可落地的平台路径。
方法
输入
Gricea 接收研究者通过可视化编写环境(Researcher Authoring Environment)定义的研究配置,包括三个核心抽象:
- Study Flow:描述整个研究的流程(如知情同意、任务介绍、问卷、结束语)。
- Task Flow:描述单次对话任务中的交互步骤与状态机。
- Logic and Condition Control:提供分支、随机化、条件判断,将研究过程与对话任务行为耦合。
关键模块
- 可视化编写环境:低代码/无代码界面,支持研究者配置上述抽象,降低技术门槛。
- 参与者运行时与 instrumentation:部署参与者端系统,自动记录交互数据、研究流程事件、对话行为与系统响应。
- 发布、复用与社区工作流:将研究配置作为可运行 artifact 发布、版本管理、共享与复用。
- 架构与可扩展性:模块化设计,便于接入外部对话系统或扩展新的任务类型。
输出
Gricea 生成可运行、可检查、可复用的研究 artifact;在复制实验中,它复现了 93% 的 eligible CUI 2026 论文配置,同时标记出 96% 论文中阻碍忠实复制的信息缺失。用户研究显示不同背景的研究者能构建可运行的研究。
与 oTree、Qualtrics 等通用在线实验平台不同,Gricea 将研究流程、参与者系统与对话任务行为统一在一个可配置 artifact 中,专为对话式 AI 研究设计,支持设计到实现的保真度检查。
实验
实验设计
Gricea 的评估包括两项实验:
- 复制研究:从 CUI 2026 论文集中选取符合条件的研究,尝试用 Gricea 重新配置并运行其研究流程,以检验平台对已发表工作的可复现性。
- 用户研究:招募来自不同背景的研究者与从业者,要求他们使用 Gricea 构建可运行的研究方案,解决各自提出的开放性问题。
关键发现
- 复制研究中,Gricea 成功复现了 93% 的合格论文配置,但同时也暴露出 96% 的论文存在信息缺失,阻碍了忠实复制。
- 用户研究中,参与者成功构建了覆盖对话 AI 设计空间多个维度的可运行研究,并克服了原型制作与复现的瓶颈。不过,高自由度设计仍需要额外的脚手架支持(例如逻辑控制模板)。
与基线的对比解读
与传统依赖论文描述、代码仓库或单一数据集的开放科学实践相比,Gricea 将研究程序、参与界面与任务行为耦合为可部署的 artifact,显著降低了从论文到运行实验的转换成本。复制实验中的 93% 成功率暗示平台能吸收大部分常规配置,而 96% 的信息缺口则说明传统报告习惯远不能满足可复现需求。用户研究进一步表明,即使非专业编程背景的研究者也能通过配置而非编码完成实验搭建,这比现有需要手动集成多个组件的工具链更具扩展性。综合来看,Gricea 的共享研究表示有望成为对话 AI 领域累积知识的基础设施。
行业影响
落地场景
对话式 AI 产品团队(客服机器人、语音助手、电商导购、教育辅导等)频繁进行用户研究、A/B 测试和多臂老虎机实验,但当前实验配置分散,复现困难。Gricea 的平台化思路可统一管理 Study Flow、Task Flow 和逻辑条件,将实验配置、部署和度量一体化,尤其适合多轮对话策略对比。
商业价值
降本增效:减少每个实验的定制开发量,缩短从假设到结论的周期;知识积累:通过可复制的 研究工件 避免重复试错;体验提升:严谨的对照实验优化对话策略,提高用户满意度和转化率。对于 LLM 驱动的对话应用,快速实验迭代直接转化为产品竞争力。
与现有工作流的接口
可将 Gricea 的核心抽象映射到现有实验与部署工具:
- 配置管理:与 GitHub / GitLab 集成,版本化研究配置;
- 对话系统接入:通过 API 连接到 OpenAI、Rasa 或自建服务;
- 日志与指标:输出到 BigQuery / Snowflake,对接现有 A/B 测试分析栈;
- 任务编排:用 Airflow / Kubeflow 触发部署和回收。
具体 use case:电商平台的对话式购物助手中,用 Gricea 配置一个比较“直接推荐” vs “提问澄清”两种话术的随机对照实验,自动部署到线上流量,收集对话与转化数据,实验结束后生成可共享的报告。另一个场景是教育对话辅导系统,研究者快速搭建实验测试不同反馈风格对学生学习效果的影响,保留完整配置供同行审核与重复。
局限
- Gricea 仍依赖外部服务(如 LLM API、众包平台),这些依赖可能引入不确定性和可复制性风险。论文在 6.2 节明确提到 “Gricea External Dependencies and Scope Boundaries”,说明平台无法完全封装所有外部组件,导致部分研究配置需要手动干预,且第三方服务的变更或弃用可能破坏已发布研究的可复现性。这限制了 Gricea 作为完全自包含开放科学平台的能力。
- 用户研究样本规模有限,且主要依赖定性反馈。从附录 A.1 Participant Details 推断,参与者数量可能不足以支持统计显著性检验;同时,评估仅针对 CUI 2026 一个会议论文集进行复制研究,结论的普适性有待验证。此外,用户研究中的任务完成度与体验度量可能缺乏标准化的定量指标,难以客观比较平台与传统方法的效率差异。
- 平台在提供高自由度配置的同时,也给非技术背景研究者带来了较高的学习曲线。6.6.4 节指出 “High Degrees of Freedom and the Need for additional scaffolding” 表明,当前抽象层次仍然偏技术化,需要额外的引导或模板支持。与现有低代码或可视化编程工具相比,Gricea 可能需要更多的方法论脚手架,否则新手用户容易迷失在大量配置选项中,降低实际采用率。