BI-Agent 与 BI-Bench:迈向端到端商业智能自动化
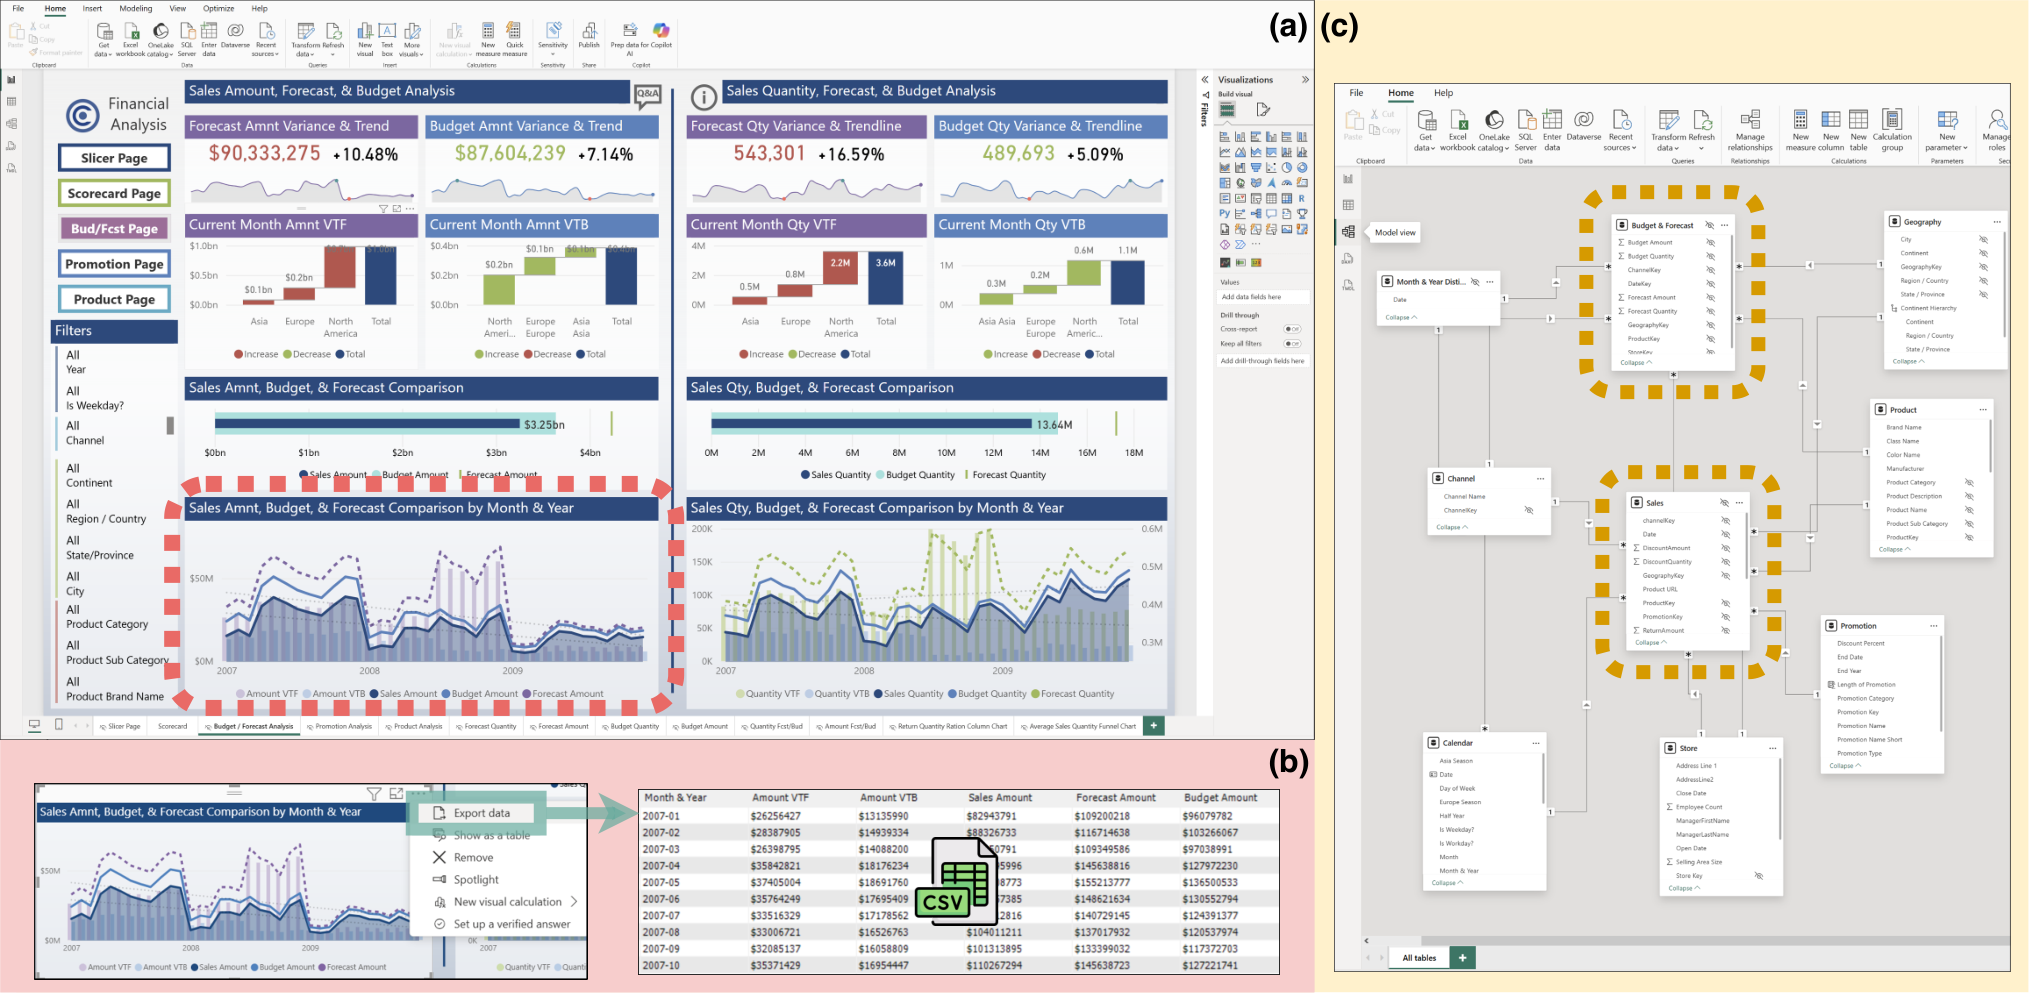
商业智能(BI) 是企业决策的基石,在 Power BI、Tableau 等软件中被企业用户广泛使用。传统 BI 流程要求用户先准备数据:1. 识别相关表;2. 执行数据转换;3. 建立连接关系,之后才能 (4) 回答业务问题。这些步骤复杂且耗时,使 BI 颇具挑战。 鉴于大语言模型(LLM)在数据任务上的强大能力,本文研究 LLM 的端到端 BI 能力,使用户无需手动完成冗长的准备工作。作者从公开来源收集了大量真实 BI 项目,并从真实用户仪表盘中人工抽取 (问题, 真值答案) 对,构建了 BI-Bench —— 首个系统评估 LLM 端到端 BI 能力的基准。实验发现,即使是前沿 LLM 在 BI-Bench 上表现也不佳,准确率不足 50%。 为弥补上述不足,作者设计了工具增强的 BI-Agent,将 BI 工作流分解为结构化数据上的子任务(如 search、join、transform),并在各 BI 阶段编排专用数据管理方法。此外还提出后训练框架,从真实 BI 项目合成训练轨迹,使 BI-Agent 可通过监督微调(SFT) 与强化学习(RL) 进一步训练。 结果显示,BI-Agent 在原始 LLM 上取得最多 40 个百分点 的准确率提升,后训练后的 BI-Agent 再提升最多 30 点。这凸显了在复杂 BI 工作流中结合工具增强推理与领域特定后训练的重要性,并为未来研究指明了方向。
论文精读
TL;DR 该论文发布首个端到端 BI 基准 BI-Bench,揭示前沿 LLM 准确率不足 50%;提出的工具增强 BI-Agent 通过分解搜索、联接、转换等子任务并结合 SFT/RL 后训练,准确率最高提升 40 个百分点。
问题
问题背景
企业级 BI(Business Intelligence)是决策分析的核心,但传统工作流要求用户手动完成数据发现、数据转换、表连接等步骤,再回答业务问题。随着 LLM 在数据处理上的能力提升,业界开始探索能否端到端自动化 BI。
现有方法局限
当前 LLM 相关评测多聚焦 Text-to-SQL 单一任务,通常基于已清洗的数据库 schema,假设表结构已知且数据可直接查询。但真实 BI 场景中:
- 数据分散在多个表中,需先识别相关表;
- 原始数据通常需要转换(如类型转换、聚合、透视);
- 表之间缺乏预定义 join 关系,需要推断。 这些前置步骤的缺失,使得现有基准无法评估完整 BI 流程。传统 BI 工具(如 Power BI)则依赖大量人工准备,自动化程度低。
为什么这个问题难且重要
端到端 BI 是一个多阶段推理问题,需要 LLM 在结构化数据上执行搜索、连接、转换等操作,并调用工具。错误会在各阶段累积,尤其数据发现和转换的复杂度远高于 SQL 生成。同时,真实企业数据规模大、schema 混乱,增加了规划难度。业界对此需求强烈,因为 BI 用户群体远大于数据库专家,自动化能显著降低门槛。
行业类比
这类似于自动驾驶从辅助驾驶迈向完全无人驾驶:不仅需要“最后一步”的决策生成,还需完成感知、路径规划和底层操作的一体化协同。
核心洞察
- - 工具增强推理是解决端到端 BI 中多表数据准备挑战的关键:BI-Agent 将任务显式分解为 search、join、transform 等结构化子任务,并编排专用数据管理方法,区别于传统 Text2SQL 仅生成单表 SQL 的简化假设。真实 BI 工作流需跨表关联与变换,普通 LLM 容易遗漏步骤,agent 通过工具调用强制模型按阶段规划,显著提升准确性。
- - 从真实 BI 项目合成训练轨迹进行领域后训练是另一核心洞察:论文不依赖人工标注,而是利用真实 dashboard 中的业务问题与答案生成 **SFT** 与 **RL** 轨迹,使 BI-Agent 学会专家式工作流。在 **BI-Bench** 上,vanilla LLM 准确率不足 50%,post-trained BI-Agent 再提升最多 30 个百分点,证明后训练与工具推理互补,而非简单 prompt engineering 可比。
方法
输入:用户自然语言 BI 问题 + 企业多表数据集(原始表结构未准备,可能缺少显式 join、存在脏数据)。
关键模块:
任务分解与工具调用循环:BI-Agent 将端到端 BI 工作流分解为 search(识别相关表)、transform(数据清洗与变换)、join(构建关系)等子任务,每个子任务映射到数据管理工具。LLM 作为规划器,根据当前状态选择工具并观察结果,迭代执行直到生成最终答案。
专用数据管理工具集:针对结构化数据的子任务提供确定性方法,例如 schema 检索、自动连接推断、数据析取与聚合,避免纯 LLM 生成 SQL 的不可靠性。
后训练框架:从真实 BI 项目(dashboard 及其底层数据)合成训练轨迹,将端到端 BI 问题与正确的工具调用序列对齐。先用 SFT 学习基础策略,再用 RL 根据执行结果(如最终答案正确性、资源成本)优化策略。
输出:面向用户问题的直接答案(数值结论或图表描述),以及可复现的 BI 流程(表的选择、转换与连接步骤)。
与同类方法差异:相比仅处理单表 Text-to-SQL 或预设 schema 的问答系统,BI-Agent 首次在未准备的多表数据上联合解决 search / join / transform,并引入真实项目驱动的 SFT + RL 后训练,显著提升端到端准确率。
实验
实验设计
评估基于 BI-Bench,一个从公开真实 BI 项目构建的端到端基准,包含手动提取的 (问题, 答案) 对。基线为前沿 LLM 直接在原始数据上回答,BI-Agent 则通过工具增强的推理循环,分解为搜索、连接、转换等子任务。后训练框架从真实 BI 项目合成轨迹,采用 SFT 和 RL 微调 BI-Agent。
关键发现
- 前沿 LLM 在 BI-Bench 上准确率 不足 50%。
- 使用工具增强的 BI-Agent 带来最高 +40 个百分点 的准确率提升。
- 经 post-training(SFT+RL)的 BI-Agent 再提升最高 +30 个百分点,且统计显著。
- 成本与延迟分析显示 BI-Agent 具有额外优势。
与基线对比解读
单纯依赖 LLM 推理难以处理端到端 BI 所需的复杂数据操作;BI-Agent 通过将工作流分解为结构化数据上的子任务并调用专业数据管理工具,显著弥补了通用 LLM 的不足。进一步的后训练使模型学会在真实 BI 环境中规划工具调用,表明 工具增强推理 与 领域特定 post-training 是互补且必要的。该结果对复杂数据工作流的 LLM 应用具有工程启示:应将系统设计与数据管理技术深度结合,而非仅依赖模型能力。
行业影响
落地场景
BI-Agent 可嵌入企业 BI 工具(如 Power BI、Tableau)或作为独立问答服务,面向电商、金融、内容平台等数据密集型业务。用户直接以自然语言提问,系统自动完成表搜索、join、转化与答案生成,省去手动准备数据。
- 电商:分析师询问“高价值用户上季度的复购率变化”,自动整合订单、用户、商品多表,输出带计算的图表。
- 金融:风控人员查询“某区域贷款逾期率趋势”,自动处理多源数据,生成报表。
商业价值
核心是降本增效:减少数据分析师在数据准备上的重复劳动,将数小时/数天的工作缩短到分钟级;同时缩短决策周期,使业务人员能自助获取洞察,提升运营效率。对于企业服务厂商,可作为增值功能提升产品竞争力,增加订阅收入。
与现有产品 / 工作流的接口
BI-Agent 以 API 或微服务形式集成,接收问题并返回答案与执行轨迹。可对接数据仓库(Snowflake、Databricks)、元数据管理系统和语义层。其 post-training 框架支持在企业私有数据上微调,适配特定 schema 和业务术语。后续可进一步与 Copilot 类产品结合,提供交互式分析体验。
局限
- **BI-Bench** 的构建存在潜在偏差与规模限制。数据集从公开来源收集真实 BI 项目,并人工提取问题-答案对,这意味着样本的领域分布、复杂度水平和业务类型受限于作者筛选,可能导致基准代表性不足。人工提取过程耗时且易引入主观判断误差,例如对正确答案的界定可能不一致。此外,基准的更新频率、覆盖范围和可复现性尚未明确,作为端到端 BI 评估标准还需要更严格的验证。
- **BI-Agent** 的方法泛化性与实验设计存在局限。方法依赖预定义的子任务分解(搜索、连接、转换)和专用工具集,在面对新的数据类型(如非结构化文本、流数据)或更复杂的 BI 操作(如多源语义集成、预测建模)时,可能需要大量额外适配。实验主要在自建的 BI-Bench 上进行,缺乏在更广泛的企业真实数据上的交叉验证,且后训练框架依赖真实 BI 项目来合成轨迹,实际部署中高质量训练数据的获取可能成为瓶颈。
- 与现有工作的对比不够充分。虽然本文贡献了首个端到端 BI benchmark,但缺少与主流工具(如 Power BI 内置问答、Tableau Ask Data)和近期 table-based agent(如 TableGPT、DIN-SQL)在同一基准上的系统比较,难以量化方法中工具增强推理和后训练各自的真实增益。此外,成本与延迟分析不够详细,在企业级场景下,多轮工具调用和 LLM 推理的开销可能不可忽略,影响实际可行性。