SoL-Pi:递归扩展自动研究循环以实现高效 Agent Harness
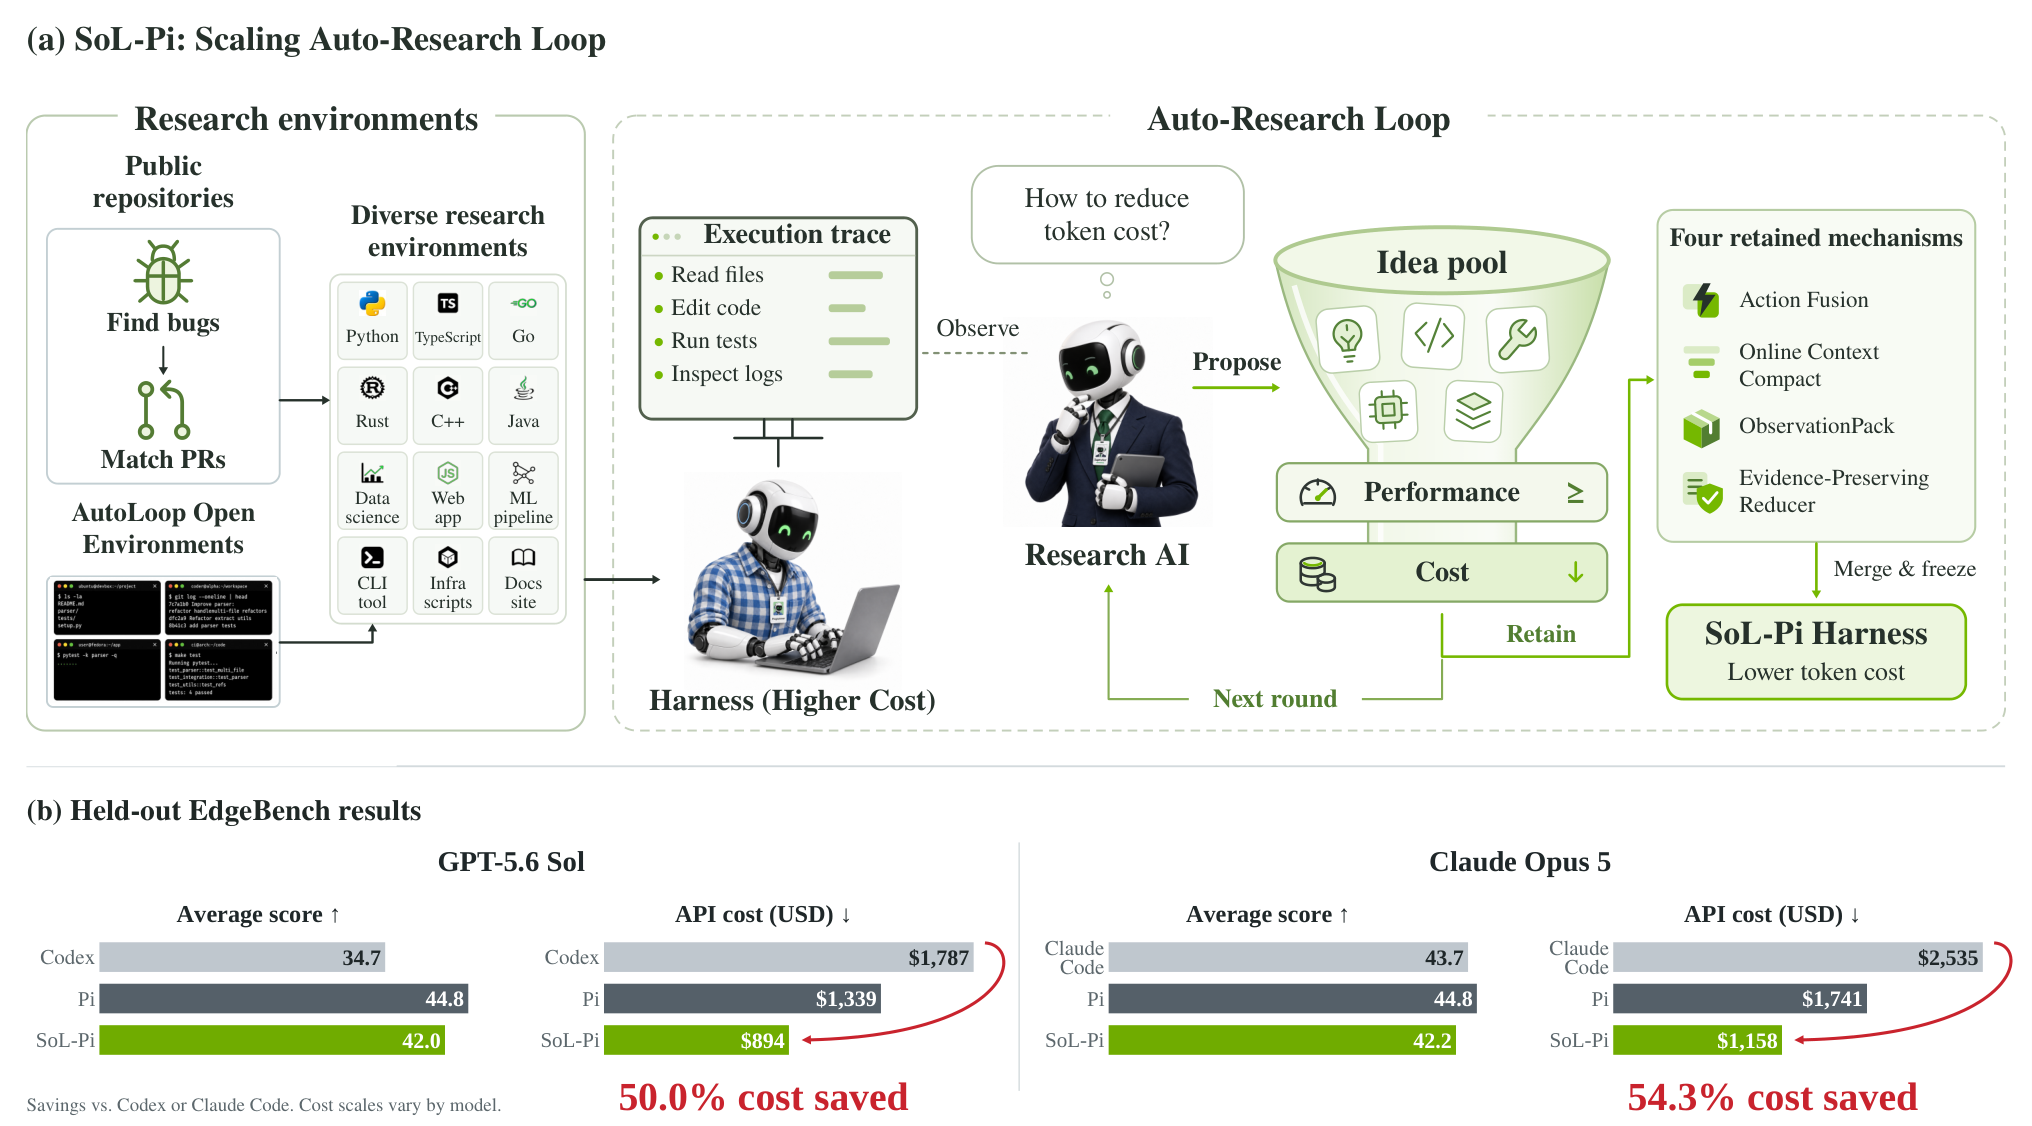
编码 Agent 正从有监督的代码补全转向无人值守、全天候的探索,其工作也从孤立的预测扩展为包含推理、工具调用与反馈的长轨迹。因此,在递归自我改进的规模化过程中,Token 效率 变得至关重要。 我们在 harness 层采用受 RSI 启发的思路,在数量与多样性不断增长的环境中扩展 auto-research loops,以进行 harness rollout。在这一规模下,该过程能产出可复用的改进,并可迁移到开发环境之外,推动自动 harness 发现走向生产级成果。 最终有四种机制通过筛选并构成 SoL-Pi,涵盖动作执行、上下文压缩、观测处理与委托阅读。 在包含 51 项任务 的 EdgeBench 评测中,SoL-Pi 在 GPT-5.6 Sol 与 Opus 5 上取得与 Pi 相当的性能,同时将记录的 token 流量降低 44.7-49.0%,API 成本降低约三分之一。换言之,相对原生 Codex 与 Claude Code harness,预计每小时可节省 \8.75-13.50;相对 Pi 则节省 \4.36-5.71。
论文精读
TL;DR SoL-Pi 通过递归扩展自动研究循环,在 harness 层发现 Action Fusion 等四种机制,性能对齐 Pi 同时 token 流量降低 44.7–49.0%、API 成本降低约三分之一。
问题
问题背景
编码智能体正从受监督的代码补全转向无人值守、全天候探索,其工作负载演变为推理、工具调用和反馈的长轨迹。Token 效率 因此成为扩展递归自我改进(RSI)的第一序系统约束。
现有方法局限
现有高效方案多聚焦模型层或特定任务的手工调优,存在以下技术瓶颈:
- 手工设计 harness 机制 依赖专家经验,难以覆盖动作执行、上下文压缩、观察处理等多样维度,跨环境泛化性差。
- 上下文压缩方法 常丢弃关键观察信息或证据链,在长轨迹任务中影响最终成功率。
- 自动化搜索 通常在单一或少量环境上 rollout,发现的机制容易过拟合开发场景,迁移到生产级任务时收益明显衰减。
SoL-Pi 通过大规模多环境 harness auto-research 筛选出可复用机制,在 EdgeBench 51 任务 上相对 Pi 将 token 流量降低 44.7–49.0%,API 成本降低约三分之一,证明从开发环境迁移到生产级结果是可行的。
为什么这个问题难/重要
- 搜索空间大:harness 层涉及动作融合、在线上下文压缩、观察打包、证据保留等多个正交维度,组合爆炸使穷举不可行。
- 评估成本高:需要大量环境 rollout 才能区分长期收益与随机噪声,可扩展的搜索基础设施本身是工程挑战。
- 业界关注度:自主研究、软件工程智能体的经济性直接决定能否 24/7 运行;节省 30% 以上 API 成本意味着显著的运营优化空间。
行业类比
类似自动驾驶公司在仿真中累积数百万英里里程来发现通用驾驶策略,而非针对单一路口手工编写规则;SoL-Pi 在数千个代码环境 rollout 中自动筛选 token 高效的 harness 机制。
核心洞察
- SoL-Pi 将递归自我改进(RSI)从模型参数转移到 agent 的 harness 层,通过自动化搜索在多样环境中筛选 token 高效机制。与常见的 prompt 压缩或模型量化不同,它不改变底层模型,而是优化 agent 与工具、上下文的交互流程。这证明 harness 层存在大量未开发的效率空间,且发现机制可跨环境迁移,降低了 RSI 对模型能力提升的依赖,为 scaling 自主研究循环提供了新杠杆。
- SoL-Pi 采用“broad-to-deep”搜索策略,从仓库和验证器驱动环境中筛选出四个机制:Action Fusion、Online Context Compact、ObservationPack、Evidence-Preserving Reducer,分别针对动作执行、上下文压缩、观察处理和委托阅读。在 EdgeBench 51 任务上,这些机制实现与 Pi 相当的性能,同时减少 44.7–49.0% token 流量和约三分之一 API 成本,表明 harness 自动化设计可以产出生产级组件,而非仅限实验室演示。
方法
输入与搜索流程
SoL-Pi 将 长程 agent 轨迹(推理、工具调用、环境反馈)作为输入,在 harness 层 执行 RSI 风格的自动研究循环:从仓库派生环境和验证器驱动环境中采样大量 rollouts,通过 broad-to-deep harness search 从广泛候选机制中逐步筛选。
关键模块(四个机制)
- Action Fusion:合并可合并的动作调用,减少冗余执行步骤。
- Online Context Compact:在线压缩上下文,保留必要信息同时降低 prompt token。
- ObservationPack:将多路观察结果打包成紧凑结构,避免重复展开。
- Evidence-Preserving Reducer:在委托读取长输出时,保留证据链的缩减器,防止信息丢失。
这些机制直接嵌入 agent 与 LLM 后端之间的 harness 层,不改动模型权重或推理算法本身。
输出
输出为 token 高效的执行轨迹。在 EdgeBench 51 任务上,相对 Pi 在 GPT-5.6 Sol 和 Opus 5 上性能相当,token 流量下降 44.7–49.0%,API 成本降低约 1/3。
与同类自动 agent 设计工作的差异:SoL-Pi 将搜索对象从 prompt 或模型参数转移到可复用的 harness 机制,并通过多环境规模化搜索获得跨设置迁移能力。
实验
实验设计与关键结果
- 评估任务:在 EdgeBench 51 任务上对比 SoL-Pi 与 Pi 以及原生 Codex、Claude Code harnesses,使用 GPT-5.6 Sol 和 Opus 5 模型。
- 扩展评估:在 Terminal-Bench 4 和 IMO 2026 上验证跨环境泛化,并分析多智能体 swarm 效率与 backend 缓存行为。
SoL-Pi 在保持与 Pi 相当性能的同时,将记录 token 流量降低 44.7–49.0%,API 成本降低约 1/3。相对原生 harnesses 每小时节省 $8.75–$13.50,相对 Pi 节省 $4.36–$5.71。
关键发现
- 四个经选择存活的机制(Action Fusion、Online Context Compact、ObservationPack、Evidence-Preserving Reducer)覆盖动作执行、上下文压缩、观测处理与委托阅读,是 token 效率提升的来源。
- 在跨环境(Terminal-Bench 4、IMO 2026)上的表现显示这些机制具备可迁移性,从开发环境走向生产级结果。
与基线的深度对比
- 对比 Pi:SoL-Pi 在保持任务成功率可比的同时,大幅度削减 token 与成本,说明 harness 层的自动化搜索能发现 Pi 未覆盖的高效路径。
- 对比原生 Codex/Claude Code:节省金额更高($8.75–$13.50 vs $4.36–$5.71),表明通用 harness 存在大量冗余,SoL-Pi 的机制可显著压缩观测与动作流。
- 性能 comparable 是关键前提:不牺牲准确性,纯效率收益,对实际部署(尤其长时间 unattended 运行)具有直接工程价值。
行业影响
落地场景
SoL-Pi 面向长时程自主代理的 harness 层优化,可嵌入各类需要持续运行、反复调用工具的编码智能体或研究智能体。典型产品形态包括自动代码补全后的无人值守开发代理、CI/CD 中的自动修复 bot、以及基于多步推理的自主研究循环。在电商领域,商品信息自动更新与价格监控 agent 需要高频调用搜索 / 爬虫 / 数据库,SoL-Pi 的 ObservationPack 与 Action Fusion 能大幅减少观测和动作 token;在金融领域,自动研报生成 agent 需读取大量文档,Evidence-Preserving Reducer 可压缩长上下文而不丢失关键证据。
商业价值
核心价值在降本与扩展性:实验显示 token 流量降低 44.7–49.0%,API 成本约降 1/3,意味着在同等预算下可支持的代理运行时长提升约 50%。对于按 token 计费的商业 agent 服务,直接改善毛利;对于希望运行大规模 agent swarm 的企业,可显著降低基础设施支出。同时性能保持与 Pi 相当,不会因压缩而损失任务完成率。
与现有产品 / 工作流的接口
SoL-Pi 位于 harness 层,不改变底层模型权重,因此可以轻量集成到现有 agent 框架(如 LangChain、AutoGen、自定义 harness)中。四个机制可独立启用,团队可先在最耗 token 的环节试点。项目已开源(GitHub),并提供与 Codex、Claude Code 等后端的对接;对于使用 OpenAI / Anthropic API 的现有系统,只需在请求构造和响应处理处替换为 SoL-Pi 的压缩逻辑,无需重写业务代码。
具体落地 Use Case
- 电商商品全自动巡检 agent:每日遍历百万级 SKU,调用搜索、比对接口,SoL-Pi 将动作与观测压缩,单日 API 费用从数千美元降到数百美元,且可 7×24 运行。
- 金融研报自动生成 agent:长时间阅读财报、新闻并输出摘要,通过 Online Context Compact 保持上下文焦点,避免因超长文本截断导致的错误,同时降低推理成本。
局限
- 论文自认的局限包括 harness 预训练、多后端训练、递归高效改进和搜索覆盖与成本。当前仅在 GPT-5.6 Sol 和 Opus 5 两个后端上验证,未扩展至其他闭源或开源模型,跨后端迁移性存疑;发现的机制依赖特定 API 行为(如缓存复用),后端更新可能导致机制失效。此外,自动搜索过程本身成本较高,限制了其在资源受限场景下的应用,且未形成递归式自我改进闭环。
- 可推断的局限:实验主要在 EdgeBench(51 任务)、Terminal-Bench 4 和 IMO 2026 上进行,任务类型偏向软件工程与数学推理,对长程开放式研究、多模态交互、复杂工具调用等场景的泛化能力未充分验证。Token 减少基于 recorded token traffic,可能未计入缓存未命中重试、并行请求等隐藏成本;性能与 Pi 相当而非显著提升,说明该方法主要优化效率而非提升智能上限,其价值高度依赖后端计费模型。
- 与同类工作对比的弱点:SoL-Pi 是在 Pi 基础上通过自动化搜索得到,但 Pi 本身已是高效 harness,改进空间有限;结果仅与 native Codex/Claude Code 和 Pi 对比,未与 LangChain、AutoGen、CrewAI 等流行框架比较,无法判断其在更广泛 harness 生态中的相对优势。发现的可复用机制(Action Fusion 等)可能已被手工实现部分覆盖,新颖性主要体现在自动化发现流程而非机制本身;同时,大规模 rollout 搜索需要较高算力,小团队或资源有限环境难以复现。