WeVisDoc:从覆盖到能力,面向鲁棒的端到端文档解析
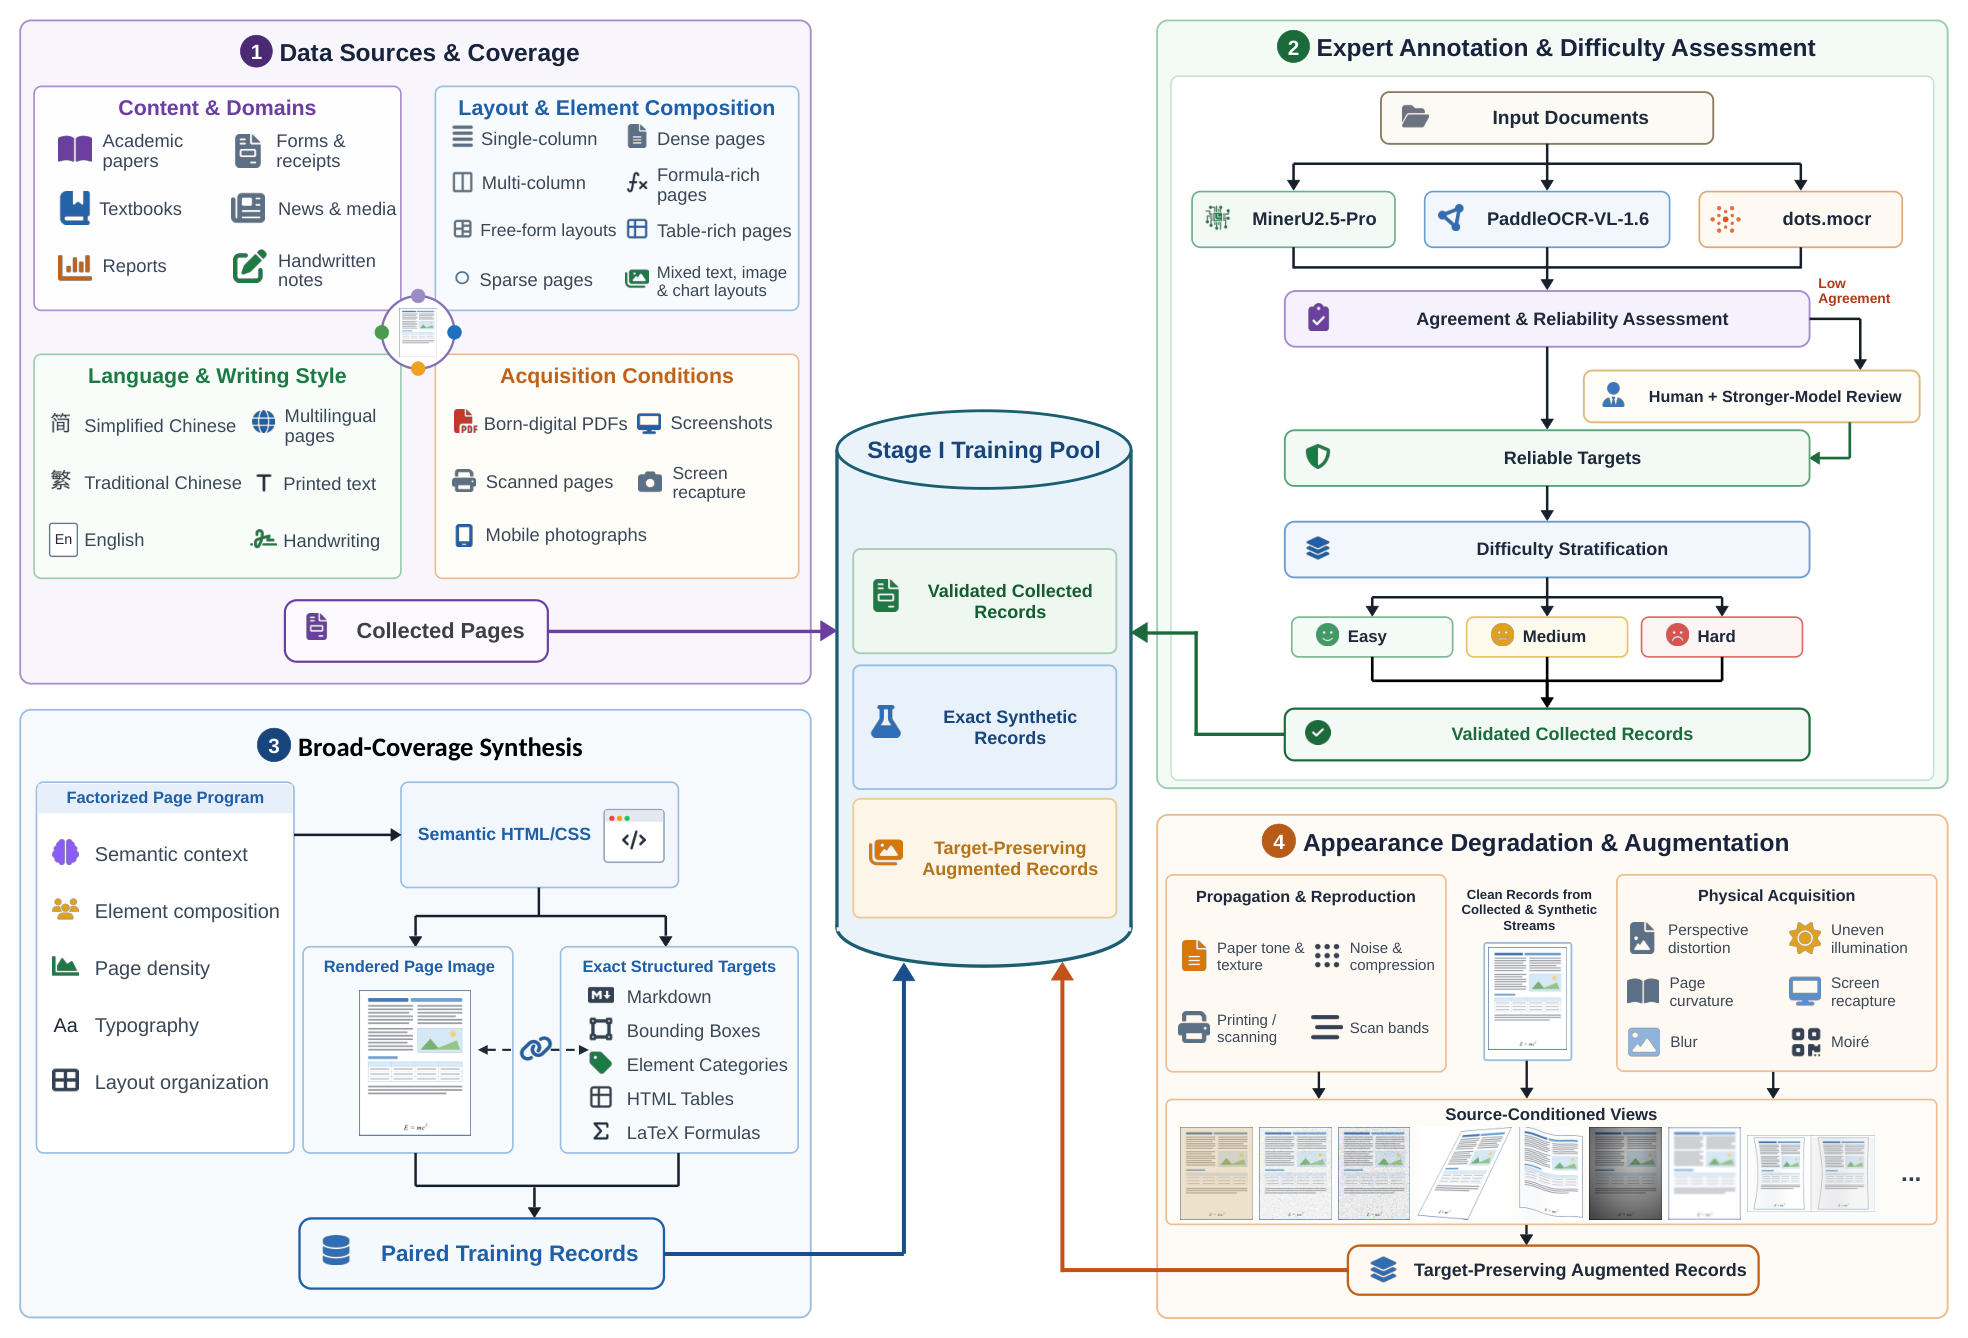
文档解析将文档图像转换为结构化内容,需要在多样版式与采集条件下保持可靠性能。然而训练语料偏向常见文档类型与干净的数字页面,而仅扩大覆盖范围并不能指明如何解决解析器剩余的弱点。 我们提出 WeVisDoc ,一个两阶段、以数据为中心的鲁棒端到端文档解析框架。Stage I 通过异构数据与结构保持的退化合成,拓宽语义、结构与外观层面的覆盖范围;Stage II 则利用留出的探针(probe),在固定的视觉-结构聚类内度量 Stage I 解析器的残差错误,这些诊断结果进一步指导针对性的数据构建与目标 token 预算的重新分配。 WeVisDoc-4B 在 OmniDocBench v1.6 上取得 95.38 的 Overall 分数,在三个 PureDocBench 赛道上平均 Overall 分数达 75.54,在全部四个设定中均位列所比较的端到端解析器第一。与 Stage I 相比,Stage II 在两个基准上均提升了 2B 与 4B 模型的 Overall 分数,在退化的 PureDocBench 赛道上提升更明显,其中 4B 模型在 Real Degraded 赛道上提升 4.03 分。
论文精读
TL;DR WeVisDoc 提出两阶段数据驱动框架:先扩大语义/结构/外观覆盖训练,再基于残差诊断定向合成难例并重分配预算,使端到端文档解析在多样与退化场景下全面领先,4B 模型 OmniDocBench 达 95.38。
问题
问题背景
文档解析(Document Parsing)是文档智能的核心任务,目标是将版面复杂、采集条件多变的文档图像还原为结构化内容(文本、表格、公式、阅读顺序等)。当前工业界对端到端解析模型的需求已从单场景准确率转向跨版面、跨退化条件下的鲁棒性。
现有方法局限
主流数据驱动方法依赖扩大训练集覆盖范围(coverage),收集更多文档模板、语言和图像风格。但单纯堆数据存在两个技术局限:
- 覆盖偏差:训练语料偏向常见数字原版 PDF 页面,对真实拍摄、复印、光照不均等退化样本覆盖不足。
- 缺乏能力诊断:增加数据不指向模型残差的具体模式,无法回答“在哪些视觉-结构簇上仍然出错”。例如高密度表格、嵌套列表、低对比度公式等长尾组合容易被平均指标掩盖。
为什么难 / 重要
难点在于结构输出空间高度组合化:版面元素间的层级、跨页引用、退化干扰与 token 预算分配相互耦合。模型在这些角点场景的误差常源于训练数据与目标分布的错配,而非容量不足。业界关注度持续上升:OmniDocBench、PureDocBench 等基准明确将“真实退化鲁棒性”作为独立维度评估,说明单纯扩大数据采集已逼近边际收益瓶颈。
行业类比
类似大语言模型训练中从“预训练语料堆规模”转向 RLHF/DPO 针对人类偏好弱项做细粒度优化——文档解析也需要从“更多页面”走向“更有针对性的难例合成与重采样”。
核心洞察
- **从覆盖率到能力的转变**。WeVisDoc 的核心创新在于 Stage II 的能力诊断与定向精炼:用 held-out probe 在视觉-结构聚类中测量 Stage I parser 的残余错误,再指导目标数据合成和 token 预算重分配。这与以往通过扩大数据多样性来提升文档解析鲁棒性的做法不同——单纯增加数据覆盖会面临边际效益递减,且无法定位具体弱点。该框架将数据工程从“被动扩充”变为“主动补缺”,对实际项目中的模型迭代具有直接指导意义。
- **面向退化鲁棒性的两阶段数据策略**。Stage I 通过结构保持的退化合成(纸、复制、传输效应)初步提升鲁棒性,Stage II 基于 residual 诊断进一步针对退化场景合成数据,使得 4B 模型在 PureDocBench Real Degraded track 上提升 4.03 分。相比单阶段混合所有数据或仅依赖通用数据增强,这种先覆盖后诊断的策略能更高效地分配训练资源,避免在易学样本上浪费 token,对处理真实世界文档图像中的质量退化问题尤其有价值。
方法
输入与任务
输入为文档图像,输出为结构化内容(文本、表格、公式、布局等)。WeVisDoc 采用端到端解析器,直接生成统一的结构化序列。
Stage I:广泛覆盖数据构建
- 多源异构数据 融合多种文档类型、布局、图像来源与语言,结合页面/区域/组件级监督,扩大语义与结构覆盖。
- 结构保持退化合成 模拟纸张、复印、传输、物理采集等外观退化,同时保持结构标签一致性,增强对真实世界输入的鲁棒性。
- 统一专家标注与难度控制 多模型联合标注并评估难度,控制训练样本的难度分布。
- 组合式文档程序 通过组合不同元素(文本、表格、公式等)生成多样文档,并从语义 HTML 双重编译获得监督信号。
Stage II:能力诊断与定向精炼
- 残差诊断 使用留出探针在固定视觉-结构聚类中测量 Stage I 解析器的错误分布。
- 难例挖掘 文档级与组件级挖掘高错误样本,并人工审计。
- 定向数据合成 针对难以解析的元素家族,生成目标页面程序,同时共生成监督标签并进行聚类验证。
- 训练重平衡 将新增定向数据加入训练集,重新分配目标 token 预算,实现能力提升。
输出与差异
最终输出一个鲁棒的端到端文档解析模型。与单纯扩大数据覆盖的同类方法不同,WeVisDoc 通过残差驱动的能力诊断,将资源定向投入到模型的薄弱环节,实现了从“覆盖度”到“能力”的转变。
实验
实验设计部分:评估使用 OmniDocBench v1.6(覆盖多样文档类型)和 PureDocBench(包含配对退化场景的鲁棒性测试),分别测试 2B 与 4B 模型,对比多个端到端解析器。指标为 Overall score,同时对比 Stage I 与 Stage II 效果。
关键发现:WeVisDoc-4B 在 OmniDocBench v1.6 上达到 95.38,在 PureDocBench 三个 track 平均 75.54,均排名第一。Stage II 相比 Stage I 在两个基准上均有提升,尤其在退化严重的 PureDocBench 上增益更大,例如 4B 模型在 Real Degraded track 上提升 4.03 点。
与基线对比解读:该方法超越其他端到端解析器的关键在于两阶段数据策略——Stage I 扩大覆盖,Stage II 通过残差诊断定向补充数据,将“覆盖度”转化为“能力”。在退化场景下的显著提升表明,针对薄弱视觉-结构簇的数据合成比单纯增加数据量更有效。
行业影响
落地场景
WeVisDoc-4B 可直接嵌入需要高鲁棒文档解析的产品:企业合同审查、发票/表单自动化、内容平台富文本抽取、医疗与金融档案数字化。尤其在拍摄件、扫描件、传真、打印退化场景下,其端到端输出结构化内容能力可替代传统 OCR + 规则后处理的多级流水线。
商业价值
- 降本:Stage II 用残余错误诊断指导数据合成,避免盲目扩数据,减少人工标注与模型迭代成本。
- 提效/增收:OmniDocBench v1.6 总体 95.38,PureDocBench 三轨平均 75.54,退化轨相对 Stage I 提升 4.03 点,意味着真实业务中错抽、漏抽减少,自动化通过率提升。
- 体验:对用户上传的低质量图片也能稳定解析,减少人工介入等待。
接口与集成
模型权重在 HuggingFace,支持本地部署或 API 封装。输出格式兼容文档解析基准的 JSON/HTML,可对接 RAG 检索、知识库构建、LLM 结构化抽取等下游任务。集成方式:
- 替换现有 OCR 文本行输出为区域级组件分类与阅读顺序。
- 作为前端预处理模块,把任意文档图片转成 Markdown/HTML 喂给 LLM 或数据库。
- 用 Stage II 的诊断工具对业务自有数据做聚类残余分析,持续定向补充难样本。
具体 use case
- 电商商品详情页解析:从卖家上传的拍摄或截图商品图,直接抽标题、价格、规格表,避免因拍照模糊/倾斜导致的失败,提升商品上架自动化率。
- 金融合同关键条款抽取:处理传真或扫描版合同,稳定识别条款、金额、签名区块,减少人工复核,加速贷款/保险审批流程。
局限
- **数据构建依赖多模型联合标注** 与程序化合成,成本较高且可能引入**标注偏差**。虽然联合投票可降低单模型错误,但现有模型的系统性盲区仍会传递到训练数据;程序化模板和退化合成虽覆盖面广,但与真实世界复杂、非理想的文档样式仍存在分布差异,可能限制对极端长尾场景的泛化。
- **退化鲁棒性** 的模拟主要针对纸张、复印、传输和物理采集等单一或简单叠加效应,未能完全覆盖真实场景中低光照、运动模糊、几何畸变、传感器噪声等多因素叠加的退化。此外,混合不同难度的合成数据需要手动调节比例和观测性控制,调参成本较高且对不同部署环境的适应性有限。
- **评测范围** 集中在 OmniDocBench v1.6 和 PureDocBench 两个基准,未在更多样化、更大规模的真实业务数据上验证;模型规模仅为 2B 和 4B,没有探索更大参数下的表现。Stage II 中的视觉-结构聚类依赖固定数量的簇和手工设计的特征,可能无法自适应地捕捉全部残差模式,且两阶段训练流程增加了工程复杂度。