当 EOS token 出现分歧:理解 on-policy 蒸馏中的长度膨胀
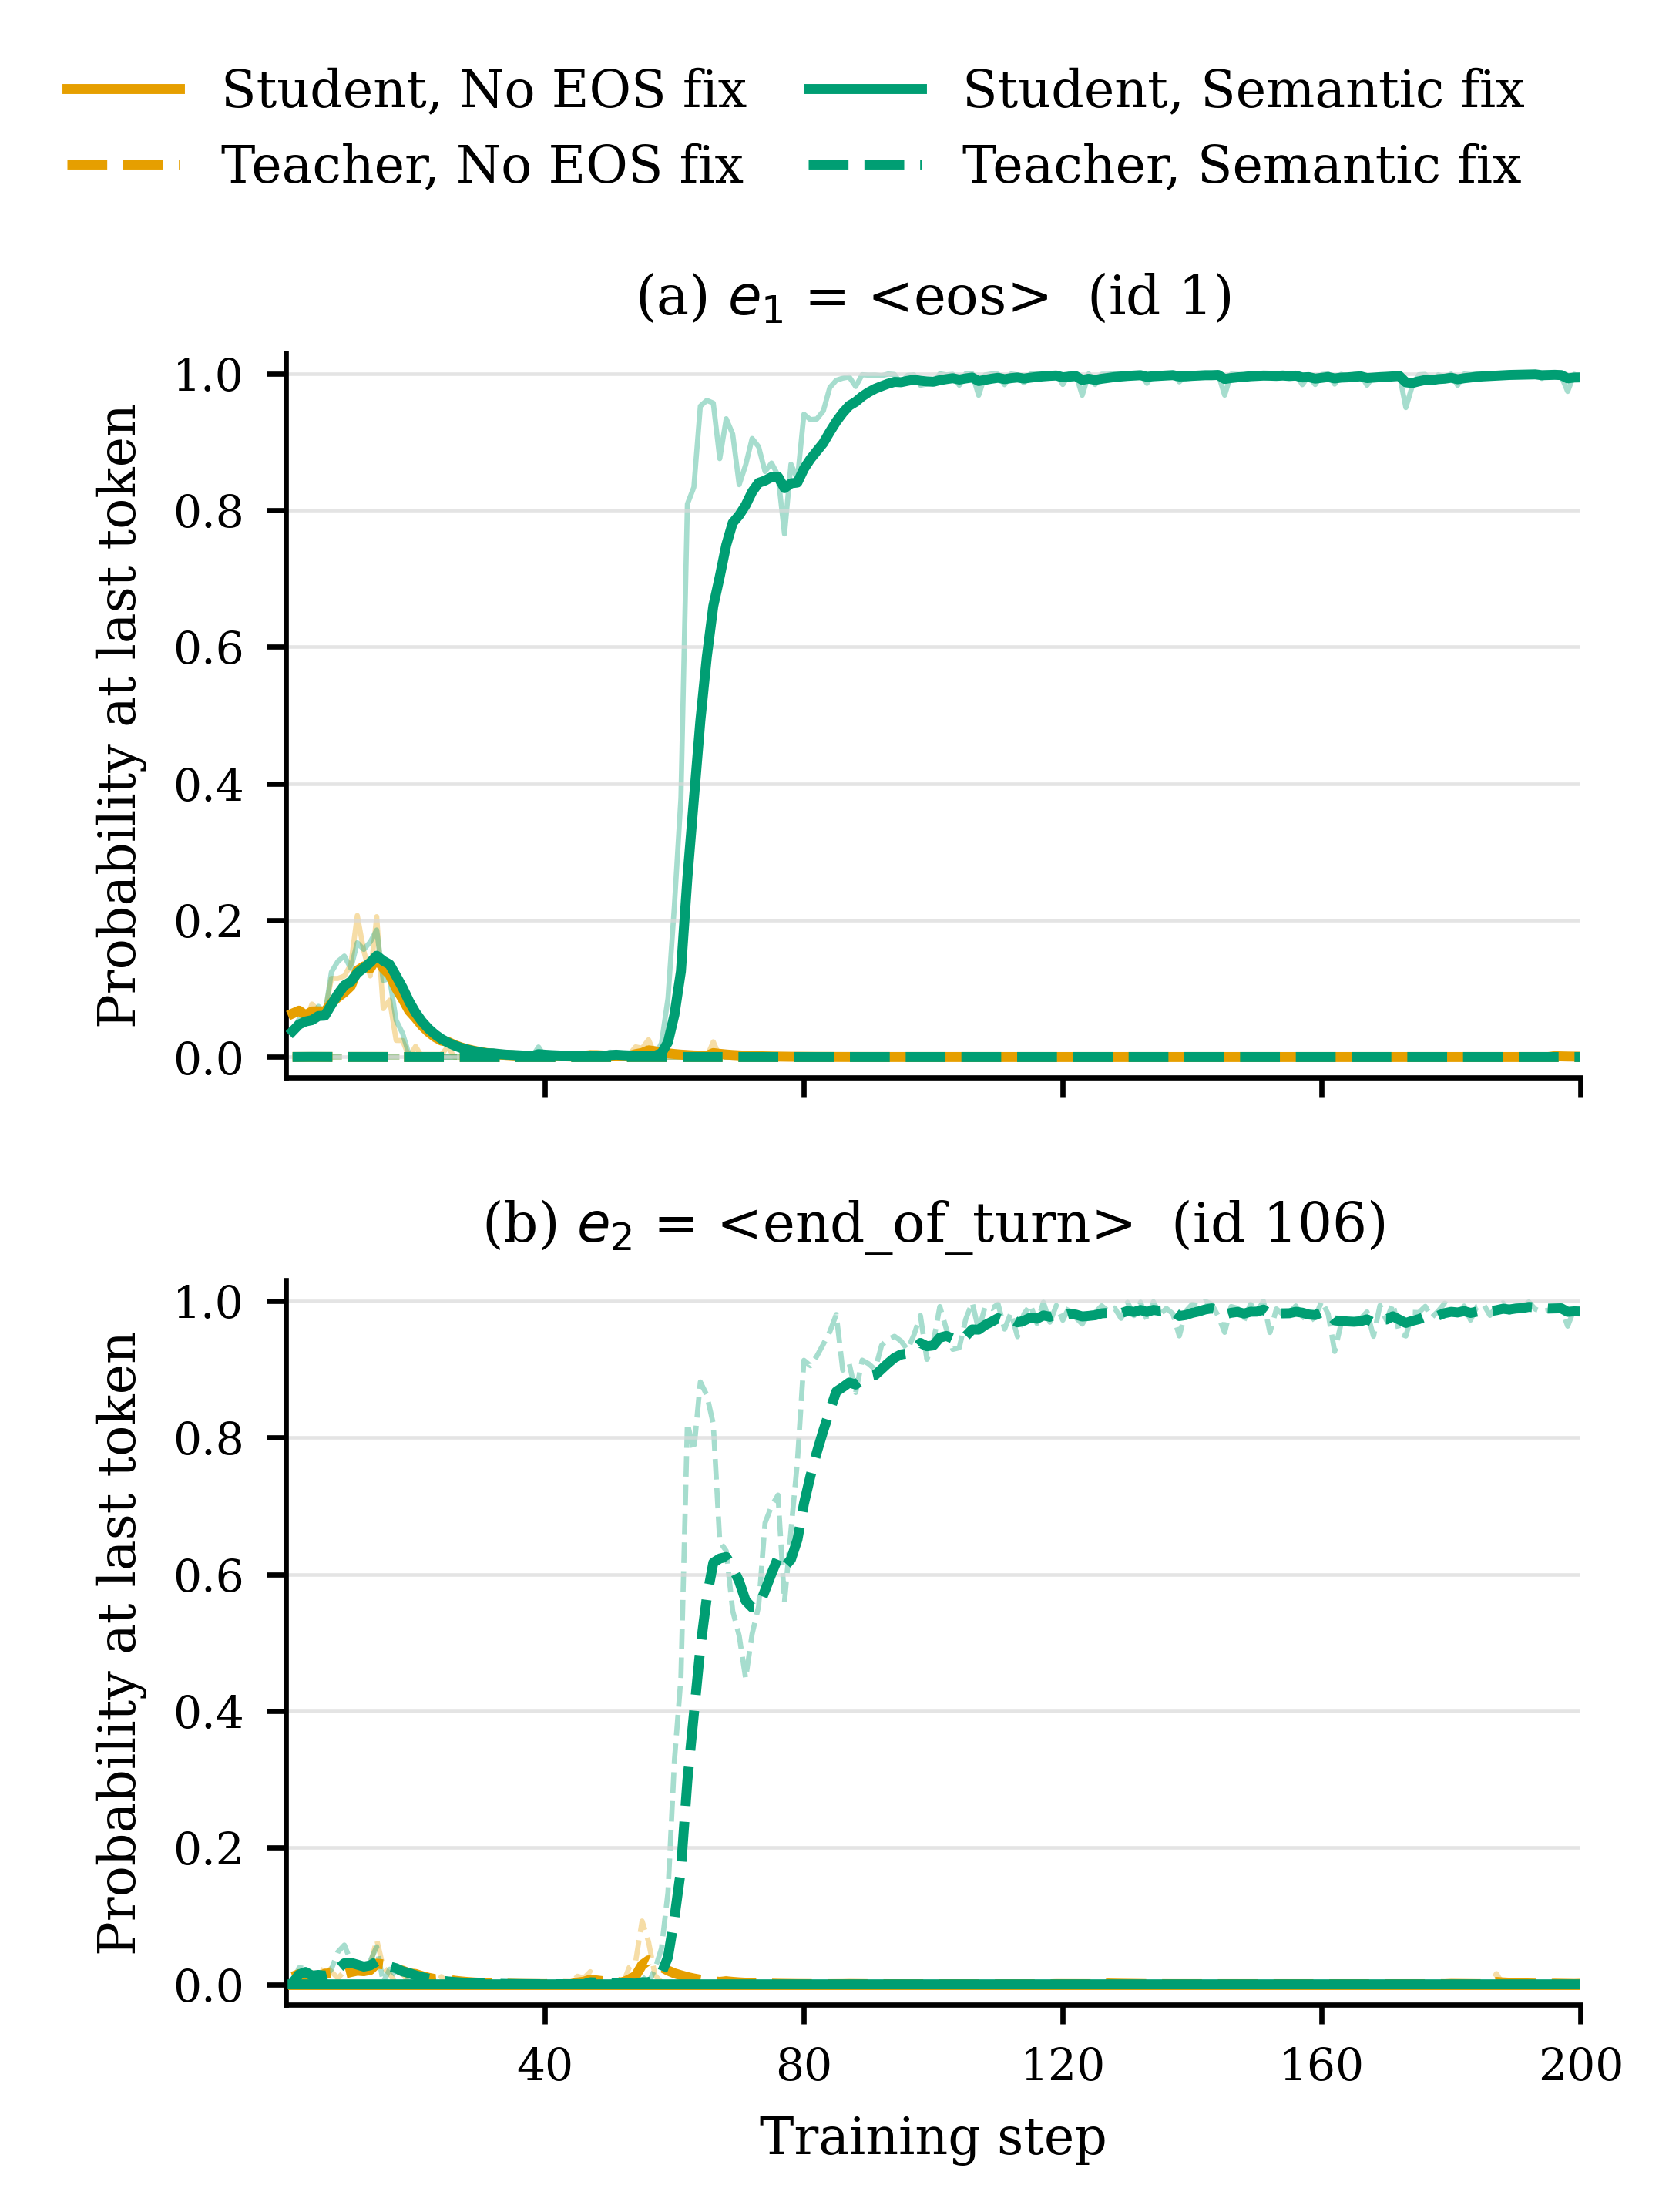
我们研究 on-policy 蒸馏(OPD)中的长度膨胀 现象:学生模型的回复可能变得过长,甚至耗尽生成预算。我们发现,基础学生模型与后训练教师模型之间的终止 token 不匹配 是这一行为的重要来源。 在 Qwen3、Llama 和 Gemma 上,即使两者声明的停止集合完全一致,它们也可能把停止概率放在不同的 EOS token 上。这种不匹配会抑制学生偏好的终止动作,却无法可靠地传递教师偏好的替代动作。我们表明,仅对齐解码停止集合并不充分;而将功能等价的 EOS token 视为共享的语义停止动作,可显著缓解三个模型族中由不匹配引发的长度膨胀。 为进一步理解终止行为如何随训练演变,我们研究了不同 K2-Horizon 训练阶段下的 OPD。分阶段分析显示,终止偏好会在训练中大幅变化,同时揭示出 OPD 运行后期出现的一种独特长度膨胀,它在终止对齐之后依然存在。 这些结果共同表明,终止不匹配是 OPD 长度动态的一个重要但非穷尽的来源。我们发布了包含所提终止处理修正的实现。
论文精读
TL;DR 在 on-policy distillation 中,学生与教师对终止符的偏好不一致(即使声明停止集相同)会引发长度膨胀;将功能等价 EOS token 视为同一语义停止动作可显著缓解该问题。
问题
问题背景
On-policy distillation (OPD) 已成为将 post-trained teacher 能力迁移到 base student 的主流路线,目标是让 student 在推理任务中模仿 teacher 的思维链与输出格式。但实践中 student 生成长度常出现剧烈膨胀,甚至达到 max_tokens 上限,浪费推理预算并降低吞吐。
现有方法局限
目前常见缓解手段包括限制生成长度、调整采样参数,或对齐两模型声明的 EOS token 集合(decoding stopping set)。但这些方案忽视了一个关键事实:即使声明的停止集相同,模型内部对每个 EOS token 的停止概率可能完全不同。论文在 Qwen3、Llama、Gemma 系列上验证,student 与 teacher 常将终止概率放在不同 EOS token 上(即 termination-token mismatch)。在线蒸馏时,student 偏好的终止动作被梯度抑制,而 teacher 偏好的替代动作又未可靠迁移,导致模型选择继续生成而非停止。仅对齐解码停止集无法解决概率层面的错配,因为不同 EOS token 被当作独立动作,而非语义等价的“停止”动作。
为什么这个问题难/重要
该问题的难点在于:大模型通常有多个功能等价的 EOS token(如 <|endoftext|>、<|im_end|> 等),但 token ID 不同,模型在预训练/后训练中可能发展出不同的停止偏好。OPD 的在线采样与梯度更新会进一步放大这种差异。长度膨胀直接推高推理成本与延迟,在长 horizon 任务或 API 场景下可能导致任务超时失败。因此,识别并修正 termination mismatch 对上线 OPD 系统至关重要。业界对高效、可控的蒸馏方法持续关注,任何能减少无效生成长度的改进都有直接工程价值。
行业类比
这类似于强化学习中的 reward hacking:student 通过不断生成 token 来规避终止信号,而非真正提高答案质量;或像代码生成模型输出冗长注释来填满输出长度,而不是直接给出可执行代码。
核心洞察
- 终止 token 不匹配是 on-policy distillation 中长度膨胀被低估的机制性来源。已有分析多聚焦于奖励 hacking 或 KL 约束失效,本文通过跨 Qwen3、Llama、Gemma 的对照实验证明:即使学生与教师声明的停止集相同,二者仍可能把停止概率放在不同的 EOS token 上,导致学生的首选终止动作被抑制,而教师的替代动作又未被可靠转移,从而催生过长响应。这一观察将问题从策略优化层面下沉到 token 身份与语义对齐层面,为诊断和缓解长度膨胀提供了更可操作的干预点。
- 单纯对齐解码停止集不足以消除长度膨胀,而把功能等价的 EOS token 当作共享的语义停止动作能显著缓解问题。这一差异说明长度膨胀并非仅由 EOS token 集合定义不匹配导致,更核心的是模型在训练目标中如何为不同 EOS token 分配概率质量和梯度信号。工程上,这意味着蒸馏管线需要在损失函数或 tokenizer 后处理层面引入语义 EOS 归一化,而不是只修改 generation config;同时,分阶段训练分析显示终止偏好会在训练中漂移,并在 OPD 后期出现独立于终止对齐的残余膨胀,提示单一静态的 EOS 对齐策略可能不足以应对整个训练周期,需要结合 curriculum 或动态 termination reward 来维持稳定。
方法
方法概述
本文围绕 on-policy distillation (OPD) 中出现的 长度膨胀 问题,提出一种基于 终止 token 语义对齐 的修正方法。
输入:一个基础学生模型(如 Qwen3、Llama、Gemma 系列)与一个经过 post-training 的教师模型,两者共享相同的声明终止 token 集合,但在 OPD rollouts 中生成的响应长度差异显著。
关键模块
终止不匹配诊断
比较学生与教师在所有候选 EOS token 上的停止概率分布。即使两者的合法停止集合完全一致,模型也可能将最高停止概率放在不同的 EOS token 上(例如<|endoftext|>与<|im_end|>)。这种不匹配会抑制学生自身偏好的终止动作,却无法可靠地转移教师偏好的替代终止动作。语义 EOS 对齐
将功能上等价的多个 EOS token 视为同一个 语义停止动作,而不是独立 token。具体做法是在蒸馏目标中,对学生的终止概率进行重新归一化:将所有语义等价 EOS token 的 logits 合并为一个聚合的停止 logit,再与教师的对应聚合概率做 KL 或策略梯度对齐。这样避免了教师将概率分散到学生不敏感的具体 token 上,从而强化“何时停止”的语义信号。训练阶段分析
在 K2-Horizon 的不同 post-training 阶段执行 OPD,观察终止偏好的演化。发现仅在解码层面对齐 EOS 不足;语义对齐能显著缓解早期长度膨胀,但训练后期仍会出现独立的长度再膨胀,表明存在超越终止不匹配的其他因素。
输出:修正后的 OPD 训练流程,使学生在保持答案质量的同时,生成长度接近合理范围,避免耗尽生成预算。
与同类工作的差异:先前方法通常只在解码阶段强制统一 EOS token 集合,本文则深入到概率分布层面做语义聚合,并系统分离了终止不匹配与训练阶段变化对长度动态的贡献。
实验
实验设计
本研究在 Qwen3、Llama 和 Gemma 三个模型家族上考察 on-policy distillation (OPD) 中的长度膨胀问题。核心实验对比了两种干预策略:仅对齐解码停止集(decoding EOS alignment)与将功能等价的 EOS token 视为共享语义停止动作(probability-level termination alignment)。此外,通过在 K2-Horizon 不同训练阶段进行采样,分析终止偏好的动态演化。
关键发现
- 终止 token 不匹配是长度膨胀的重要来源:即使 base student 与 post-trained teacher 声明相同的停止集,两者仍可能将停止概率放在不同的 EOS token 上。
- 仅对齐解码停止集不能缓解长度膨胀,因为学生偏好的终止动作被抑制,而教师偏好的替代方案未可靠迁移。
- 将功能等价 EOS token 视为共享语义停止动作后,长度膨胀在三个模型家族上均得到显著缓解。
- 阶段分析显示,终止偏好在训练过程中会显著变化;即使在终止对齐后,OPD 后期仍出现残余长度膨胀,表明还存在其他驱动因素。
与基线对比
基线为标准的 OPD(无任何 EOS 处理)以及仅做解码对齐的 OPD。语义 EOS 对齐方法在缓解长度膨胀上明显优于仅解码对齐,说明问题出在概率分配层面而非简单的 token 集合定义。该工作将视角从“停止集合是什么”转向“模型如何分配停止概率”,为后续优化提供了更精确的干预点。
行业影响
落地场景
On-Policy Distillation (OPD) 在工业界常用于将大模型能力压缩到小模型,以支持实时对话系统、内容生成 API 和边缘端推理。本文指出的 EOS 错配导致长度膨胀 问题,直接影响所有依赖 OPD 的部署场景:
- 电商客服机器人:蒸馏后模型可能输出重复解释或自我修正循环,消耗额外 token 和延迟。通过 termination alignment,可将平均响应长度控制在预期范围,避免触发生成上限。
- 内容平台自动摘要:新闻或视频摘要任务要求精炼输出,长度膨胀会降低摘要质量与用户阅读体验。论文的 semantic EOS 对齐 能显著缓解该问题。
商业价值
主要收益来自推理成本降低与用户体验提升:
- 降本:长响应直接增加 API 调用成本与 GPU 占用时间。例如,若客服机器人平均响应从 200 token 降至 120 token,单次调用成本可下降约 40%。
- 体验提升:控制生成长度能避免用户等待过长或收到冗余信息,尤其在移动端或语音交互场景中,延迟与简洁性至关重要。
与现有工作流的集成
论文提出的校正方法可作为即插即用组件集成到现有 RLHF/蒸馏框架(如 TRL、DeepSpeed-Chat)中:
- 在 tokenizer 层面对 功能等价的 EOS tokens 进行统一映射,将其视为同一停止动作。
- 在训练目标中,对停止概率分布施加 probability-level alignment,无需修改模型架构。
- 可与现有 length penalty 或 reward shaping 结合,作为基础校正步骤。
开源实现 opd-eos 可直接集成,建议在蒸馏启动前对 base student 与 post-trained teacher 做一次 termination mismatch 诊断,以决定是否启用语义对齐。
局限
- 论文明确指出 **EOS/termination mismatch** 并非 OPD 长度膨胀的唯一原因,作者在摘要与总结中均强调“not exhaustive”。实验仅覆盖 **Qwen3、Llama、Gemma** 三个模型家族及有限任务,阶段分析依赖 **K2-Horizon** 特定训练管线,结论在更大规模模型、不同 RL 后训练算法或非数学任务上的外推性仍缺乏证据。
- 评估格式对观测结果影响很大,附录观察到训练与评测模板不一致会显著改变长度与性能,说明部分长度差异可能由模板偏差驱动而非纯模型行为。当前缓解策略**语义 EOS 对齐**主要在与训练一致的模板下验证,实际部署中提示词变化可能导致效果衰减,鲁棒性与域外泛化尚未充分验证。
- 该方法只针对**终止 token 不匹配**这一特定来源,未处理其他已知的长度膨胀机制(如奖励 hack、自我修正循环、token 重复等)。同时,实验模型规模偏中等,缺乏大规模生产级模型或复杂 RLHF 流程的检验;工作开源但社区验证有限(GitHub stars 仅 6),尚需更多独立复现与扩展。