TeleAntiFraud 2.0:一个可刷新、基于画像的音频电信诈骗检测基准
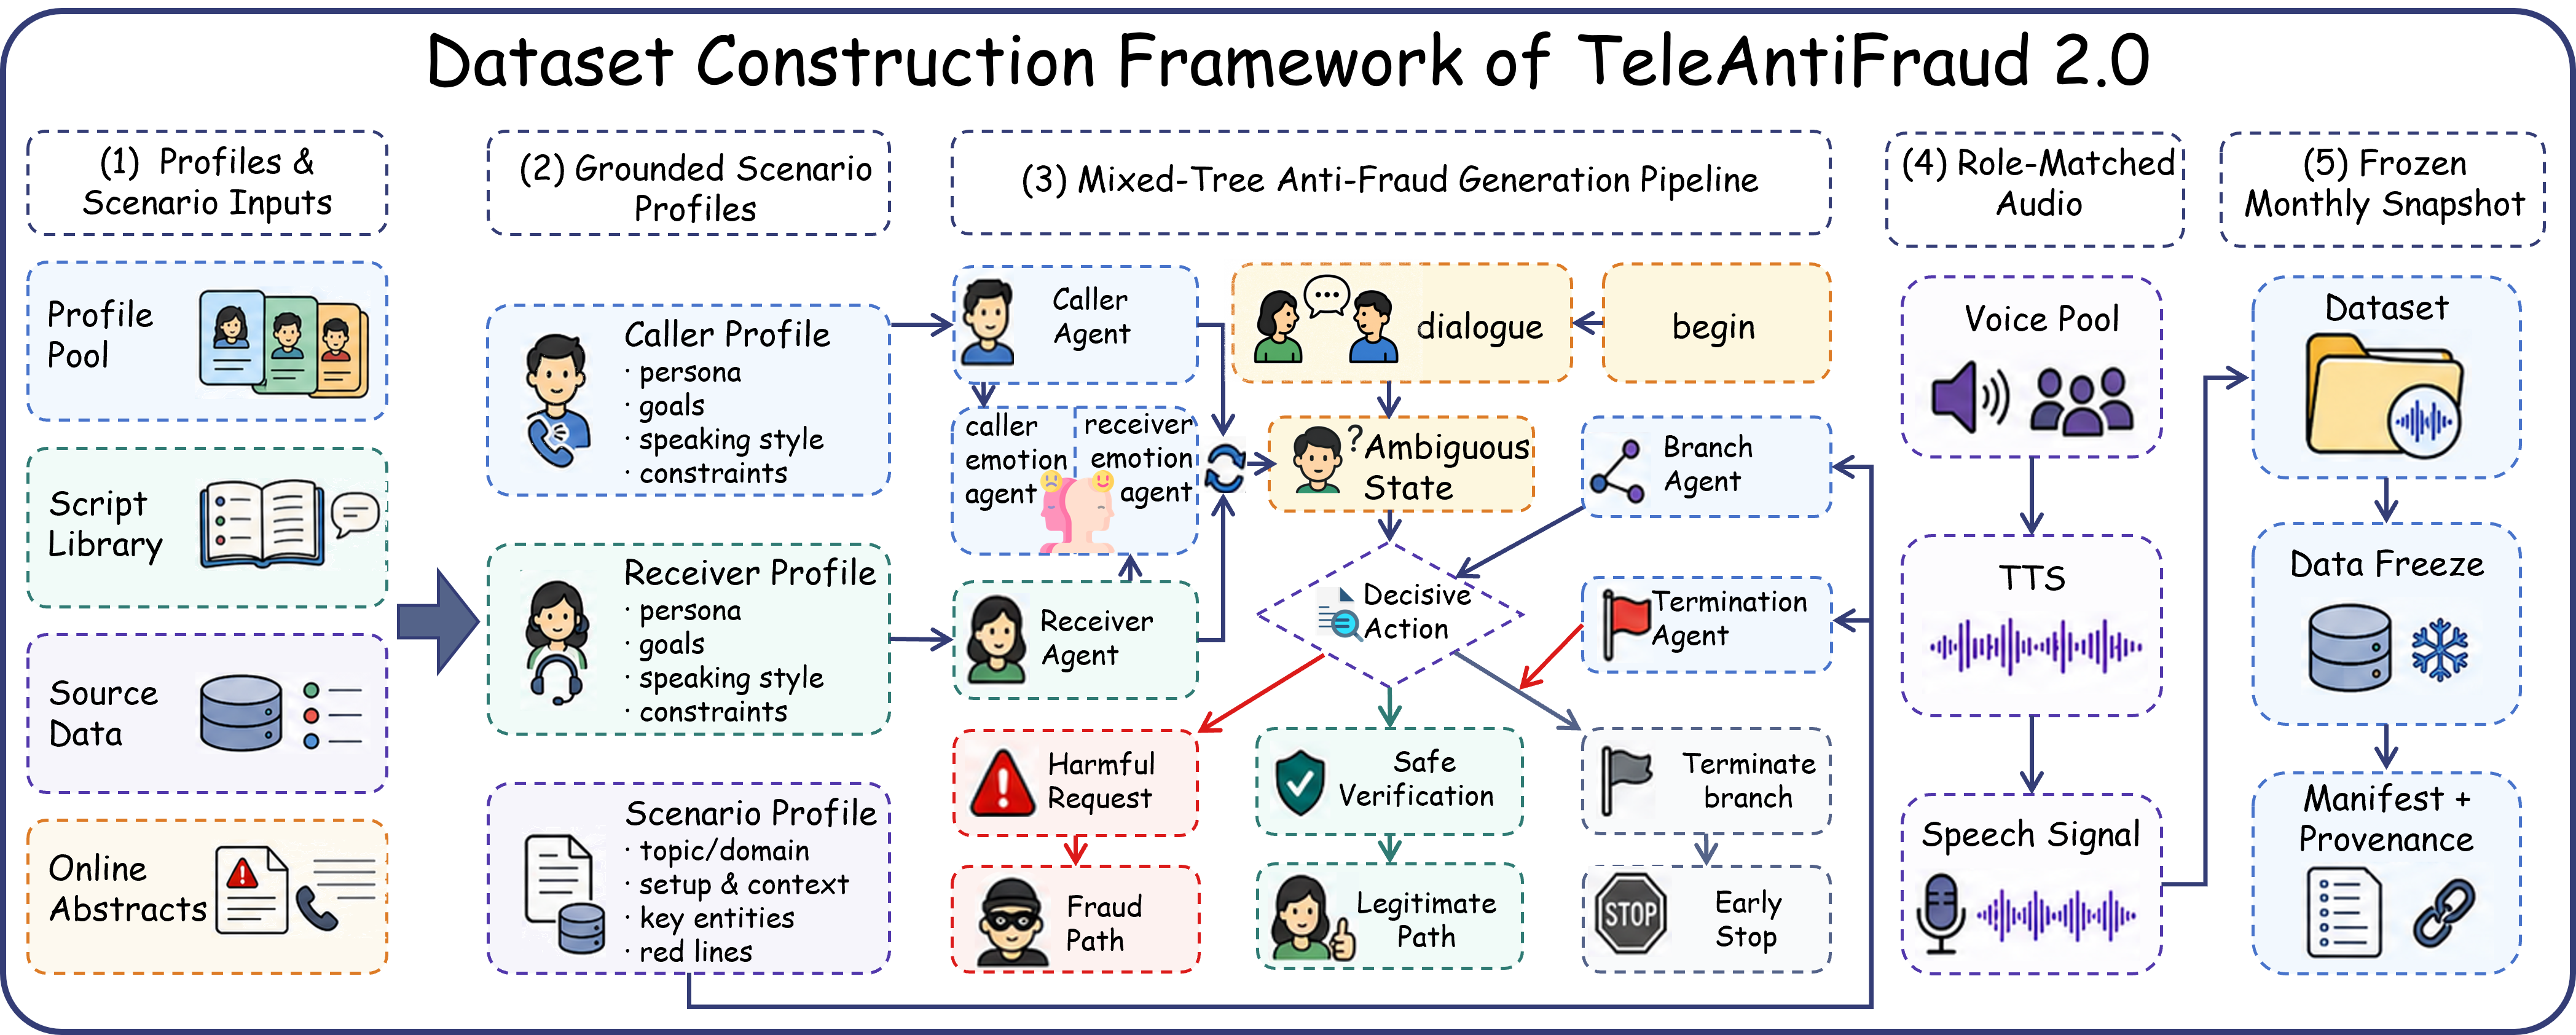
电信诈骗话术演化极快,且常伪装成日常客服对话,这对基于音频的反诈评测提出两点要求:基准需纳入新出现的诈骗模式且不覆盖既有测试集;需区分诈骗与合法的近域 通话,而非依赖话题分离的负样本。 我们提出 TeleAntiFraud 2.0,用 Mixed-Tree Anti-Fraud Generation Pipeline 构建,并配合月度冻结评测协议。流程先将线上诈骗案例摘要转化为基于画像的场景,经混合树生成扩展,在共享上下文下生成诈骗与非诈骗两条对话路径,再把校验后的对话渲染为角色匹配语音,并冻结音频、标签、prompt、manifest 与溯源记录。每套冻结集含 900 通中文通话(600 诈骗 / 300 近域非诈骗)。 受控文本实验显示,三个分类器在无关或普通负样本上可达完美的 Macro-F1,但面对近域同源负样本 时降至 0.65-0.68。全量音频与 ASR+LLM 评测进一步暴露类别先验捷径、预测坍缩与快照敏感性。 因此我们认为,近域构造 与 坍缩感知的汇报方式 应成为音频电信诈骗模型评测的核心要求。配套研究工件包含构建代码、评测脚本、manifest 与文档,数据与代码见 https://anonymous.4open.science/r/TeleAntiFraud-20-EEB2/。
论文精读
TL;DR TeleAntiFraud 2.0 是一个可刷新的音频电信欺诈检测基准,用混合树生成近域易混淆样本与月度冻结评估,揭示模型在近域负样本下 Macro-F1 从满分骤降至 0.65–0.68。
问题
问题背景:音频电信欺诈检测领域当前关注可更新、可溯源的基准构建,以应对诈骗话术快速演化。
现有方法局限:现有基准通常发布静态测试集,负样本多为不相关话题或普通服务对话,与欺诈域在主题上分离。这导致两个具体技术缺陷:
- 无法在不覆盖旧测试集的情况下纳入新骗术,模型对未见欺诈模式容易过时;
- 主题可分离性让分类器仅凭浅层关键词或声学线索就能取得
Macro-F1高分,实际却无法区分共享上下文的欺诈与合法近域通话。
为什么难/重要:诈骗话术刻意模仿常规客服流程,近域合法样本与欺诈样本共享角色、意图与对话策略,真实判别依赖细粒度语义与对话逻辑。这种混淆条件下,模型容易利用类别先验捷径而非鲁棒推理,导致部署中预测崩溃;同时音频链路引入 ASR 误差与角色混杂,进一步放大鉴别难度。业界高度重视,因为欺诈检测的误报与漏报直接影响用户信任和合规成本。
类比:这类似语音助手安全测试中的对抗样本更新问题——若负样本只包含完全无害的固定指令,模型无法区分高度相似的恶意变体,必须持续注入近域混淆样本并冻结版本才能有效评估。
核心洞察
- 近域负样本(near-domain negatives)是评估电信诈骗检测模型真实泛化能力的关键,传统主题分离负样本会掩盖模型对混淆场景的脆弱性。TeleAntiFraud 2.0 通过共享上下文的欺诈与非欺诈对话路径生成近域负样本,使三类文本分类器从完美 Macro-F1 骤降至 0.65–0.68,证明此前基准普遍高估模型性能,业界需重新审视负样本构造策略。
- 采用月度冻结评估协议(monthly frozen evaluation protocol)将动态欺诈手法更新与可复现基准相结合,解决了静态数据集无法跟上诈骗脚本演化的矛盾。每个冻结集包含 900 通中文通话及完整溯源记录,既允许持续纳入新诈骗模式,又保证不同时间点的评估结果可回溯、可比较,为动态环境下的模型持续评测提供了可操作的工程范式。
方法
输入
以在线诈骗案件摘要(online fraud-case abstracts)为原始输入,目标是将新出现的诈骗模式纳入基准,同时保留已冻结的历史测试集,避免覆盖。
关键模块
- Scenario Profiling:将案件摘要解析为 profile-grounded scenarios,即通过角色档案(如客服、受害者)和场景上下文,把抽象的诈骗手法具象为可对话的设定。
- Mixed-Tree Expansion:基于混合树结构扩展场景,生成多条共享相同上下文的对话路径。该步骤确保欺诈与非欺诈变体来自同一“故事根”,而非独立主题。
- Collaborative Dialogue Realization:在共享上下文中,分别实现欺诈路径与非欺诈(合法近域)路径。采用 turn-level collaboration 机制,由多个生成代理轮流产出对话轮次,保证两类对话的语言风格、话题和交互模式高度相似,形成 near-domain sibling negatives。
- Speech Rendering and Quality Control:将验证后的对话文本渲染为角色匹配的语音,并对音频质量、标签一致性进行校验。
- Freeze and Archive:按月冻结全部产物,包括 音频、标签、prompts、manifests、provenance records,形成不可变评估集。
输出
每个冻结集包含 900 个中文通话,其中 600 个欺诈、300 个近域非欺诈。所有音频、元数据和溯源信息共同支撑可复现的月度评估协议。
差异点
与依赖主题分离负例(如完全无关话题)的早期基准不同,该方法强制在 共享上下文内构造近域负例,并通过冻结快照和溯源记录实现可刷新但不破坏历史评估的持续性。
实验
实验设计
- 使用 TeleAntiFraud 2.0 冻结评测集,每个集合包含 900 通中文电话:600 欺诈 + 300 近域非欺诈。
- 受控文本实验:三个分类器分别在与主题无关的负样本、普通负样本和近域兄弟负样本上评测,对比 Macro-F1。
- 全量音频与 ASR+LLM 评估:分析类别先验捷径、预测塌缩和快照敏感性。
关键发现
- 三个文本分类器在与主题无关或普通负样本上达到完美 Macro-F1(1.0),但在近域兄弟负样本上降至 0.65–0.68,说明近域构造能有效暴露快捷特征依赖。
- 混合树兄弟样本降低了线性可分性,近域通话更接近真实混淆条件。
- 冻结快照暴露了模型在不同欺诈家族间的预测塌缩,类别先验分析表明模型可能利用数据集不平衡而非语音内容。
与基线对比解读
与常见的主题分离负样本基准相比,TeleAntiFraud 2.0 通过共享上下文的欺诈 / 非欺诈对话路径,强制模型区分“形似神非”的近域样本。完美 Macro-F1 到 0.65–0.68 的落差直接量化了评估协议差异,证明仅靠无关负样本会高估模型能力。全量音频与 ASR+LLM 结果进一步表明,需要 collapse-aware 报告机制来避免类别先验导致的虚假性能。
行业影响
落地场景
电信运营商与金融机构的语音反欺诈系统 可直接采用 TeleAntiFraud 2.0 进行月度回归评估。例如,跨国银行的呼叫中心经常遭遇伪装成“账户安全验证”的欺诈电话,传统基准使用主题分离的负样本导致模型在近域混淆场景下 Macro-F1 仅 0.65–0.68,而本基准提供的近域负样本 (near-domain siblings) 更贴合真实拦截需求。全球电商平台(如 Amazon、eBay)的客服语音通道也可部署该基准,检测仿冒官方客服的诈骗脚本。
商业价值
- 降低欺诈损失:每月刷新机制确保新诈骗模式被快速纳入评估,模型迭代后能持续识别新型脚本,减少单笔欺诈造成的资金损失。
- 减少人工复核成本:近域负样本降低误报率,使人工审核团队专注于真正可疑通话,提升运营效率。
- 规避模型上线风险:冻结快照 暴露的预测崩溃 (prediction collapse) 和类先验捷径 (class-prior shortcuts) 可在上线前拦截,避免生产环境大规模误判导致的客户流失与合规处罚。
与现有产品/工作流集成
- MLOps 持续评估:将每月冻结的音频、标注、
prompts、manifests与provenance records纳入 CI/CD 流水线,每次模型更新必须通过 Macro-F1 及崩溃指标阈值。 - ASR+LLM 管线:直接复用其 ASR+LLM 评估脚本,接入企业现有的语音识别与 LLM 推理服务,输出结构化判定与可解释证据。
- 数据溯源与治理:
provenance records可对接数据目录平台,满足金融级审计要求。
局限
- 数据集仅包含中文普通话电话录音,未覆盖多语言、方言或跨文化诈骗场景。虽然线上欺诈案例摘要来源广泛,但生成 pipeline 主要面向中文语境,可能限制模型在全球化部署时的泛化能力。相较已有英文或跨语言电信欺诈数据集,缺乏语言多样性,后续工作需验证多语言适配性或扩展语种。
- 生成 pipeline 依赖 LLM 合成对话,虽经人工验证,但与真实通话在语音自然度、信道噪声、说话人口音和情感表达等方面可能存在差距。这种合成域偏移可能导致模型在真实录音上表现下降,而论文未提供与真实录音的域适应对比实验。此外,生成过程中对欺诈脚本的抽象可能丢失某些关键细节(如特定话术的微妙措辞),影响模型学习真实欺诈信号。
- 月度冻结评估协议虽然支持刷新,但成本较高(每月需重新生成并验证 900 条对话),且新骗局模式从出现到纳入基准存在时间延迟。同时,基准任务限定为二元欺诈检测,未覆盖更细粒度的欺诈类型识别、实时预警或对话轮次级别的检测,限制了评估模型的实用性。未来可探索无监督刷新或持续学习设定。