以图像生成进行推理
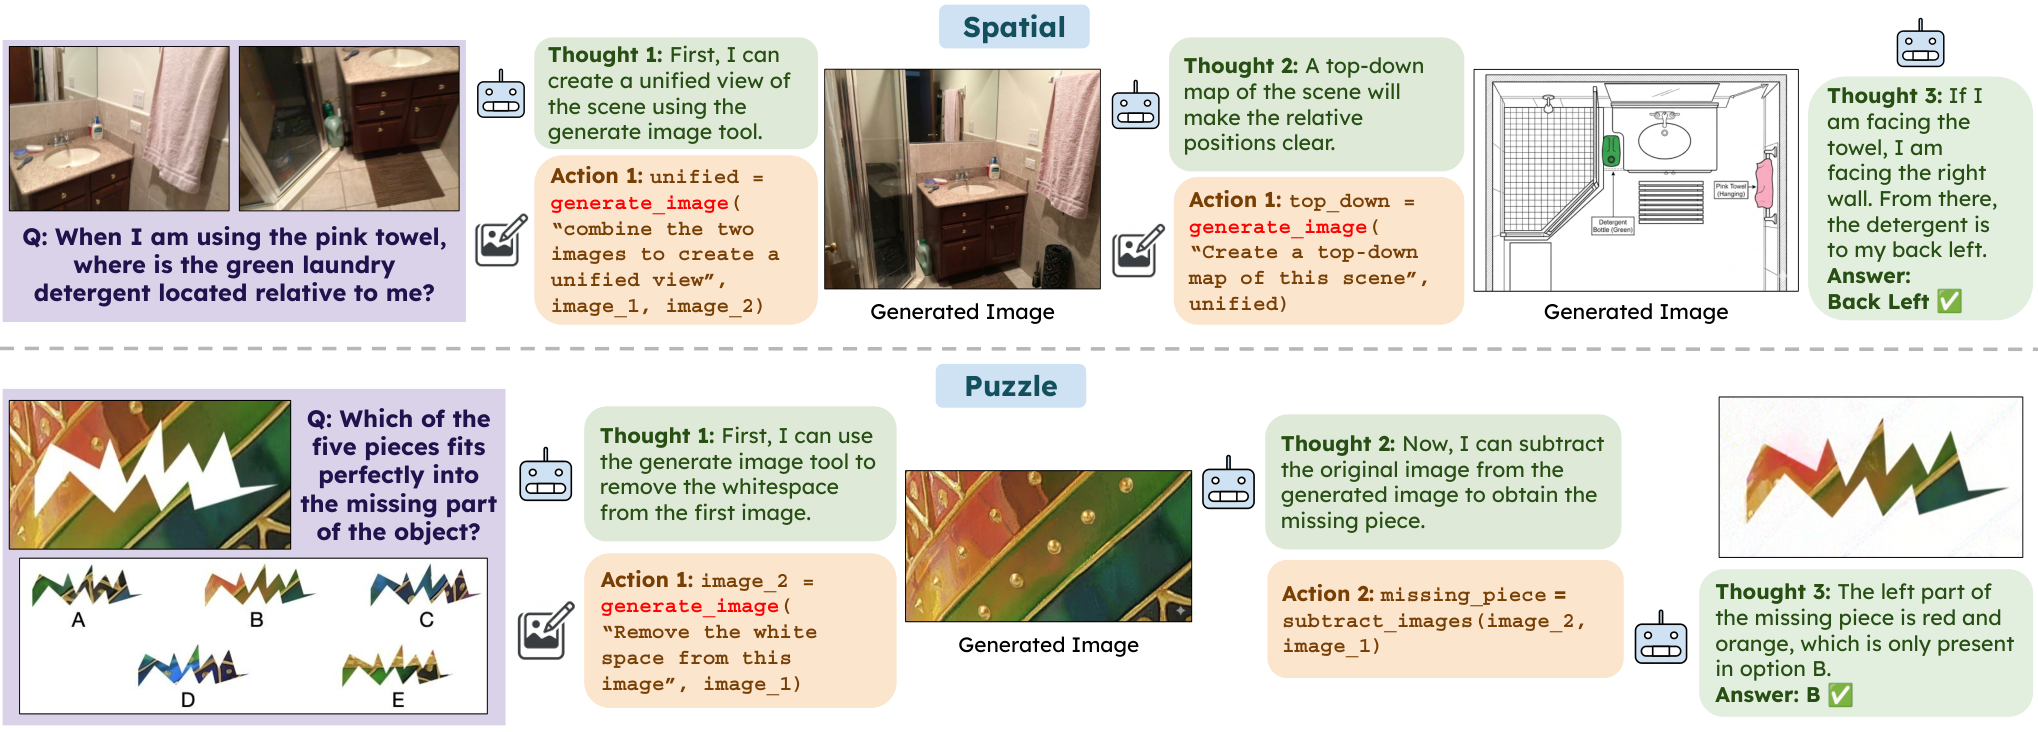
Chain-of-thought 推理让大语言模型能够把问题拆解为中间步骤再作答,深刻改变了自然语言处理。但将推理局限在文本层面,对于需要直接操作视觉表示的任务仍有明显不足。近期工作为多模态 LLM 配备深度估计、目标检测等外部视觉专家工具,然而这些工具本质上依赖狭窄而固定的操作,无法灵活地生成或变换视觉内容。 为此,作者提出 ReImaGin,把图像生成模型用作多模态 LLM 的灵活视觉推理机制。与固定功能的工具不同,图像生成模型可以接受自然语言指令,执行开放式的视觉操作,例如移除遮挡物,或根据房间的多个互不连续的视角生成平面图。 在涵盖多视角空间推理、碰撞预测等六项不同的视觉推理任务上,ReImaGin 一致优于纯文本推理与专用视觉工具基线,提升最高达 25%,体现了灵活、生成式视觉推理的优势。
论文精读
TL;DR **ReImaGin** 用图像生成模型作为多模态 LLM 的灵活视觉推理机制,能执行去除遮挡、生成平面图等开放式操作,在 6 个视觉推理任务上最高提升 25%,超越文本 CoT 和专用视觉工具。
问题
问题背景
多模态大模型在视觉问答等任务中持续提升,但主流推理范式仍将链式思考(CoT)限制在文本域,无法直接操纵视觉表征。
现有方法局限
现有方法主要依赖两种路径:一是纯文本 CoT,把图像信息映射为语言描述后再逐步推理,但文本无法表达空间关系、遮挡结构或需要合成新视图的任务;二是为多模态 LLM 配备固定功能的视觉专家工具(如深度估计、目标检测),但这些工具操作窄、刚性强,无法灵活生成或变换视觉内容。例如,移除遮挡物或从多个不连贯视角生成房间平面图这类开放式视觉操作,远超传统工具能力边界。
为什么难/重要
视觉推理任务(如多视角空间推理、碰撞预测)需要模型在视觉空间中进行想象、变换与生成,而纯文本推理丢失了关键几何与外观信息。固定工具难以覆盖开放域视觉操作,且每类任务需单独模块,集成与泛化成本高。业界关注多模态模型如何真正利用视觉信息进行推理,而非仅做文本映射。ReImaGin 用图像生成模型作为通用视觉推理接口,通过自然语言命令驱动开放式视觉操作,并自动发现推理策略,在多任务上超越文本推理与专家工具基线,增益最高达 25%,证明生成式视觉推理的潜力。
行业类比
类似于用生成模型替代手工设计的视觉特征提取器,图像生成正成为可调用的“视觉计算”原语,可类比为 LLM 工具调用中把扩散模型当作通用操作符,支撑机器人仿真、CAD 设计等场景。
核心洞察
- 图像生成模型可以充当灵活的视觉推理原语,突破固定功能专家工具的局限。与依赖深度估计或目标检测等窄、刚性操作的工具增强 MLLM 不同,ReImaGin 通过自然语言指令调用生成模型,可动态合成或变换视觉内容(如移除遮挡、从多个不相交视图生成平面图),将推理从文本空间扩展到可生成的视觉空间,从而能处理更开放、组合式的视觉问题。
- 让多模态 LLM 自主发现“何时生成图像、生成什么图像”的策略,比手工调用专家工具更通用。ReImaGin 引入自动化策略发现机制,使模型能根据任务需求选择生成式视觉推理步骤,在六个视觉推理任务(包括多视图空间推理、碰撞预测)上一致超越纯文本推理和专用视觉工具基线,提升最高达 25%,证明了生成式视觉推理作为通用中间表示的优势。
方法
输入与视觉状态
ReImaGin 接收多模态输入:原始图像与自然语言问题。图像作为初始视觉状态,问题定义需要完成的视觉推理任务,例如多视角空间推理或碰撞预测。
核心循环:MLLM 与生成式视觉工具交互
- MLLM 作为控制器,评估当前视觉状态是否足够回答;若不足,则生成一条自然语言指令,描述所需的视觉操作,如“移除遮挡物”或“从多个视角合成房间平面图”。
- 图像生成模型 根据该指令生成或修改图像,产生新的视觉状态。
- 新图像返回给 MLLM,继续文本链式推理,判断是否需要进一步视觉操作。
- 该循环持续到 MLLM 输出最终答案,形成视觉-语言交替推理。
自动化策略发现
ReImaGin 使用元提示让 LLM 针对特定任务自动生成视觉推理策略,例如先执行“去除遮挡”再“估计物体距离”。这些策略被转换为可执行的步骤,指导 MLLM 在何时调用生成式工具,减少无效探索。
输出与实现
最终输出为文本答案,中间图像作为推理证据保留。方法依赖提示工程与工具调用,未引入额外训练。
与同类方法的差异
与固定功能视觉专家工具(如深度估计、目标检测)不同,ReImaGin 将图像生成模型作为可编程的开放式视觉操作器,能够应对需要灵活变换视觉内容的任务,而非仅执行刚性、预定义的视觉操作。
实验
实验设计
ReImaGin 在六个视觉推理任务上评估,包括多视图空间推理、碰撞预测等。对比基线:纯文本 CoT 推理,以及配备专业视觉工具(深度估计、目标检测等)的多模态 LLM。ReImaGin 将图像生成模型作为可调用的视觉推理模块,通过自然语言指令生成或变换图像作为中间推理步骤。
关键发现
- 在所有任务上一致优于纯文本和专业工具基线,最高提升 25%。
- 生成式操作如 移除遮挡物、从多个房间视图生成平面图 展现出灵活性。
- 证明生成式视觉推理能够处理固定功能工具无法覆盖的开放式视觉变换。
深度解读
生成模型的核心优势在于自然语言接口与开放式操作能力,避免了为每类视觉操作单独设计专家模块。相比固定功能工具,ReImaGin 能根据任务需求动态生成视觉证据,更适合复杂、组合式推理。但需注意生成图像的可信度与额外计算成本,实际部署需权衡。
行业影响
落地场景
ReImaGin 可作为多模态 LLM 的视觉推理插件,嵌入需要开放式视觉变换的产品场景。
- 电商:根据用户上传的房间照片,移除遮挡物并生成不同布局效果图,辅助家具搭配推荐。
- 自动驾驶仿真:将多个离散视角的路况图合成为统一俯视地图,用于碰撞预测与路径规划测试。
- 内容平台:图像编辑 Agent 结合自然语言指令执行去水印、补全背景等非固定操作。
商业价值
- 降本:替代深度估计、物体检测等多个专用工具的集成与维护,降低工具链复杂度。
- 增收/体验:提升多模态 Agent 交互灵活性,缩短从需求到可视结果的迭代周期,提高转化率。
- 指标:论文在空间推理、碰撞预测等任务上最高提升 25%,意味着更可靠的视觉决策支持。
与现有产品 / 工作流的接口
ReImaGin 可封装为 MLLM Agent 的一个 tool,通过 function calling 接入:接收自然语言 prompt,输出生成图像并返回给 MLLM 继续推理。在现有 stack 中,可与已有的视觉专家工具并存,用于处理开放式或非结构化视觉变换。需注意图像生成引入的延迟与成本,适合异步任务或批量预处理。
局限
- **生成图像的保真度与可控性** 是核心瓶颈。图像生成模型虽然灵活,但输出可能无法忠实反映输入场景的精确空间关系、几何尺寸或遮挡结构,导致后续推理基于错误视觉信息。论文附录中“Faithfulness of the Generated Images”和“Failures of Image Generator”表明,生成模型在复杂场景下容易产生幻觉或遗漏细节,例如修改后的图像可能改变物体数量或相对位置。这与固定功能视觉工具(如深度估计)相比,在需要精确测量的任务上存在本质差距,限制了 ReImaGin 在严格物理或几何任务中的可靠性。
- **计算开销与延迟** 显著高于纯文本推理。每步视觉推理都需要调用图像生成模型,生成过程通常比文本 token 生成或轻量级工具调用慢几个数量级,且显存占用大。论文中提及测试时缩放通过重复采样(Test-Time Scaling via Repeated Sampling)进一步提升性能,但代价是成倍增加推理成本。对于需要实时响应的应用(如自动驾驶、交互式助手)或资源受限的部署环境,该方法的实用性受限,难以规模化推广。
- **依赖于生成模型的能力边界**。ReImaGin 的推理质量受限于所用图像生成模型的训练数据分布和生成能力,对于罕见视觉概念、极端视角或超出训练分布的物理约束,生成模型可能无法生成合理图像,导致推理失败。此外,多模态 LLM 与图像生成模型之间的耦合方式(如通过自然语言指令交互)可能引入信息损失,目前尚未探索端到端联合优化,限制了整体系统的性能上限。