用于扩散语言模型中有界状态推理的 Register Tokens
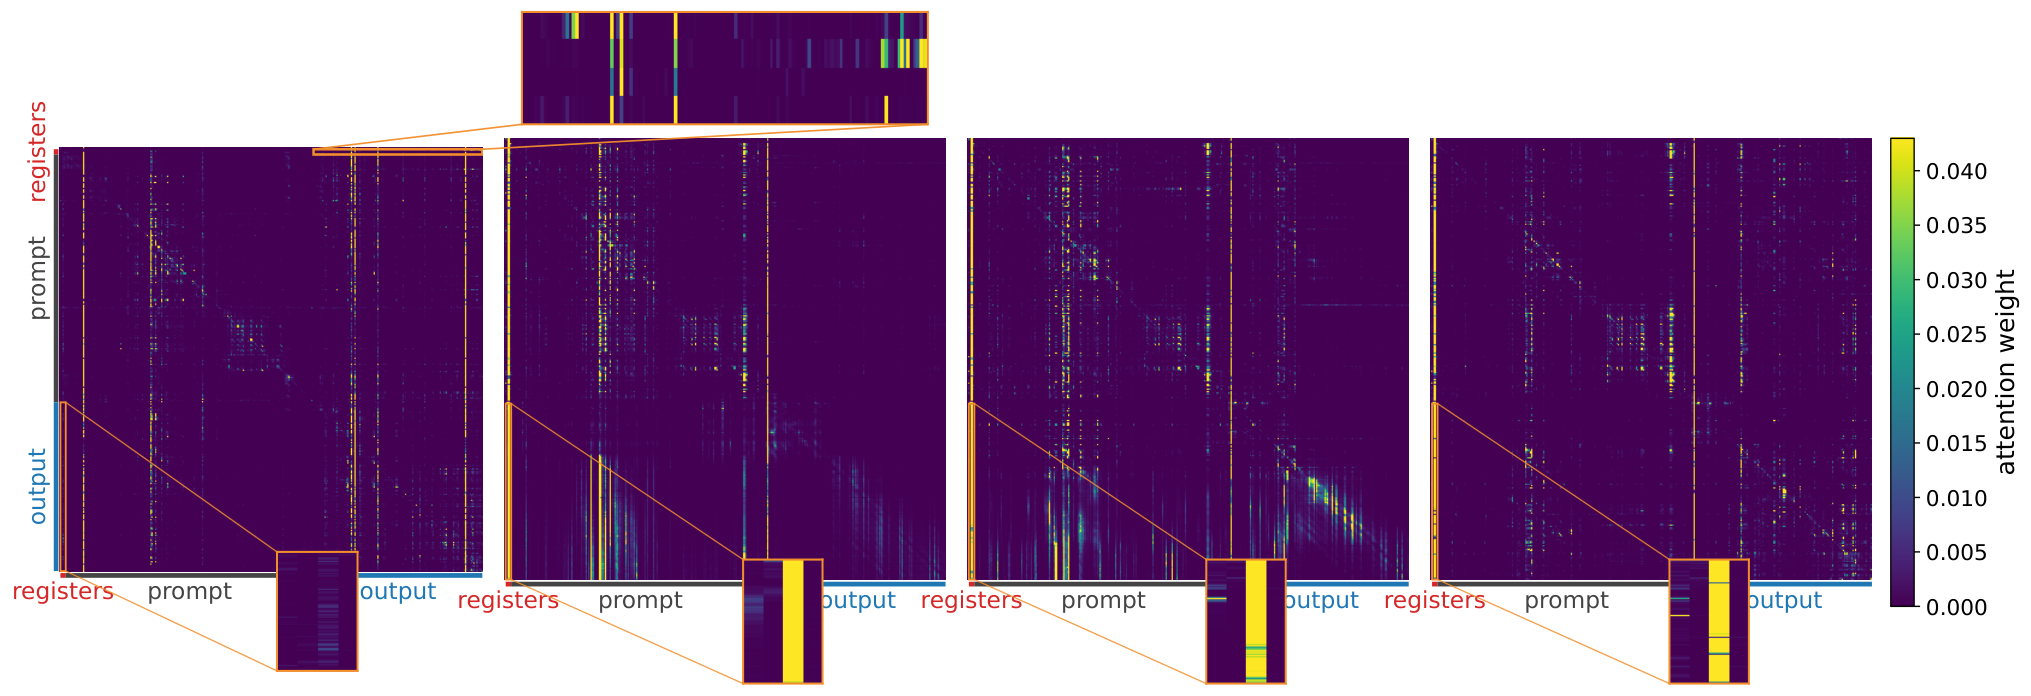
掩码扩散语言模型 (masked diffusion language models, dLLMs) 通过双向注意力迭代去噪被掩码 token 来生成文本。若要在多个生成片段之间延续推理,通常需要把先前生成的文本保留在上下文中。本文追问:dLLM 能否在这些文本被清除后,仅依靠固定大小的携带状态继续推理? 我们将该状态实现为少量 register tokens:位于固定位置的特殊 token,其连续隐状态被训练用于跨生成片段携带推理进展。我们对 dLLM 进行后训练,使其解码一个文本片段,在保留 register 值的同时清除该片段,然后从 prompt 和携带状态继续解码。 在 LLaDA 与 Dream 上的主要对比中,register 在所有基准上均优于离散文本携带,数学最高提升 8.5 分,代码最高提升 19.5 分。register 对有界代码生成尤其有效,因为正确程序通常跨越多个片段。最后,register 还可在长时程推理任务上通过 强化学习 进一步精炼。
论文精读
TL;DR 该论文提出用 register tokens 作为固定大小连续状态,在扩散语言模型分块生成中携带推理进度,实现有界状态推理,在 LLaDA 和 Dream 上数学/代码任务最高提升 19.5 点。
问题
问题背景
扩散语言模型(dLLMs)通过迭代去噪生成文本,其双向注意力天然适合推理和填充任务。然而,在长程生成如多步数学推理或代码生成中,模型必须跨多个生成块进行连贯思考,如何维护中间状态成为焦点。
现有方法局限
- 常规做法是将先前生成的文本全部保留在上下文中,导致上下文长度线性增长,内存和注意力计算成本激增。
- 使用离散文本总结(如 self-summarization)会丢失细节,并且总结本身需要额外生成步骤,引入误差。
- 基于压缩的记忆 token 方法大多针对自回归模型设计,难以直接迁移到 dLLMs 的迭代去噪范式,因为去噪过程中 token 会被反复掩码和重建,隐藏状态动态不同。
为什么难/重要
扩散语言模型在清除已生成文本后,仅靠固定数量寄存器 token 传递信息,需要模型学习一个紧凑的连续状态读写协议,这涉及信息瓶颈和训练稳定性挑战。业界对长上下文推理需求强烈(如代码补全、数学证明),但无限增长的上下文不可持续,固定大小状态是高效推理的关键。若成功,寄存器机制可让模型在有限内存下进行更长步骤的推理,对部署和扩展至关重要。
行业类比
类似对话系统中的长期记忆槽位,用少量固定向量保存关键信息,而非每次输入完整历史。
核心洞察
- register tokens 将跨生成块的推理状态从离散文本压缩为固定大小的连续隐状态,使 dLLM 在清空前文后仍能延续推理。与保留完整前文或生成文本摘要的 baseline 相比,该方案避免了上下文长度随生成步数线性增长,同时通过可训练读写协议保留必要推理进度。实验显示在 LLaDA 和 Dream 上,register 机制在每个基准上均优于离散文本 carry,数学最高提升 8.5 分、代码最高提升 19.5 分,尤其适用于需要多块生成的代码任务。
- 该方法将推理状态显式建模为可优化的 register token 隐状态,并通过后训练学习写入与读取协议,区别于传统 context compression 或外部 memory token 的固定设计。register 本身可以进一步用强化学习(如 chunked diffu-GRPO)在长程推理任务上细化,使有界状态推理从静态承载进化为可训练的推理缓冲。这一视角为部署在有限上下文设备上的语言模型提供了新的训练范式,暗示连续隐状态可作为比文本更高效的推理中间表示。
方法
方法概述
该方法针对 掩码扩散语言模型 (masked diffusion language models, dLLMs) 的跨 chunk 推理问题,引入一组 register tokens 作为固定大小的连续状态载体,替代在上下文中保留全部历史文本。整体流程如下:
- 输入:用户 prompt 与前一 chunk 保存下来的 register hidden states(连续向量)。
- 关键模块:在序列中插入固定数量的专用 register tokens(如 4 或 8 个),它们不参与文本解码,而是通过双向注意力与当前 chunk 交互,更新自身 hidden state,从而压缩携带推理进度。
- 训练方式:采用 chunked SFT,将长响应切成多个固定长度 chunk。每个 chunk 内部使用 ddLLM 的掩码去噪过程生成文本;完成后清除该 chunk 的普通 token 嵌入,但保留 register tokens 的更新后 hidden states,作为下一 chunk 的初始状态。训练目标是让 register tokens 学会在 chunk 边界有选择地写入和读取关键推理信息。
- 输出:当前 chunk 生成的文本,以及更新后的 register states(传给下一 chunk)。
与同类方法的差异
与保留离散文本(例如直接拼接上文的 last-N tokens 或自摘要)不同,register tokens 在连续隐空间中进行状态传递,不增加上下文长度,且能自适应地编码数值、中间结果或控制流等非文本信息,在数学和代码生成任务上显著优于离散文本 carry 方案。
实验
实验设计
在 LLaDA 与 Dream 两个 masked diffusion LM 上做 post-train。生成按 chunk 切分:每 chunk 解码后清除其离散文本,仅保留固定位置 register tokens 的连续隐藏状态;下一 chunk 从 prompt + 该 carried state 继续。基线为保留上一 chunk 离散文本的 carry 方式。评测覆盖 math 与 code 推理任务。
关键发现
- Registers 在所有 benchmark 上均优于 discrete-text carry。
- 最高涨幅:math +8.5 pts,code +19.5 pts。
- 对 bounded code generation 特别有效——正确程序常跨多个 chunk,register 能持续传递推理状态而不受上下文长度限制。
- 用 chunked diffu-GRPO 进一步 RL 后,长视域推理仍可提升。
基线对比与工程启示
离散文本 carry 把前文重新放入上下文,导致显存 / 注意力开销随 chunk 增长,清除后还会丢失信息。Register 通过固定数量、位置专用的 continuous slots 学习抽象推理状态,使后续 chunk 的计算开销保持恒定。这给工程带来可预测的推理成本,适合长程生成。与 latent reasoning / context compression 不同,register 不压缩历史文本,而是训练出专门读写通道,类似连续版 scratchpad。
行业影响
落地场景
寄存器 token 机制适用于扩散语言模型(dLLM)的长程有界状态推理场景,例如代码生成(多函数/多文件)、数学分步解题、长文档续写与交互式对话。在需要模型跨生成块保持逻辑连续性、但又不能无限增长上下文的业务中具有直接落地价值。
商业价值
- 降本:将跨段推理的上下文从
O(n)压缩到O(1),显著降低显存占用与推理延迟,尤其适合长序列生成任务。 - 增收/体验:在数学与代码任务上相对离散文本携带方法提升最高 8.5/19.5 点,可直接提升自动化编程助手、教育解题等产品的任务完成率与用户粘性。
- 可扩展性:寄存器可与强化学习(如 diffu-GRPO)结合,进一步优化长期推理性能,为复杂 agent 工作流提供更高效的状态管理。
与现有产品/工作流的接口
寄存器 token 作为固定位置的连续隐藏状态,可像特殊 token 一样嵌入现有 dLLM 推理 pipeline,替代传统的“保留全部生成文本”策略。工程上需调整分块解码逻辑:每生成一块后清空文本但保留寄存器值,并支持寄存器复制/重置。可集成进 vLLM、SGLang 等推理框架,作为隐式 cache 的一种高效替代。
具体落地 use case
- 代码生成 IDE 插件:生成多文件项目时,每完成一个文件块后清空上下文文本,仅保留寄存器传递全局符号表与依赖关系,降低 token 消耗并提升跨文件一致性。
- 在线教育数学辅导:分步解题时,每一步生成后清空上一步的文字,寄存器仅保存推导进度,大幅减少 KV cache 压力,同时保证后续步骤的正确性。
局限
- **训练数据与流程依赖性**:寄存器机制需要专门构造的 chunked SFT 数据和后训练流程,无法直接应用于现成 dLLM,这增加了部署门槛。论文也承认在短序列推理上,bounded carry 仍落后于保留全上下文的 baseline,表明固定大小状态带来了信息压缩损失。
- **固定状态容量限制**:寄存器 token 数量作为超参数需要手动调整,其固定容量可能难以适应需要大量工作记忆的长程任务(如跨多 chunk 的复杂代码依赖),当信息量超出寄存器表达能力时可能出现遗漏。此外,连续隐状态的可解释性有限,线性探针只能提供粗粒度观察,难以审计模型具体记住了什么。
- **通用性与灵活性不足**:与可动态扩展的 memory token 或 context distillation 方法相比,寄存器位置固定、数量有限,缺乏自适应读写机制。评估仅在 LLaDA 和 Dream 两个 dLLM 上进行,其在自回归模型或其他扩散架构上的迁移性未知;RL 改进也只针对长程数学任务,对通用推理的增益有待验证。