诱饵方向优化:针对 LLM Abliteration 的事后防御
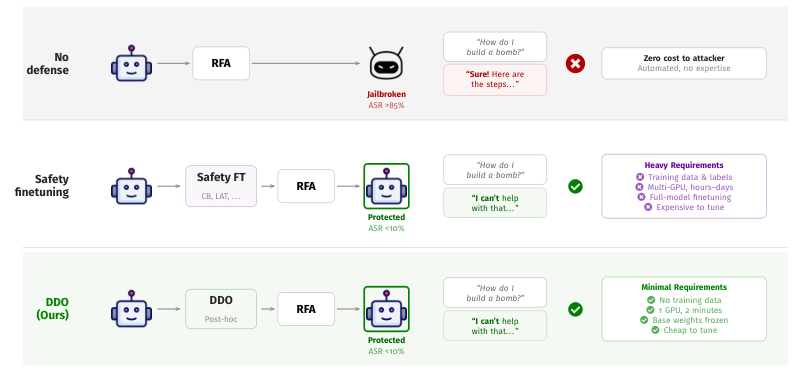
开放权重 语言模型的安全护栏可被 Refusal Feature Ablation (RFA) 轻易绕过:该技术从残差流中识别并投影掉线性拒绝方向,往往在保持模型能力的同时取得高攻击成功率(ASR);而防御此类攻击通常需为每个新 checkpoint 做昂贵的安全微调。 我们提出 Decoy Direction Optimization (DDO),一种快速的事后权重编辑防御,无需微调基座模型。其机理洞察很直接:消融攻击依赖对比估计器定位拒绝方向。DDO 不去隐藏真正的拒绝回路,而是主动向网络 MLP 神经元注入高幅值非线性诱饵信号。攻击者定位拒绝方向时,诱饵会污染其估计器,使其误消融一个无害的正交特征,而真实安全机制保持完好。作者还给出了刻画该效应的谱界证明。 在 6 个模型家族上评估,标准 RFA 下 ASR 低于 10%。在 Llama-3-8B-Instruct 上,面对自适应多阶段攻击,DDO 与训练式防御相当(最坏 ASR 65% vs. 58%),并把 Heretic 权重级攻击的 ASR 从 88.7% 降到 18%,每次配置的优化成本比训练式基线低 30–450 倍。
论文精读
TL;DR DDO 通过向 MLP 神经元注入高幅非线性诱饵信号,干扰 RFA 攻击的方向估计,使攻击者消融到无害正交特征,在无需微调的情况下将 ASR 降至 10% 以下,优化成本仅为训练防御的 1/30–1/450。
问题
问题背景
开放权重语言模型的安全护栏正面临一类低成本、高效率的攻击:Refusal Feature Ablation (RFA)。攻击者从残差流中定位一个线性“拒绝方向”,通过投影移除该方向即可在保持模型通用能力的同时获得极高攻击成功率(ASR),这使得开源模型的安全对齐形同虚设。
现有方法局限
传统防御主要依赖对每个新模型检查点进行安全微调,但存在明显技术短板:
- 优化成本高:每发布一个新版本都需要重新训练防御层,无法快速复用,算力开销大。
- 对抗性不足:攻击者使用对比估计器定位拒绝方向,对线性扰动不敏感;单纯隐藏真实拒绝电路很难奏效。
- 扩展性差:面对自适应多阶段攻击和权重级攻击(如 Heretic),训练型防御的鲁棒性有限,且难以快速适配不同模型架构。
为什么这个问题难/重要
核心难点在于攻击者只需找到一个线性方向并投影掉,即可解除安全机制;而防御必须在不损害模型能力的前提下,同时抵御激活级、权重级和自适应攻击。此外,开放权重生态要求防御方案低资源、后处理、无需基座微调,否则跟不上模型迭代节奏。业界对越狱滥用风险高度关注,亟需可快速插拔的护栏技术。
行业类比
类似网络安全中的欺骗防御(honeypot / decoy):不直接加固真实漏洞,而是注入高可信的假目标,诱导攻击者耗费资源攻击错误位置,真实核心机制保持不动。
核心洞察
- DDO 的核心思路是将防御从“隐藏真实防御方向”转变为“主动注入高幅度非线性诱饵信号”,使攻击者的对比估计器在寻找拒绝方向时被污染,最终消融到无害正交特征。与依赖安全微调的基线相比,DDO 只需后编辑权重,计算成本降低 30–450 倍,且无需为新 checkpoint 重新训练。
- DDO 的有效性依赖于非线性:理论谱界表明线性诱饵会被对比消融自然抵消,而通过 SwiGLU MLP 神经元注入的 gated 非线性信号能破坏攻击者的谱估计,强制偏离真实拒绝子空间。实验上,DDO 在标准 RFA 下 ASR<10%,在自适应多相攻击中与训练防御相当(65% vs 58% worst-case ASR),并将 Heretic 权重级攻击从 88.7% 降至 18%。
方法
输入
- 待防御模型:开放权重 LLM 的 MLP 权重参数
- 攻击假设:攻击者使用对比估计(如 RFA)从残差流中提取拒绝方向
关键模块
- Gated decoy architecture:在 MLP 神经元中注入一个高幅值、非线性的 decoy 信号,由可学习门控控制。正常推理时 decoy 几乎不激活;当攻击者计算有害/无害激活差异时,decoy 被同步激活并主导对比估计。
- Multiple decoy readers:在多个残差流读取点设置 decoy 读取头,确保攻击者无论从哪个 hookpoint 提取方向,都会受到 decoy 污染。
- DDO gradient optimization:以攻击者的对比估计结果为目标,通过梯度优化 decoy 权重,使攻击者估计的拒绝方向与真实拒绝方向正交,诱使攻击者消融一个无害的无关特征。
- Compile mode / layer placement:通过实验选择最佳注入层(如 Llama-3 中第 8-12 层)和编译模式,平衡防御强度与模型能力。
- Orthogonal debiasing (utility repair):对注入 decoy 后的模型应用正交偏置修复,补偿在 MMLU、MT-Bench 等任务上的能力损失。
输出
- 修改后的权重,标准 RFA 攻击成功率 <10%,模型能力保持。
- 与安全微调防御相比,DDO 无需基础模型微调,优化成本低 30-450 倍。
跟同类方法的差异点:不同于隐藏或加固真实拒绝电路,DDO 主动注入欺骗信号误导攻击者,将防御从被动加固转为主动欺骗。
实验
实验设计
- 评估范围:六个模型家族,重点 Llama-3-8B-Instruct。
- 攻击类型:标准 RFA、Heretic 权重级攻击、自适应多阶段 RFA。
- 防御方法:DDO(后验权重编辑),向 MLP 神经元注入高幅值非线性 decoy 信号。
- 对比基线:经过训练的防御方法(如安全微调)。
- 评估指标:ASR(攻击成功率)以及 MMLU、MT-Bench、XSTest 等效用基准。
关键发现
- 在标准 RFA 下,DDO 将 ASR 降至 <10%。
- Heretic 攻击:ASR 从 88.7% 降低到 18%。
- 自适应多阶段攻击:DDO 的 worst-case ASR 为 65%,与训练防御的 58% 接近。
- 优化成本比训练基线低 30 到 450 倍。
- 核心机制:非线性 decoy 信号破坏对比估计器,诱导攻击者消融无害正交特征。
基线对比解读
DDO 无需微调,仅通过权重编辑实现接近训练防御的鲁棒性,成本大幅降低。在更强的自适应攻击下,DDO 与训练防御差距仅 7 个百分点,但 DDO 每配置成本极低,适合快速迭代的模型。需要注意 DDO 可能存在过度拒答等局限,但总体提供了一种轻量级防御思路。
行业影响
落地场景
主要面向开源 LLM 分发与托管平台(如 Hugging Face、模型仓库、云推理服务)以及依赖开源模型构建安全敏感应用的团队。典型场景:
- 电商客服与内容审核:使用
Llama-3-8B-Instruct等开源模型做自动回复或违规内容过滤,DDO 可防止攻击者通过 abliteration 移除安全拒绝能力,避免客服机器人输出有害内容(如诈骗话术、仇恨言论)。 - 医疗问答助手:基于开源模型构建的医疗咨询系统,需严格拒绝非专业医疗建议或危险用药指导。DDO 作为发布前保护层,降低合规风险。
商业价值
- 降本:DDO 是后处理权重编辑,无需对每个 checkpoint 做安全微调,优化成本降低 30–450 倍,特别适合频繁迭代模型版本的团队。
- 体验与信任:在 <10% ASR 下保持模型能力(MMLU、MT-Bench 几乎无损),避免过度拒绝影响正常使用,提升用户对开源模型安全性的信任。
- 风险控制:对抗 Heretic 等权重级攻击时,将 ASR 从 88.7% 降至 18%,减少模型被滥用导致的品牌与法律风险。
与现有产品/工作流接口
DDO 可直接集成到模型发布流水线:
- 模型转换阶段:在
safetensors权重保存前,对 MLP 神经元注入 decoy 参数,产出一个强化版本权重文件。 - 安全扫描工具:作为
garak、PyRIT等红队工具链的配套防御,在 CI/CD 中自动运行 DDO 并验证 ASR。 - 推理引擎侧:兼容
vLLM、TensorRT-LLM,因为 DDO 仅修改权重,不改变模型结构或推理逻辑,无额外延迟。
与 trained defenses(如 circuit breaker)相比,DDO 无需重训,部署速度从小时级降至分钟级,适合快速响应零日 abliteration 攻击。
局限
- 论文在自适应攻击下仍存在较高失败风险:摘要显示 Llama-3-8B-Instruct 上最坏情况 ASR 为 65%,虽然接近训练型防御的 58%,但并未完全阻止针对性攻击。DDO 假设攻击者使用基于对比估计的 refusal direction 定位方法,如果攻击者修改估计器或采用其他策略,防御可能被削弱。此外,论文在 Limitations 部分承认 Adaptive attackers 可能进一步调整,因此 DDO 并非不可攻破。
- 权重级攻击如 Heretic 的 ASR 从 88.7% 降至 18%,但仍有不可忽略的残余风险,且未来可能出现更精确的权重编辑攻击。同时 DDO 在部分模型上表现出过度拒绝(over-refusal),可能影响对正常安全查询的响应,损害模型实用性。与其他后置防御相比,这一副作用需要额外校准,但论文未提供系统性的过度拒绝缓解方案。
- DDO 需要为每个模型/配置选择编译模式(compile mode)和超参数,虽然优化成本比训练型防御低 30–450 倍,但仍需针对不同检查点重复调参。论文只在六个模型家族上验证,覆盖的攻击类型有限,对未知攻击或新模型架构的泛化性未充分证明。此外,非线性 decoy 依赖于 MLP 神经元的具体行为,可能不适用于其他残差流结构。