信息分布在 Synergy Heads 中漂移时 MLLMs 产生幻觉
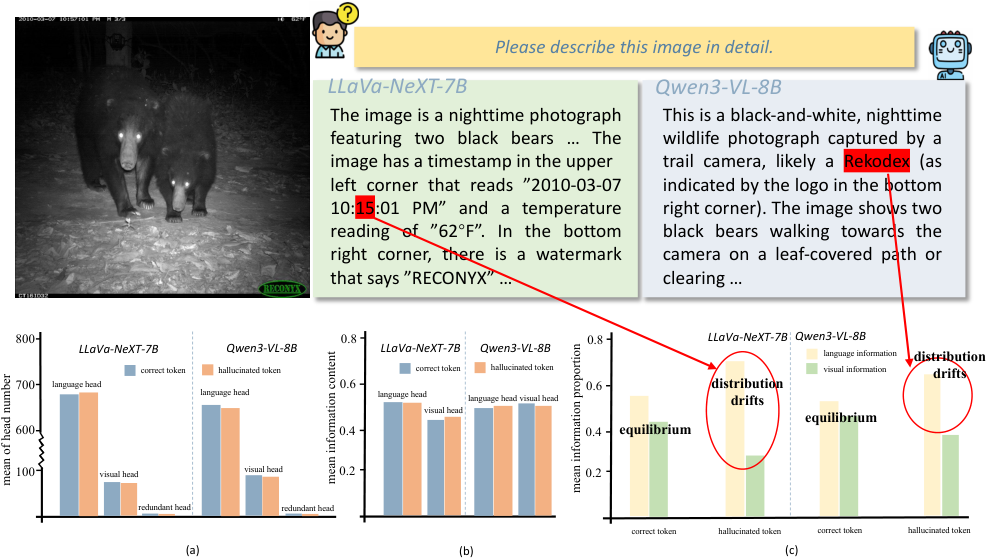
Multimodal Large Language Models (MLLMs) 常因幻觉问题而难以可靠落地。现有基于注意力的缓解方法多依赖间接信号(如注意力权重),无法准确刻画幻觉生成背后真实的信息偏移。 为此,本文提出 HEAL(Head-lEvel information disentAnglement and caLibration),用于识别并缓解幻觉。HEAL 首先对多头输出施加因果噪声干预,过滤掉因果冗余的头;随后利用反事实 Difference-in-Differences 对剩余头内部的信息分布进行解耦,把头划分为四类。 分析发现:幻觉出现在 synergy heads 中信息分布偏离健康均衡之时,而与模态特定头的数量或强度并无强相关。基于这一洞察,HEAL 向 synergy heads 的 value 向量注入动态信息校准因子,并主动调节视觉-语言依赖,使输出分布向事实证据靠拢。 大量实验表明,HEAL 能在多种 MLLMs 上有效降低幻觉,为提升模型可信度提供了一条简单且可解释的路径。
论文精读
TL;DR HEAL 通过因果干预与反事实 DiD 解耦注意力头信息,发现 MLLM 幻觉源于 synergy heads 信息分布漂移(而非模态特定头数量/强度),并动态校准 value 向量,以可解释方式降低幻觉。
问题
问题背景
MLLMs(多模态大模型)在视觉问答、图像描述等任务中表现优异,但幻觉输出严重阻碍其在高信任度场景中的落地。当前领域关注如何通过注意力层面的干预,实现无需重训练、可解释的幻觉抑制。
现有方法局限
现有基于注意力的缓解方法(如 OPERA、VCD 等)主要利用 attention weights 作为间接信号:例如抑制高注意力 token、对比不同解码路径或动态调整注意力分配。但这些方法存在明显局限:
- attention weights 本身不直接反映信息内容,一个 head 的权重高可能源于位置偏好而非语义贡献。
- 无法区分 head 类型(视觉专用、语言专用、视觉-语言协同),统一干预会破坏有用表征。
- 缺乏对幻觉生成时信息分布“如何漂移”的因果建模,导致在分布外或复杂场景下性能下降。
为什么这个问题难/重要
MLLM 的幻觉往往源于视觉-语言协同 head 中信息分布的动态失衡,而非单一模态 head 的数量或强度。要可靠识别这种漂移,需要 因果噪声干预 与 反事实双重差分 等工具拆解 head 级信息流,理论难度与计算开销都较高。同时,幻觉直接影响模型在医疗影像报告、自动驾驶感知、金融文档分析等高风险场景的可信度,业界亟需简单、可解释、跨模型泛化的校准机制。
行业类比
可以把 HEAL 比作模型内部的“信息配平系统”:类似自动驾驶中多传感器融合的实时校准,当视觉与语言证据的权重发生漂移时,主动校正协同 head 的值向量,使最终输出回到事实分布上。
核心洞察
- 幻觉产生的核心不在于注意力权重强弱或模态特定头数量,而在于 synergy heads 内部信息分布偏离健康平衡。现有注意力方法通常依赖 attention weights 等间接信号,无法捕捉实际信息分布漂移;HEAL 通过因果噪声干预筛选出 causally redundant heads 后,进一步用 counterfactual Difference-in-Differences 显式分解 head 内信息分布,发现幻觉与 synergy heads 的失衡强相关,而与非 synergy 头数量或强度无显著关联。这一发现将幻觉归因从粗粒度权重重分布推进到可操作的 head 级信息平衡,为精准干预提供了可解释依据。
- HEAL 提供了一种不修改模型参数、仅对 synergy heads 的 value vectors 注入动态信息校准因子的轻量级幻觉缓解方案。与以往不加区分地调整所有注意力头或全局重校准的 baseline 不同,HEAL 先通过因果干预和 DiD 定位到关键 synergy heads,再针对性校准视觉-语言依赖,从而把输出分布拉回事实证据。这种方法既保留了推理效率,又具备因果可解释性,且在多 MLLM 上验证有效,为实际部署中的幻觉抑制提供了工程友好的插入式路径。
方法
方法详解
HEAL 是一种针对多模态大模型(MLLM)幻觉的推理时校准方法,整体遵循 输入 → 多头注意力分析 → 动态校准 → 输出 的流程,无需重新训练模型参数。
因果噪声干预
首先对每一层中每个注意力头的输出施加噪声扰动,并观察其对最终生成 logits 的因果影响。通过比较干预前后的变化,筛选出对输出有显著因果作用的核心头,剔除大量与任务无关的冗余头,从而降低后续计算开销。反事实双重差分
在保留的核心头上,采用反事实干预与双重差分法解耦每个头内部的信息分布,将头划分为四类:视觉主导、语言主导、协同头 (synergy heads) 以及无关头。实验分析揭示:幻觉产生的真正原因不是视觉/语言特定头的数量或强度变化,而是协同头中视觉-语言信息分布偏离了健康均衡状态。动态信息校准
基于上述发现,HEAL 对协同头的 value 向量注入动态校准因子,实时调节视觉与语言信息的融合比例,将输出分布从漂移状态拉回事实证据支撑的区域。校准因子的计算与注入采用周期性、并行化与批处理实现,以保证推理速度与显存开销可控。
最终输出为经过校准的 MLLM 生成结果,在多个基准上有效降低幻觉率。
与同类方法的差异:现有注意力类方法多依赖注意力权重等间接信号,而 HEAL 直接在多头输出层面进行因果信息解耦与动态干预,粒度更细且可解释性更强。
实验
实验设计
HEAL 在多个 MLLM 上开展评估,覆盖幻觉基准与综合基准,并包含消融分析、双向因果分析与鲁棒性分析。论文摘录未列出具体数据集名称与指标数值,因此暂无法提供准确数字。
关键发现
作者指出幻觉并非主要取决于模态专用头的数量或强度,而是当协同头的信息分布偏离健康均衡时发生。HEAL 通过反事实双重差分将注意力头分为四类,并对协同头的 value vectors 注入动态信息校准因子,主动调节视觉-语言依赖,使输出分布更贴近事实证据。
与基线对比
相比仅依赖注意力权重的间接信号方法,HEAL 直接对多头输出进行因果噪声干预,过滤冗余头,并校准协同头的信息分布,提供更可解释的幻觉抑制路径。原文称其能在多个 MLLM 上有效降低幻觉,但具体提升幅度需查阅正文实验表格。
行业影响
落地场景
HEAL 作为一种推理时干预模块,可直接嵌入多模态大模型(MLLM)的推理链路,无需重新训练。典型应用包括:
- 电商商品内容生成:从商品图片自动提取属性(颜色、材质、尺寸)并生成描述,需防止属性错配;HEAL 可校准视觉-语言依赖,减少错误属性输出。
- 医疗影像报告辅助:生成放射影像发现描述时,确保视觉证据与文本一致,避免虚构病灶。
- 企业知识库问答:图文混合文档中,引用图片信息时防止编造细节。
这些场景均要求高事实一致性,HEAL 的校准机制可显著降低幻觉率。
商业价值
- 降低纠错成本:减少因幻觉导致的错误信息流入下游系统,避免人工复审和业务损失(如电商退货、错误诊断)。
- 提升用户信任与转化:更准确的商品描述和答案增强用户体验,支撑 MLLM 在更高价值业务中落地。
- 快速部署收益:HEAL 不改变骨干网络,仅介入多头注意力的 value vectors,推理开销小,可快速集成到现有模型服务,加速可信 AI 产品上线。
与现有工作流的接口
HEAL 可作为 模型中间件 集成到标准推理框架(如 vLLM、TensorRT-LLM)中:
- 在多头注意力计算后,对 synergy heads 的 value vectors 动态注入校准因子,逻辑上可封装为一个自定义
attention hook或轻量插件。 - 与现有幻觉缓解方法(如基于 attention weights 的惩罚)相比,HEAL 直接操作信息分布,更贴近幻觉成因,且与模型无关,可跨多个 MLLM 复用。
- 部署时,只需预先估计健康均衡参数,推理阶段为确定性校准,适合批处理和实时服务。
局限
- 方法依赖因果噪声干预和 counterfactual Difference-in-Differences 对注意力头进行分类,虽然作者声称采用 periodic / parallelized / batched 实现降低开销,但该方法依然需要额外的干预计算与头级信息统计,可能显著增加推理延迟与显存占用。论文中虽报告了推理时间对比,但缺乏在不同 batch size / 序列长度下的可扩展性验证,实际部署时可能面临工程挑战。
- 论文观察到幻觉与 synergy heads 的信息分布漂移相关,但所提出的动态信息校准因子依赖于预设的 equilibrium factor 和 update interval,这些超参数需要针对不同 MLLM 和任务进行调整,缺乏自适应机制。当视觉-语言分布发生较大偏移或跨域时,固定均衡因子可能失效,导致校准不足或过度校准,影响模型的通用性。
- 实验主要覆盖已有 hallucination benchmarks 和 comprehensive benchmarks,但未充分验证对生成多样性、推理能力等非幻觉指标的影响,也未在更多样化的 MLLM 架构(如非 transformer 或不同注意力变体)上测试。与一些更轻量的 attention 调整方法(如 OPERA、VCD)相比,HEAL 增加了因果分析和头分类的复杂度,可能限制其在资源受限场景的采用。