OracleZoom: 受 On-Policy 自蒸馏启发的参考约束递归图像超分辨率
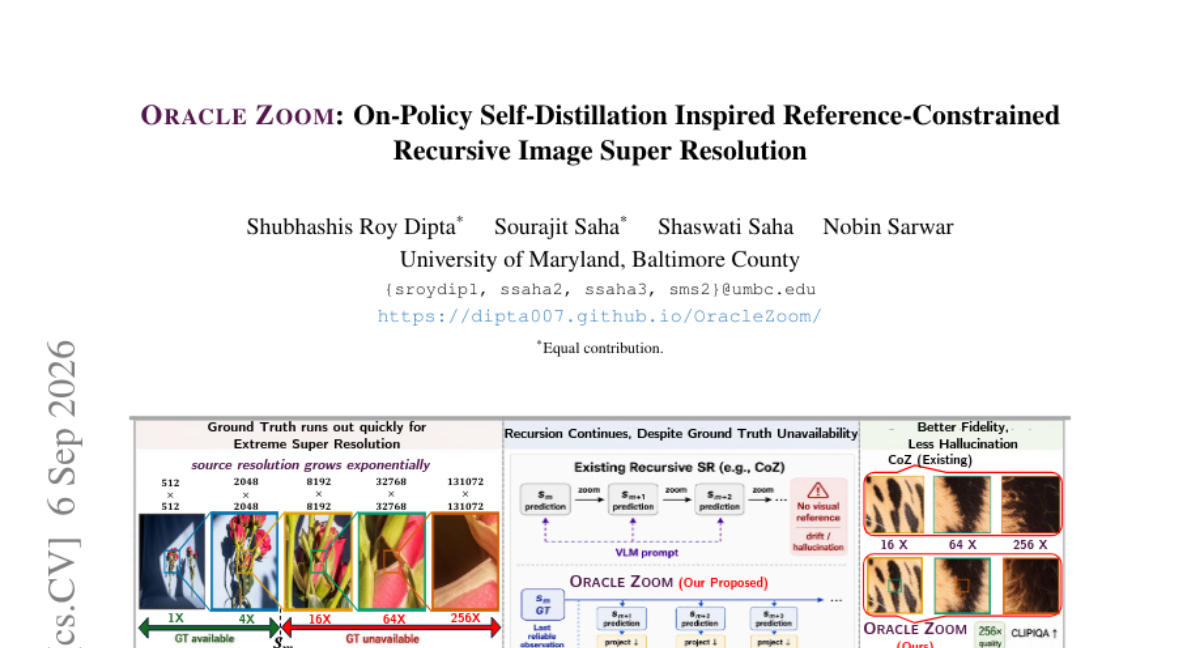
递归超分辨率 (Recursive SR) 通过反复将预测结果反馈回同一模型,把固定尺度 SR 扩展到极端放大倍数,类似于对图像进行连续缩放。然而,在每个尺度(尤其是深层尺度)获取 ground truth 依然十分困难:所需的源分辨率呈几何级增长,导致更深的预测处于无监督状态。 我们提出 OracleZoom,一个受 on-policy 蒸馏启发、参考约束的框架,它在自身轨迹上训练,并将最后的 ground truth 证据带到监督边界之外。直接监督与跨尺度监督 约束可验证内容,而无参考质量目标 引导尚未解析的细粒度细节。KL 约束的预训练 latent prior 限制质量驱动带来的漂移,EMA 一致性则用于稳定监督边界。 在七个数据集上,OracleZoom 在各级缩放尺度上均达到 state-of-the-art 的 SR 质量,平均 0.713 CLIPIQA,并在更深尺度上取得更大提升,同时显著减少幻觉。代码、数据与模型见 https://dipta007.github.io/OracleZoom/ 。
论文精读
TL;DR OracleZoom 让递归超分模型在自生成轨迹上训练,用最后可用的真值做跨尺度约束,并结合潜在先验抑制幻觉,在极端放大倍数下平均 CLIPIQA 达 0.713,取得 SOTA。
核心洞察
- OracleZoom 将递归超分辨率视为 on-policy self-distillation 过程,在训练轨迹上利用自身预测,并以最后可用的 ground truth 作为参考约束,从而将监督扩展到几何级增长的深层尺度。传统递归 SR 通常只在固定尺度上训练,深层预测完全无监督或依赖简单伪标签;OracleZoom 区分可验证内容(由直接和跨尺度监督约束)与不可验证细节(由无参考质量目标引导),实现了对递归轨迹的精细控制。这种设计不仅减少了深层幻觉,还让深层输出保持与浅层一致的保真度,对需要极端放大的实际应用(如卫星影像、医学显微图像)有直接工程价值。
- 引入 KL-constrained pretrained latent prior 与 EMA 一致性,形成双重正则化来约束递归生成中的潜在漂移。无参考质量目标虽然能引导生成逼真细节,但容易让模型偏离真实分布或产生不稳定输出;OracleZoom 通过将生成限制在预训练潜空间内(KL 约束)并平滑监督边界(EMA),在追求感知质量的同时保持训练稳定性。与仅靠对抗损失或感知损失的递归 SR 相比,该机制提供了更可控的深层生成,避免了误差累积导致的退化,这是递归超分辨率领域一个被长期忽视的工程难题。
方法
输入与递归框架
接收低分辨率图像,送入同一个递归 SR 模型,每次迭代输出更高分辨率版本,并将预测反馈回模型形成缩放轨迹。训练时,OracleZoom 在自身生成的轨迹上进行 on-policy self-distillation,即把模型每一步的预测作为下一步的输入,同时保留最后可用的真实高分辨率图像作为参考基准。
关键训练模块
- 直接与跨尺度监督:在监督边界内,将预测与对应尺度的 GT 做像素级损失;边界之外,利用最后一张 GT 通过下采样/投影生成伪参考,实现跨尺度约束,确保深层内容仍与真实证据一致。
- 无参考质量目标:对无 GT 的深层输出,采用无参考质量评估模型(如 CLIPIQA)提供奖励信号,引导模型生成更逼真的高频细节。
- KL 约束的潜在先验:将生成过程与预训练潜在空间对齐,用 KL 散度限制质量驱动的分布漂移,避免为追求质量分数而产生幻觉纹理。
- EMA 一致性:对模型参数做指数滑动平均,稳定监督边界处的梯度,减少训练震荡。
输出与差异
最终输出为极端放大倍率下的超分辨率图像。相比现有递归 SR 方法仅在监督边界内训练或依赖对抗损失,OracleZoom 通过携带最后 GT 证据跨越边界,并结合潜在先验与 EMA 约束,在深层尺度显著降低幻觉,提升 CLIPIQA 分数。
实验
实验设计
OracleZoom 在 7 个数据集 上评估,以 CLIPIQA 作为核心无参考质量指标,并在不同递归深度(zoom 级别)下与现有递归 SR、扩散先验 SR 等方法比较。训练采用 on-policy 轨迹,利用最后可用 GT 作为监督边界之外的参考。评估重点关注:
- 跨尺度保真度(有 GT 时)
- 超过 GT 边界后的无参考质量
- 幻觉减少程度
关键发现
- 平均 CLIPIQA 达到 0.713,达到 SOTA。
- 在更深的递归尺度上增益更大,表明当真实监督消失时,参考约束与潜在先验仍能维持质量。
- 显著减少幻觉——这与无约束生成式 SR 形成对比。
与基线对比解读
与固定尺度 SR 和近期扩散先验方法相比,OracleZoom 的优势在于 on-policy self-distillation 和 reference-constrained 机制:
- 基线通常在超出训练分布后质量快速下降或产生纹理幻觉;
- OracleZoom 的 KL 约束潜在先验限制质量驱动的漂移,EMA 一致性稳定监督边界,使深度放大仍可信;
- 这一设计对工程实践启示:在极端放大场景下,保留最后 GT 证据并约束潜在空间,比单纯增大模型或扩散步数更有效。
行业影响
落地场景
OracleZoom 适合需要极端放大倍率且对细节真实性要求高的场景。例如:
- 电商平台:商品图片通常为低分辨率上传,用户缩放查看细节(如面料纹理、标签)时,传统超分易产生虚假纹理。OracleZoom 在递归放大中保持参考约束,减少幻觉,提升用户信任与购买转化。
- 医学影像:病理切片或放射影像局部放大需忠实于原始结构,其跨尺度监督与潜在先验可抑制伪影,辅助诊断。
- 内容平台:UGC 图片/视频的交互式多级缩放查看,可提供清晰且无伪影的增强体验。
商业价值
主要作用于体验提升与降本:
- 减少人工修复/重拍成本:低分辨率素材无需重新获取高分辨率源,即可获得高质量放大结果。
- 提升用户交互体验:图像缩放功能提供更清晰、真实的细节,降低跳出率,提高电商转化或内容消费时长。
- 可靠性增强:减少幻觉意味着减少误导性细节,在医疗、法务等场景降低风险成本。
与现有工作流的接口
OracleZoom 是无参考质量引导的递归超分模型,可作为独立推理服务或预处理模块集成:
- 推理阶段无需额外监督,可封装为 REST/gRPC API,供前端或后端调用。
- 可替换现有超分模块(如 Real-ESRGAN、SwinIR)在图像处理流水线中的位置,特别适用于需要多级缩放的交互式场景。
- 其 KL 约束潜在先验可与扩散先验结合,或作为正则项加入其他生成式 SR 模型,提升深度递归稳定性。
- 训练代码与模型已开源(项目主页),便于快速验证。
具体 use case:
- 电商 App 商品详情页:用户双指缩放查看商品细节时,前端调用 OracleZoom 服务,每次缩放请求触发递归超分,返回更清晰且无伪影的图像。
- 在线教育平台的板书/文档图片:教师上传低分辨率截图,学生放大查看公式或图表,OracleZoom 提供高保真放大,避免传统插值模糊。
局限
- **对无参考质量模型的依赖与潜在偏差**:方法使用 CLIPIQA 等无参考质量目标引导深层细节生成,但这类模型自身存在感知偏差,与人类主观评价的一致性有限。尽管 KL 约束限制了偏离潜在先验的程度,本质上仍是优化代理指标,无法保证生成结构与真实高频细节一致。在超出监督边界后,生成内容可能更符合质量模型偏好而非真实物理约束,导致在特定噪声或纹理分布上的过拟合。
- **跨尺度监督的固有局限**:跨尺度监督只能约束可验证内容,对于深层递归中需要凭空生成的高频细节,仍缺乏直接监督信号。虽然使用最后一个真值作为参考,但参考图像与目标超分结果之间存在尺度差异,跨尺度对齐可能丢失高频信息。此外,在极深递归时误差可能累积,EMA 一致性仅稳定边界,无法完全阻止深度误差传播。
- **训练与推理的计算开销**:方法需要维护 EMA 教师模型、预训练潜在先验,且在训练过程中递归生成轨迹,显著增加训练计算和内存需求。推理时递归多次前向传播也带来延迟,可能不适合实时应用。论文未与同类方法进行系统的效率对比,实际部署时可能受限。