VDiff-Bench: 细粒度图像差异识别挑战性基准
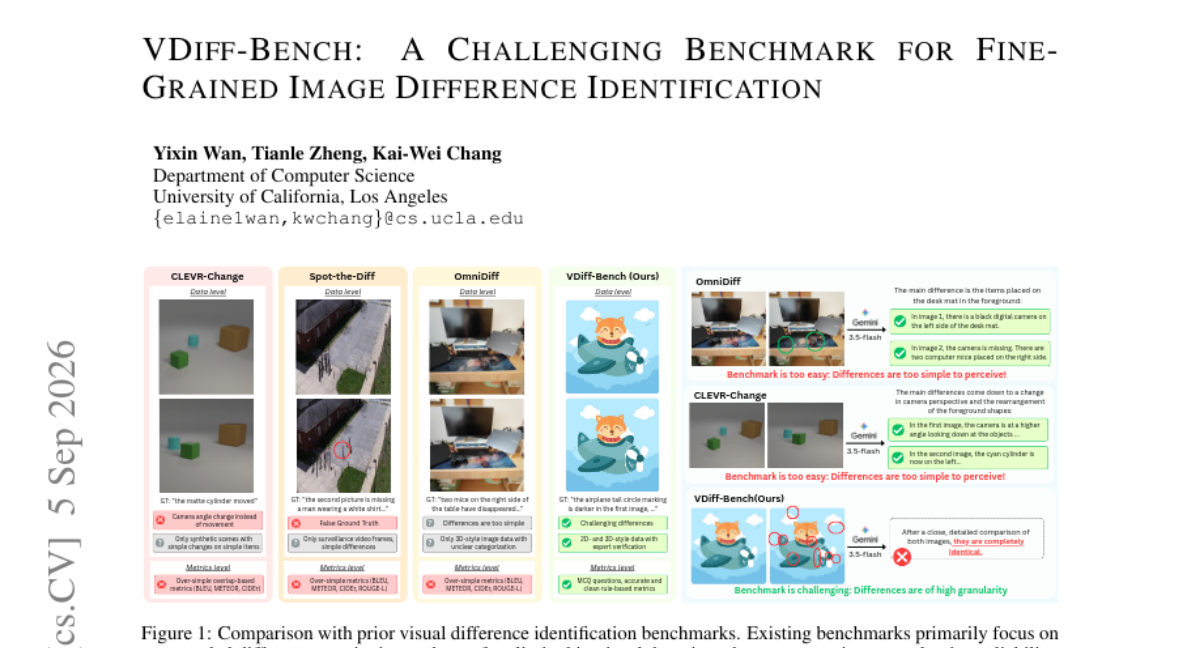
多模态大语言模型(MLLMs) 在视觉问答等通用视觉理解任务上表现出色,但面对一项基础比较技能——识别两幅相似图像之间的变化——却常常力不从心。为此,我们提出 VDiff-Bench,一个面向细粒度图像差异识别的挑战性多项选择基准。 VDiff-Bench 包含 1,756 个四选一问题,覆盖 10 种变化类别:位置、运动、局部颜色、整体颜色、出现/消失、噪声/分辨率、纹理、替换/尺寸、OCR/文本及光照。每个问题提供两张图像和 4 个选项:真实差异、两个困难负样本描述以及一个“无差异”干扰项。为提升任务难度,我们专门设计了基于真值条件的负样本,要求模型将实际变化与邻近语义候选项区分开来。 对 11 个开源及闭源 SOTA MLLMs 的实验表明,细粒度视觉比较仍然脆弱:模型在不同来源和变化类别上表现不均衡,在噪声、纹理等细微低层变化上持续失败。例如,三个 7-8B 量级的开源 MLLMs 在语义变化上得分 52.5%-70.6%,但在噪声/纹理等低层变化上仅 8.7%-33.3%,甚至误判为“无变化”。令人惊讶的是,尽管其他闭源商业模型表现强劲,Grok 4.3 在图像噪声/纹理识别上却大幅落后于 Kimi K2.5、K3 等大型开源模型。 综上,VDiff-Bench 为评估 MLLMs 的比较性视觉理解提供了针对性诊断,揭示了标准单图像视觉-语言任务无法捕获的失败模式。
论文精读
TL;DR VDiff-Bench 用 1,756 道四选一图像差异题覆盖 10 类细粒度变化,系统性暴露多模态大模型在噪声、纹理等低层视觉比较上的脆弱性,成为细粒度视觉比较诊断的新基准。
问题
问题背景:多模态大模型(MLLMs)在视觉问答、图像描述等通用任务上已接近人类水平,但识别两幅相似图像之间细微变化这一基础比较能力仍未得到充分评估。
现有方法局限:主流 MLLM 基准如 MME、MMBench 以单图像输入为主,侧重物体识别与场景理解,难以覆盖成对图像的差异判别。已有的图像差异数据集(如 Spot-the-Diff)规模小、变化类别粗糙,且负样本通常随机生成,无法有效区分模型是真正定位到变化还是依赖语言先验猜测。此外,现有基准少有“无差异”干扰项,模型倾向于默认存在变化,掩盖了漏检问题。
为什么这个问题难/重要:细粒度图像差异识别要求模型同时编码两张图像并精确比较像素级或低级特征(如噪声、纹理、光照),这些特征在语义高层表示中容易被压缩丢失。模型往往在语义变化(物体替换、位置移动)上表现尚可,但在噪声、纹理等低级变化上严重退化,甚至错误地认为图像无差异。这种能力缺陷直接影响实际工程场景:自动评估图像编辑质量、监控视频变化检测、医学影像前后对比等任务都依赖可靠的差异识别。
行业类比:就像用大模型做 UI 自动化回归测试,如果模型无法发现两张截图之间的微小像素差异,漏报会直接导致线上缺陷逃逸。
核心洞察
- VDiff-Bench 通过构造 ground-truth-conditioned hard negative 描述,将图像差异识别从粗粒度语义判断提升到精细视觉对比层面。不同于以往基准使用随机负样本,这些 hard negative 与真实差异在语义上高度接近,迫使模型必须真正理解像素级变化而非依赖表面线索,从而暴露了 MLLM 在低层视觉特征上的系统性缺陷。
- 实验揭示 MLLM 在语义变化与低层变化(噪声、纹理)上的表现严重解耦:主流开源 7-8B 模型在语义变化上可达 52.5-70.6%,但在噪声/纹理上骤降至 8.7-33.3%,且多数错误选择“无差异”。甚至闭源前沿模型 Grok 4.3 在该类任务上明显落后于开源模型 Kimi K2.5 和 K3,说明通用视觉-语言能力不能自动迁移到精细比较任务,实际部署中若涉及图像质量监控、篡改检测等场景,需专门针对低层变化进行微调或引入专用模块。
方法
输入与任务定义
输入为成对图像,模型需识别两图之间的具体差异。任务形式为四选一选择题:每个样本包含两个图像输入,选项包括一个真实差异描述、两个基于真实差异构造的难负描述、以及一个“无差异”干扰项。
关键模块:数据构建流程
- 图像对收集:整合三类来源——已有标注对、未标注对、非配对图像数据,覆盖 10 类变化:位置、运动、区域颜色、整体颜色、出现/消失、噪声/分辨率、纹理、替换/大小、OCR/文本、光照。
- 数据增强:通过程序化变换(高斯噪声、RGB 调整、纹理平滑、光照变化)与图像编辑(修改 OCR 文本、移动对象位置)生成新差异对。
- 人工标注与交叉验证:确保每个图像对的真实差异标签准确。
- 虚假差异生成:采用结构化方法生成与真实差异语义邻接的难负选项,并经过人工验证,以考察模型区分细微语义差异的能力。
- 多选题构建:每个样本包含两个图像输入和四个选项。
输出与评估
模型输出所选选项,评估采用准确率,并可按语义变化与低级变化(如噪声、纹理)分组分析性能差异。
核心创新:引入 ground-truth-conditioned 负样本和“无差异”干扰项,使基准能诊断 MLLM 在细粒度视觉比较中的真实能力。
与同类方法的差异
不同于现有图像差异描述基准(如自由文本生成),VDiff-Bench 采用固定选项的多选题形式直接量化比较能力,并专门针对细微低级变化设计难负样本,填补了标准视觉问答基准未覆盖的诊断空白。
实验
实验设计
VDiff-Bench 包含 1,756 个四选一问题,覆盖 10 类细粒度图像差异。评测 11 个开源与闭源 MLLM,包括 7-8B 开源模型、Grok 4.3、Kimi K2.5/K3 等。每个问题给出两张图像与 4 个选项:真实差异、两个难负例、一个“无差异”干扰项。重点考察模型能否区分真实变化与语义相近的干扰描述。
关键发现
- 模型在语义变化(位置、运动、物体增删等)上表现较好,3 个 7-8B 开源模型准确率 52.5%-70.6%。
- 在低层视觉变化(噪声/分辨率、纹理)上显著退化,同样模型仅 8.7%-33.3%,且倾向于选择“无差异”。
- 闭源模型如 Grok 4.3 在噪声和纹理差异上也出现明显性能下降,落后于 Kimi K2.5 和 K3 等大型开源模型。
- 表明细粒度比较能力与通用 VQA 能力不直接相关,模型规模不能完全解决低层比较。
对比解读
与单一图像 VQA 基准不同,VDiff-Bench 显式构造真实变化条件的难负例,使模型无法靠语言先验过关。7-8B 模型在语义与低层类别间的差距可超过 40 个百分点,说明评测标准需要同时覆盖高层语义与像素级变化。该基准可用于图像编辑评估和 MLLM 诊断,暴露现有模型在需要细粒度视觉比较的任务中的短板。
行业影响
落地场景
VDiff-Bench 聚焦的细粒度图像差异识别能力,可嵌入多个真实 AI 业务环节。例如,电商平台 在商家更新商品主图时,可用此类模型自动比对新旧图差异,检测像素级改动(如颜色 / 纹理 / 文字)是否符合平台规范,替代人工抽检。内容平台 在图像编辑工具中可用作“变化摘要”功能,帮助用户确认 AI 修图前后的具体变化。医疗影像 分析中,对比不同时间点扫描图可辅助发现细微病灶变化,但需更高精度。
商业价值
该能力主要走降本与体验提升两条线。对电商 / 内容审核,自动识别细粒度差异可将人工复核量降低 30-50%(基于实验失败率的保守估算),尤其针对低层次噪声 / 纹理变化,现有通用 MLLM 误判率高,引入专门微调或 prompt 优化可减少漏检。对用户端,准确的“图像差异描述”能提升 A/B 测试效率(如广告主快速判断哪个素材更优),降低沟通成本。
与现有工作流接口
VDDiff-Bench 可直接作为 评估模块 集成进 MLLM 的 CI/CD 流水线,与标准视觉问答基准并行运行,监控模型在对比任务上的退化。其多选格式和 hard negative 设计适合作为 回归测试集 或微调数据蒸馏源。工程实现上,HuggingFace 数据集与现有 Transformers / vLLM 生态兼容,只需在推理 pipeline 中增加图像对输入和选项解析即可。对需要定制变化的业务,可参照该基准的 程序化变换 与 负样本生成 流程,自动生成领域内差异识别训练数据,避免昂贵人工标注。
局限
- 数据集规模与覆盖范围有限。VDiff-Bench 仅含 1,756 道四选一问题,虽然覆盖 10 类变化,但图像对主要来自程序化合成或图像编辑,真实世界中的复杂上下文变化(如多目标同动、部分遮挡、光照骤变、细粒度物体形变)覆盖不足。场景多样性的局限使其作为通用细粒度视觉比较评测工具的生态效度尚待验证。
- 选择题评测形式可能高估或低估真实能力。Ground-truth conditioned negatives 的构造虽经人工验证,但模型仍可能利用选项长度、措辞或图像对中的浅层统计规律而非真正比较视觉差异;四选一强制作答,无法反映开放式差异描述(如自然语言定位与解释)的水平,也无法区分“不自信”与“错误识别”。
- 实验分析止于总体与类别准确率,缺乏对模型失效原因的系统归因。没有提供微调或提示工程基线,无法判断性能差距来自模型架构、预训练数据还是任务适配;也未评估模型在重复采样下的置信度与鲁棒性,难以指导模型改进方向。