面向长时长多镜头视频生成的 Multi-Grid Post-Training
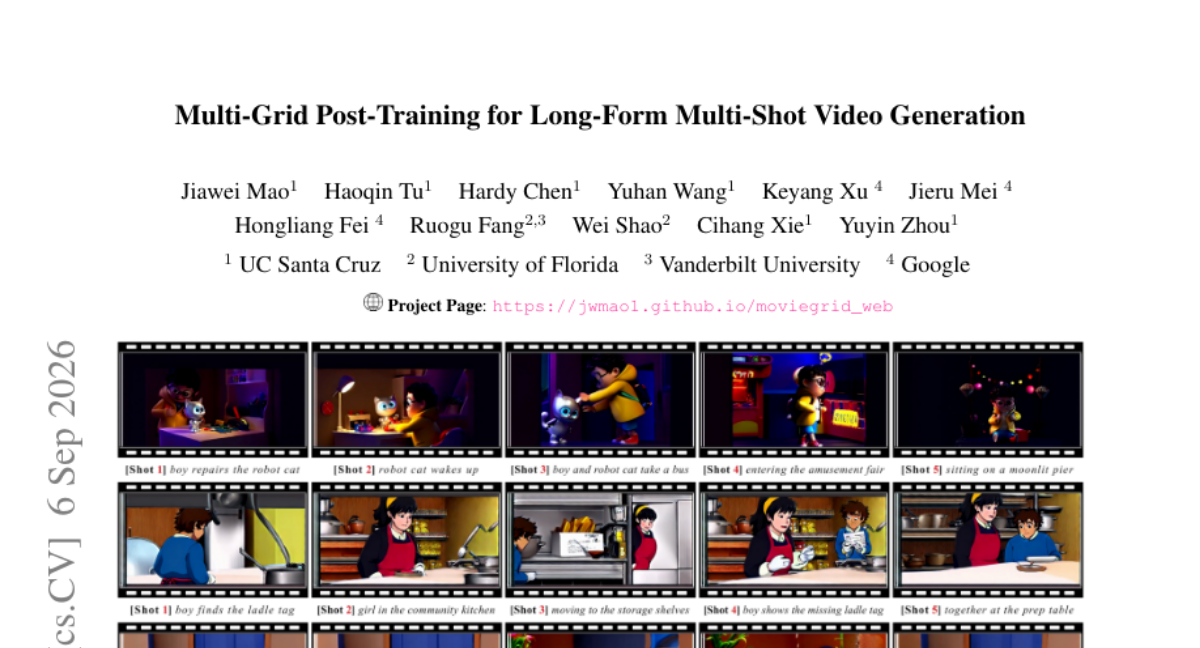
生成长时长多镜头视频,既需要镜头内连贯的运动,也需要跨镜头视觉一致的叙事。现有视频生成器偏好连续运动,当完整叙事被压缩到单一时间轴上时,难以呈现完整的镜头集合。 为此,我们提出 MovieGrid,一种 Multi-Grid Post-Training 范式:把长视频拆解为若干按时间排序的短 chunk,并在空间网格上排布以联合建模,从而减少每条时间轴承载的镜头数,同时实现跨 chunk 的全局信息交互。我们从 1,000 个长视频出发构建 MGLV(Multi-Grid Long Video)数据集,经源视频收集、层次化分割、网格视频构建与角色感知故事标注,得到 54K 个网格视频及其故事提示词。 训练侧,Noise-Free Random-Grid Training 保留随机子集 chunk 作为干净的视觉上下文,用于对其余 chunk 去噪;Grid Embedding 编码网格结构,角色感知 Story Prompts 串联反复出现的实体,Grid Boundary Loss 稳定版式布局。 在相同 token 预算下,MovieGrid 于 1,616 帧视频中生成的镜头数达 Temporal Packing 的 6.05 倍;在覆盖五个真实类别的基准上,取得最优的镜头内一致性(0.9131,HoloCine 为 0.8086)与镜头间一致性(0.5914,StoryMem 为 0.5384)。此外,它可通过单次或多次生成进一步扩展视频长度,且性能损失极小。
论文精读
TL;DR MovieGrid 把长视频切成短片段、排布在空间网格上联合训练,突破单时间轴生成多镜头视频的连续性瓶颈,相同预算下镜头数提升 6 倍,长视频一致性与可扩展性显著增强。
问题
问题背景
长视频生成正从单镜头连续运动建模转向多镜头叙事一致性,要求在同一段视频中呈现多个有序镜头,且镜头内部动作连贯、镜头之间视觉与语义保持连贯。
现有方法局限
主流视频扩散模型以连续时间轴为默认结构,将整个多镜头故事按顺序堆叠在单一 temporal axis 上——即 Temporal Packing。这种设计带来两个直接瓶颈:
- 模型训练与推理时,单一时间轴需要同时处理过多镜头切换,注意力机制倾向于保留全局连续运动而非各镜头的独立完整性;
- 由于所有镜头共享同一条时间轴,早期镜头的视觉风格或角色出现偏差时,误差会沿时间轴累积,导致后续镜头难以维持跨镜头一致性。
为什么这个问题难/重要
技术难点在于:镜头内运动要求局部时间连续性,而跨镜头叙事要求全局信息交换,单一时间轴天然无法同时优化这两个目标。业界对长视频生成的需求正从"能生成更长的帧序列"转向"能生成可编辑、可扩展的多镜头内容",这直接关系到视频生成模型能否进入电影前期预览、广告分镜脚本、虚拟制片等实际生产流程。
行业类比
类似多机位视频剪辑:每个机位独立拍摄保证动作清晰,但后期需要通过时间码和场记统一风格与叙事,否则成片会出现跳轴、穿帮或角色外观漂移。
核心洞察
- 将长视频的多镜头序列编码为空间网格,使每个时间轴仅需建模少数镜头,从根本上缓解了长序列生成中的运动退化与镜头丢失。与 Temporal Packing 将整个叙事压缩在单一时间轴不同,MovieGrid 让不同镜头在空间维度并行处理,降低每个时间步的复杂度,从而在保持局部连续运动的同时,实现全局信息交换。
- Noise-Free Random-Grid Training 以随机保留的干净视频块作为条件,引导剩余块的去噪过程,无需额外记忆模块即可实现跨镜头一致性。相比于 StoryMem 等依赖外部记忆的方法,该训练策略将空间网格结构直接融入生成过程,使模型学会从部分观测推理整体,类似于结构化视频 inpainting,推理时无额外存储开销,且能自然地扩展到超长视频。
方法
输入与整体流程
MovieGrid 的输入包括 故事提示(character-aware story prompt)、网格结构编码(Grid Embedding)以及可选的已生成干净块作为条件上下文。训练时从 MGLV 数据集 中采样网格视频,每个网格由多个时间有序的视频块按空间排列构成;推理时则从纯噪声或部分填充的网格开始,通过单次或多次生成逐步扩展视频长度。
关键模块
- Grid Embedding:将网格的行列位置、块尺寸等空间信息编码为可学习的嵌入,使去噪网络明确感知各块在全局布局中的位置关系。
- Noise-Free Random-Grid Training:训练时随机保留一部分视频块不加噪声,作为 干净视觉上下文,仅对剩余块加噪去噪。该策略让模型学会基于已有块内容生成其他块,从而实现跨块的条件生成与一致性。
- Character-Aware Story Prompt:故事文本中显式标注重复出现的角色实体,通过文本编码器注入模型,强化角色身份、外观在多个镜头间的保持。
- Grid Boundary Loss:在网格块边界区域施加额外约束,抑制拼接痕迹与错位,使最终拼接视频过渡自然。
输出与差异
输出为完整的多镜头长视频,由网格中所有去噪后的视频块按空间排列拼接而成;若需更长视频,可将其作为新网格的干净上下文进行多轮生成。相比将整个叙事沿单一时间轴压缩的 Temporal Packing 或独立生成后拼接的方法,MovieGrid 通过空间网格联合建模,同时缓解了单轴连续运动偏差与跨镜头一致性不足的问题。
实验
实验设计与设置
- MGLV 数据集 从 1,000 个长视频构建,经 Hierarchical Video Segmentation、Grid Video Construction、Character-Aware Story Annotation 得到 54K 个网格视频及其故事提示。
- 基线包括 Temporal Packing、HoloCine、StoryMem,评估指标为 intra-shot consistency、inter-shot consistency 与生成镜头数。
- 算力信息未在论文摘要中披露。
关键发现
- MovieGrid 在 1,616 帧视频中产生的镜头数比 Temporal Packing 多 6.05 倍。
- 在五类真实场景基准上,intra-shot consistency 达到 0.9131(对比 HoloCine 的 0.8086),inter-shot consistency 达到 0.5914(对比 StoryMem 的 0.5384),均为最优。
- 通过单次或多次生成,可扩展视频长度且质量损失极小。
基线与差异解读
Temporal Packing 将整个多镜头叙事沿单一时间轴排布,强化了模型对连续运动的偏好,难以呈现完整镜头集。MovieGrid 将长视频分解为短 chunk 并排布在空间网格上,每个时间轴处理更少镜头,同时通过网格内全局信息交换维持跨镜头一致性。
Noise-Free Random-Grid Training 保留随机 chunk 作为干净视觉上下文,指导其余 chunk 去噪;Grid Embedding 编码网格结构;Grid Boundary Loss 稳定布局。这些组件共同带来镜头数量与一致性的双重提升。
行业影响
落地场景
MovieGrid 可直接应用于长视频生成相关产品,尤其适合多镜头叙事场景。典型 use case:
- 内容平台自动短剧生成:输入一段故事 prompt,自动输出包含多个连续镜头的短视频,每个镜头内动作连续、镜头间角色与场景保持一致,可用于批量生产互动叙事内容或广告创意。
- 电商产品演示:生成从不同角度、不同使用步骤展示同一商品的多镜头视频,替换传统多段拍摄与后期拼接。
- 教育动画分步讲解:把复杂流程拆成多个镜头,在一个视频里顺序呈现,保持视觉元素一致。
商业价值
主要价值在降本与体验提升:
- 降本:传统多镜头视频需人工写分镜、拍摄、剪辑;MovieGrid 在后训练阶段让模型自动学会在网格上生成多镜头,减少人工环节。论文显示在相同 token 预算下,1,616 帧视频中生成镜头数是 Temporal Packing 的 6.05 倍,大幅提升单位计算量的产出。
- 体验提升:intra-shot consistency 从 HoloCine 的 0.8086 提升到 0.9131,inter-shot consistency 从 StoryMem 的 0.5384 提升到 0.5914,直接改善用户对连贯叙事的感知。
与现有产品/工作流的接口
MovieGrid 是一种 post-training 范式,不需要从零训练,可作为现有视频 diffusion 模型的微调插件:
- 在已有 text-to-video 模型基础上,加载 Grid Embedding 与 Noise-Free Random-Grid Training 权重,即可生成网格结构视频。
- 可将模型封装为 API 或 ComfyUI 自定义节点,输入中传入 character-aware Story Prompt 来控制跨镜头实体一致性。
- MGLV 数据集(54K grid videos)可直接用于企业内部二次微调,适配特定内容风格。
- 与 Temporal Packing 方案相比,网格布局更适合并行推理与显存优化,易于接入现有 batch 生成框架。项目代码见 GitHub,可作为集成起点。
局限
- **数据规模与多样性受限**:MGLV 数据集仅基于 1,000 个源视频构建,虽然通过分割和重组得到 54K 网格视频,但原始素材的数量和题材有限,可能无法充分覆盖真实世界中长视频的多样叙事结构和视觉风格。模型在开放场景下的泛化能力未经检验,训练数据偏置可能导致生成内容模式化,尤其是在角色外观、场景切换节奏等方面与真实电影叙事仍有差距。
- **网格结构引入额外工程复杂度**:将长视频空间化为网格需要精心设计 Grid Embedding、Grid Boundary Loss 等组件来维持空间布局和时间顺序,相比 Temporal Packing 显著增加了训练和推理的工程成本。同时,网格尺寸(如 2×2、3×3 等)成为关键超参数,不同尺寸可能需要重新训练或微调,灵活性受限。此外,数据集构建流程(收集、分层分割、网格构建、角色标注)涉及多个步骤,自动化程度和标注一致性有待提升。
- **跨生成扩展的一致性未充分验证**:论文声称可以通过单次或多次生成扩展视频长度,但多次生成时如何在不同批次的网格之间保持角色外观、故事逻辑和风格一致,缺乏定量评估。文中主要报告单次生成下的 intra-shot 和 inter-shot 指标,对于多次生成拼接而成的超长视频,其连贯性可能显著下降。此外,Noise-Free Random-Grid Training 在推理时依赖部分已知 chunk 作为条件,纯无条件生成长视频的能力尚不明确。